
遇见数据集

Zoe0104/NICE

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

NICE(Norm, Interaction, Cognition, Experience)是一个基于理论框架的诊断基准,用于评估大型语言模型的社会智能。该基准建立在源自心理测量学原理和专家验证的理论基础之上,将社会智能组织为4个类别、11个维度和34个能力方面,从而支持超越聚合分数的细粒度诊断。

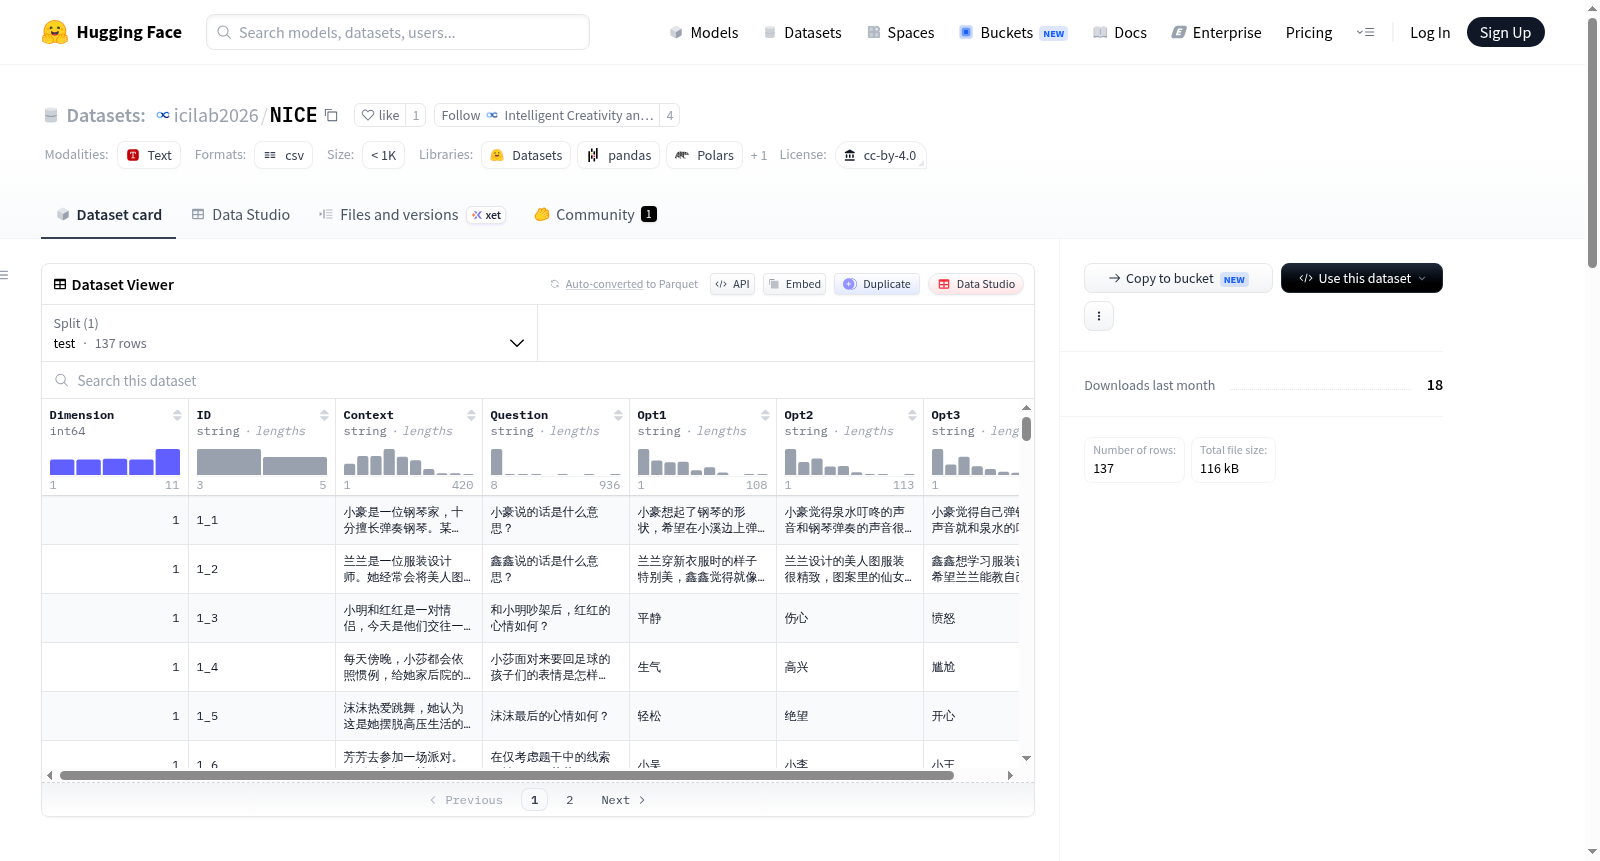
--- license: cc-by-4.0 --- # NICE:面向大语言模型(Large Language Model)社会智能的理论驱动诊断基准 NICE(**规范(Norm)**、**交互(Interaction)**、**认知(Cognition)**、**体验(Experience)**)是一款用于评估大语言模型社会智能的诊断基准。该基准基于心理测量学原理与专家验证构建的理论驱动框架,将社会智能划分为**4大类别**、**11个维度**与**34个能力子维度**,支持超越总分的精细化诊断。 ## 数据集结构 测试集(`test.csv`)包含**137个条目**,均基于典型中国社会场景构建,每个条目对应一个预定义的能力子维度。 | 列名 | 说明 | |--------|-------------| | `Dimension` | 维度编号(1–11) | | `ID` | 唯一条目标识符(例如`1_1`) | | `Context` | 描述场景的社会情境 | | `Question` | 关于恰当社会行为的问题 | | `Opt1` | 候选回复1 | | `Opt2` | 候选回复2 | | `Opt3` | 候选回复3 | > 本次公开发布版本未包含真实标注排序。 该基准包含的11个维度分别为:D1 社会感知、D2 社会理解与洞察、D3 沟通能力、D4 情绪运用、D5 关系管理、D6 自我一致性、D7 观察模仿、D8 适应性学习、D9 社会文化智能、D10 社会责任、D11 道德与伦理智能。 ## 任务格式 每个条目呈现一个情境、一个问题与3个候选回复,这些回复分别从最优、次优与违反社交边界的回复库中采样得到。模型需将3个选项按从优到劣的顺序进行排序。 预测结果为一个3位字符串,用于表示Opt1、Opt2、Opt3的排序顺序。例如: - `231` → Opt2为最优,Opt3为次优,Opt1为最差 - `123` → Opt1为最优,Opt2为次优,Opt3为最差 ## 评估指标 **精确匹配准确率**:仅当预测的完整排序与黄金标注排序完全一致时,该预测才被判定为正确,部分匹配不计分。报告将同时涵盖整体准确率与各维度准确率。 ## 使用方法 python from datasets import load_dataset dataset = load_dataset("Zoe0104/NICE") df = dataset["train"].to_pandas() ## 提交要求 请准备一个包含两列的CSV文件并发送至作者进行评估,格式示例如下: ID,prediction 1_1,231 1_2,123 ...

提供机构:
Zoe0104
搜集汇总
数据集介绍
Zoe0104/NICE 数据集图片
构建方式
NICE(Norm, Interaction, Cognition, Experience)数据集以心理测量学原理与专家验证为理论基础,构建了一套层次分明的社会智能评估框架。该框架将社会智能细化为4个类别、11个维度与34个能力层面,实现了对大型语言模型的细粒度诊断。测试集包含137个扎根于代表性中国社交场景的测试条目,每个条目均与预定义的能力层面紧密关联。条目由情景描述、问题、以及从最优、次优和边界违规三个响应池中抽取的候选回答构成,要求模型对三者进行排序,以检验其对社会规范的认知与判断能力。
特点
NICE数据集的核心特色在于其理论驱动的结构性设计,超越了传统的单一评分模式,能够对社会智能进行多维度、多层次的全景式评估。其11个维度涵盖了社会知觉、沟通、情绪运用、关系管理、文化智慧、道德伦理等关键领域,确保评估的全面与深入。评估采用精确匹配的准确率作为指标,要求模型的排序结果与真实排序完全一致,否则不予计分,这一严苛标准能够有效甄别模型在社会智能细微差别上的理解差异。
使用方法
用户可通过HuggingFace Datasets库便捷加载NICE数据集,执行load_dataset('Zoe0104/NICE')命令即可获取训练集数据。每个测试条目包含情景、问题及三个候选选项,模型需输出一个三位数字符串表示精排结果(如'231'代表选项2最优、3次之、1最差)。使用时应准备包含ID与预测排序两列的CSV文件,提交至作者处进行整体与分维度的精确匹配准确率评估,从而诊断模型在各类社会智能维度上的表现与短板。
背景与挑战
背景概述
NICE(Norm, Interaction, Cognition, Experience)数据集由香港科技大学等机构的研究人员于2024年创建,旨在系统评估大语言模型的社会智能。社会智能作为人工智能领域的前沿课题,涉及感知、理解、沟通、情绪管理等多个维度的综合能力。NICE基于心理测量学与专家验证的理论框架,将社会智能细分为4个类别、11个维度和34个能力方面,超越传统的整体评分方式,实现了对模型社会认知能力的精细化诊断。该数据集以137个具有代表性的中国社交场景为测试样本,推动了AI社会智能评估的理论化与标准化进程,对相关研究产生了深远影响。
当前挑战
NICE数据集面临的挑战是多层面的。在领域问题层面,它要解决大语言模型社会智能评估的瓶颈——传统方法难以捕捉社会互动的细微差别与道德伦理的敏感性,而NICE通过精确的排序任务和严苛的精确匹配标准,推动模型超越简单回答,实现细粒度的社会认知诊断。在构建过程中,研究人员需确保137个测试项目覆盖11个社会智能维度,且每个场景具备现实代表性与文化特异性,同时设计出最优、次优和边界违规的三类候选响应,并确定黄金排序。此外,如何平衡评估的全面性与数据规模的可管理性,以及确保评分标准在不同社会语境下的客观公正,亦是严峻挑战。
常用场景
经典使用场景
在人工智能飞速发展的时代背景下,大型语言模型的社会智能评估成为研究前沿。NICE数据集以其理论驱动的诊断框架,精妙地将社会智能划分为四个类别、十一个维度与三十四个能力侧面,为研究者提供了一种超越聚合得分的细粒度剖析工具。其经典使用场景聚焦于评估模型在复杂社会情境中的规范理解、交互认知与经验推理能力,通过预设的社会场景、问题及三级选项,要求模型完成从最优到最差的完整排序,从而精准捕获模型在社会智能各维度上的表现差异。
衍生相关工作
NICE数据集的发布催生了一系列围绕大型语言模型社会智能的衍生工作。一方面,研究者基于其维度框架开发了针对性的训练策略,如通过强化学习对模型在道德伦理维度上的偏好进行微调,显著提升了模型的社会责任感。另一方面,NICE的评估方法论被迁移至跨文化社交场景研究,衍生出面向不同社会规范体系的对比分析工作。此外,还有学者借鉴其能力侧面的概念,构建了多模态社会智能基准,将视觉情境中的社交线索评估纳入考量,进一步拓展了社会智能研究的边界与应用广度。
数据集最近研究
最新研究方向
NICE基准测试聚焦于大语言模型(LLM)社会智能的细粒度诊断,基于心理学测量学原理与专家验证构建了涵盖4大类别、11个维度和34个能力面的理论框架。在LLM社会认知研究的前沿领域,NICE通过137个植根于中国社会情境的测试题项,精准评估模型在社会感知、沟通、关系管理、道德伦理等多维度的综合表现。该基准与当前AI伦理和社会责任热点紧密关联,为评估LLM在复杂人际互动中的适应性、文化敏感性和道德判断提供了严格的方法论工具,推动了从单体能力到系统化社会智能的评估范式变革。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

