
遇见数据集

WorldReward-Bench

收藏
arXiv2026-09-03 更新2026-09-05 收录
官方服务:

资源简介:

WorldReward-Bench是由复旦大学、腾讯混元等机构联合构建的人类标注基准数据集,旨在评估相机条件世界模型的奖励模型。该数据集包含760对配对的视频生成结果,覆盖多种轨迹类型、视觉风格及世界模型来源,每对视频均附带独立的人类标注偏好,涵盖动作一致性、外观质量和运动质量三个维度。数据集通过多轮工具辅助代理审核与人工校准精心创建,确保标注的可靠性与细粒度。其核心应用在于为统一评估动作执行与视觉质量的奖励模型提供标准测试平台,解决现有奖励模型难以同时衡量这两方面耦合需求的难题。

WorldReward-Bench is a human-annotated benchmark dataset jointly constructed by Fudan University, Tencent Hunyuan and other institutions, aiming to evaluate reward models for camera-conditioned world models. This dataset includes 760 pairs of matched video generation results, covering diverse trajectory types, visual styles and world model sources. Each pair of videos is accompanied by independent human annotation preferences, which span three dimensions: action consistency, appearance quality and motion quality. It was meticulously curated through multi-round tool-assisted agent review and manual calibration, ensuring the reliability and fine-grained nature of the annotations. Its core application is to provide a standardized testbed for the unified evaluation of reward models that assess both action execution and visual quality, addressing the challenge that existing reward models struggle to simultaneously quantify the coupled requirements of these two aspects.

创建时间:
2026-09-03
原始信息汇总

数据集概述

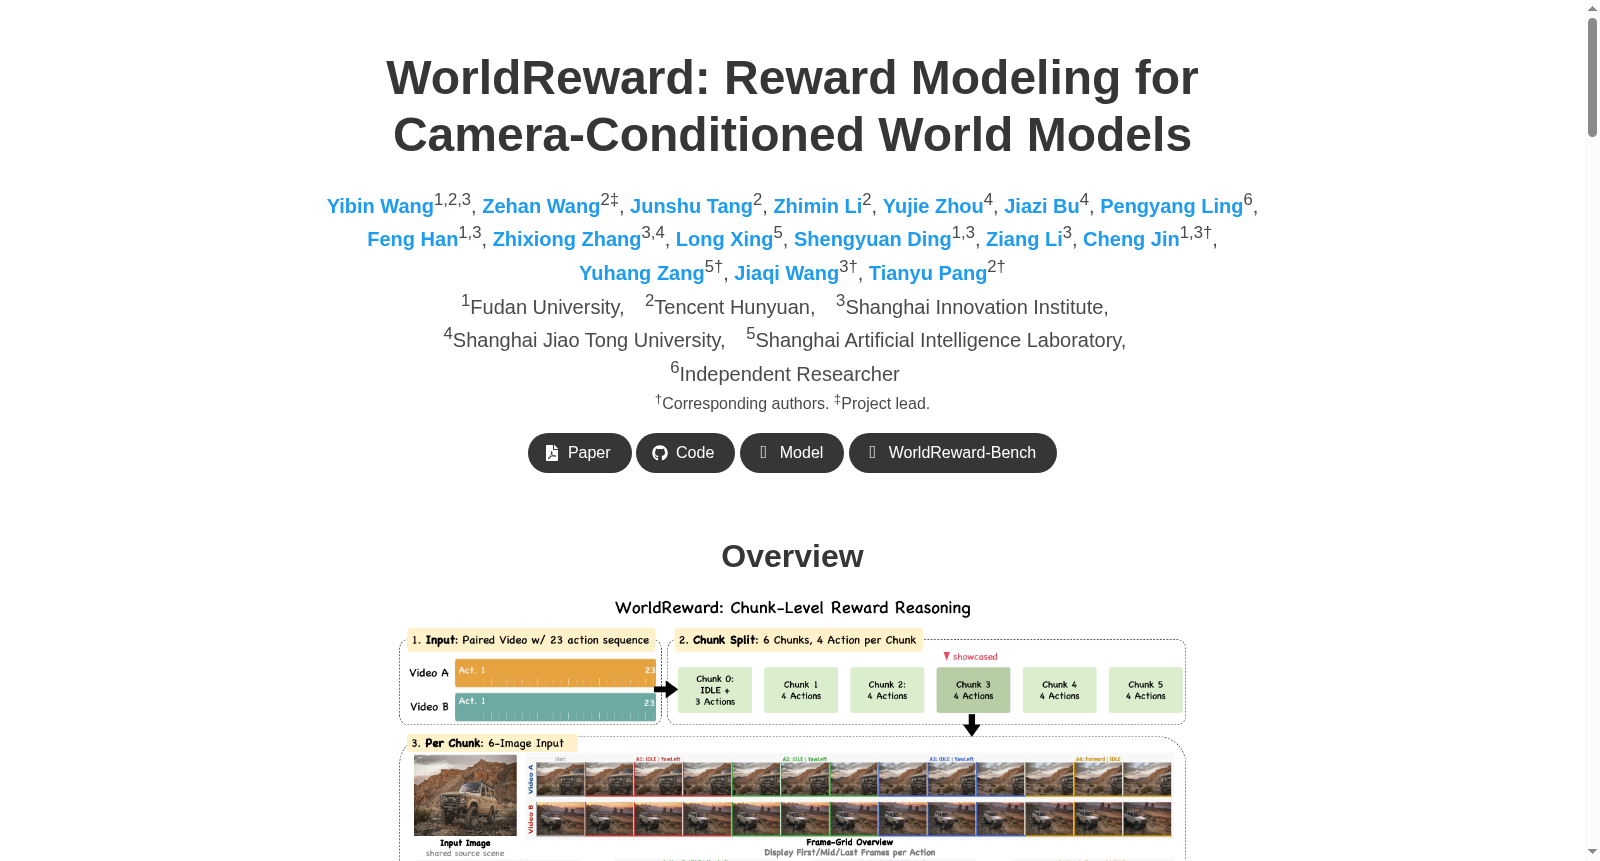
WorldReward 是一个基于视觉语言模型(VLM)的成对偏好奖励模型,专为相机条件世界模型(Camera-Conditioned World Models)设计,用于统一评估生成视频中的动作一致性和视觉质量。

核心思想

WorldReward 将成对视频分解为动作对齐的片段(action-aligned chunks),并将每个片段组织为结构化视觉证据,从而评估单个动作的执行情况以及视觉质量。片段级决策通过投票聚合为全局偏好。

训练数据构建

训练数据采用推理增强的偏好数据(Reasoning-augmented preference data),其构建流程如下:

  1. 由前沿 VLM 生成结构化判断
  2. 通过多轮基于工具(tool-based)的智能体审计(agent auditing)进行细化
  3. 结合针对性的人工审查(human review)进行精修

基准测试

WorldReward-Bench 是一个人工标注的基准数据集,用于衡量奖励模型与人类偏好的对齐程度,涵盖以下三个维度:

  • 动作一致性(Action)
  • 外观质量(Appearance)
  • 运动质量(Motion)

该基准包含来自 9 个世界模型的 760 个人工标注视频对,覆盖多种轨迹、视觉风格和来源模型。

应用效果

实验表明,WorldReward 在动作一致性和视觉质量评估上优于现有的开源奖励模型和专有 VLM 评测器。将其用于 HY-WorldPlay 1.5 的强化学习(RL)后训练时,可有效提升动作执行效果和生成视频的视觉质量。
搜集汇总
数据集介绍
WorldReward-Bench 数据集图片
构建方式
WorldReward-Bench的构建旨在评估相机条件世界模型的奖励模型与人类偏好的一致性。该基准包含760对视频生成样本,每对样本共享相同的源图像、标题和动作轨迹,确保比较条件固定。样本覆盖多样的轨迹族,包括纯平移、纯旋转和复合运动,并涵盖多种视觉风格和世界模型来源。每对视频由三位标注者独立评估,分别针对动作一致性、外观质量和运动质量三个维度进行投票选择,最终标签通过多数投票确定。为确保标注质量,标注前进行了校准环节,以统一评估标准。
特点
WorldReward-Bench具有三个核心特点:首先,它提供独立于动作一致性、外观质量和运动质量的三维人类偏好标注,支持多维度评估;其次,样本多样性丰富,覆盖了广泛的轨迹类型、视觉风格和生成模型,能够全面测试奖励模型的泛化能力;最后,标注过程严格,通过多名标注者独立评估和校准,确保了标签的可靠性和一致性。该基准特别关注长视频中局部动作的视觉证据,使得模型评估更贴近真实生成场景。
使用方法
WorldReward-Bench主要用于评估奖励模型在相机条件世界模型生成中的表现。研究者可使用该基准计算模型预测与人类标注之间的三维偏好准确率,以检验不同奖励模型在动作执行、外观保持和运动合理性上的判断能力。此外,该基准还可用于比较不同奖励模型在图像质量、视频偏好和几何估计等方面的性能,为选择或设计更优的奖励模型提供参考。通过公开的标注协议和评估代码,研究者能够复现实验结果并扩展自己的方法。
背景与挑战
背景概述
WorldReward-Bench是2026年由复旦大学、腾讯混元等机构的研究者构建的一个面向相机条件世界模型奖励模型评估的人工标注基准。该数据集的核心研究问题在于,如何统一评估生成视频在动作一致性与视觉质量上的表现,以弥补传统几何奖励与图像质量奖励的割裂。其影响力在于,它首次为相机条件世界模型提供了涵盖动作一致性、外观质量和运动质量的独立人类偏好标签,为奖励模型的设计与验证奠定了重要基础,并推动了世界模型在强化学习后训练中的实际应用。
当前挑战
该数据集面临的挑战首先体现在领域问题层面:相机条件世界模型的奖励需同时判断复杂动作轨迹的执行正确性与长时间序列中的视觉连贯性,而现有方法往往顾此失彼,难以在共享语义空间中对动作与视觉结果进行关联判断。在构建过程中,挑战在于生成涵盖多模型输出的配对视频、设计支持局部证据定位的轨道分组,以及确保人类标注的一致性和维度间独立性,其中动作一致性与视觉质量的双重标注要求评估者细致区分动作执行与外观动态的差异,带来了较高的标注复杂度和质量保障难题。
常用场景
经典使用场景
WorldReward-Bench作为面向相机条件世界模型的专用基准,其核心用途在于系统性地评估奖励模型与人类偏好的一致性。该基准涵盖760对配对生成视频,每对共享相同的源图像、文本描述与动作轨迹,并分别对动作一致性、外观质量与运动质量进行独立标注。研究者可在此基准上横向比较不同奖励模型在三个维度上的三元(胜/负/平)预测精度,从而验证其在复杂交互场景中的奖励建模能力。其设计尤其注重轨迹族、视觉风格与世界模型来源的多样性,使得评估结果能够反映模型在纯平移、纯旋转及复合控制等多样化条件下的泛化表现。
实际应用
在实际应用中,WorldReward-Bench可作为世界模型开发中的标准评估工具,用于筛选与验证奖励模型的质量。例如,在视频生成模型的强化学习后训练流程中,研究者可利用该基准快速评估不同偏好奖励与人类判断的契合度,从而选择最优奖励函数以提升动作执行准确率与视觉稳定性。此外,该基准还可服务于交互式游戏、虚拟环境模拟等领域的模型调优,帮助开发者定位模型在特定动作或风格下的生成缺陷。其基于配对比较的协议亦适用于自动化质量监控,降低了依赖人工评分的成本,提升了模型迭代效率。
衍生相关工作
WorldReward-Bench的发布衍生了多项相关工作。其构建方法论启发了后续研究探索更高效的奖励标注管线,例如利用多轮智能体审计与人类校准的混合策略来提升标注质量。同时,基于该基准的评估结果促进了奖励模型架构的改进,如结合结构化视觉证据的分块推理范式,被后续工作借鉴以处理长视频中的局部证据定位问题。此外,该基准与强化学习协议(如DiffusionNFT)的结合,推动了针对长时程世界模型的奖励设计研究,包括多维度偏好聚合与平衡策略。这些衍生工作共同丰富了视频生成及其评估领域的理论基础与实践工具。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

