SFGram
收藏资源简介:
SFGram是一个包含公共科幻小说、书籍和电影封面的数据集,旨在供研究人员研究科幻文学随时间的演变,并测试机器学习算法在作者归属和文档分类任务上的应用。所有文档均来自公共领域,获取自Gutenberg项目或archive.org网站。
SFGram is a dataset comprising public domain science fiction novels, books, and movie covers, designed to facilitate researchers in studying the evolution of science fiction literature over time and to test machine learning algorithms in tasks such as author attribution and document classification. All documents are sourced from the public domain, obtained from the Gutenberg Project or the archive.org website.
数据集概述
数据集名称: SFGram
内容: SFGram 数据集包含数千本科幻小说、小说和电影信息。该数据集主要由公共领域的科幻小说、书籍和电影封面组成,旨在供研究人员用于研究科幻文学的演变,并测试机器学习算法在作者归属和文档分类任务上的应用。
数据来源: 所有文档均来自公共领域,主要从古腾堡项目或archive.org网站获取。
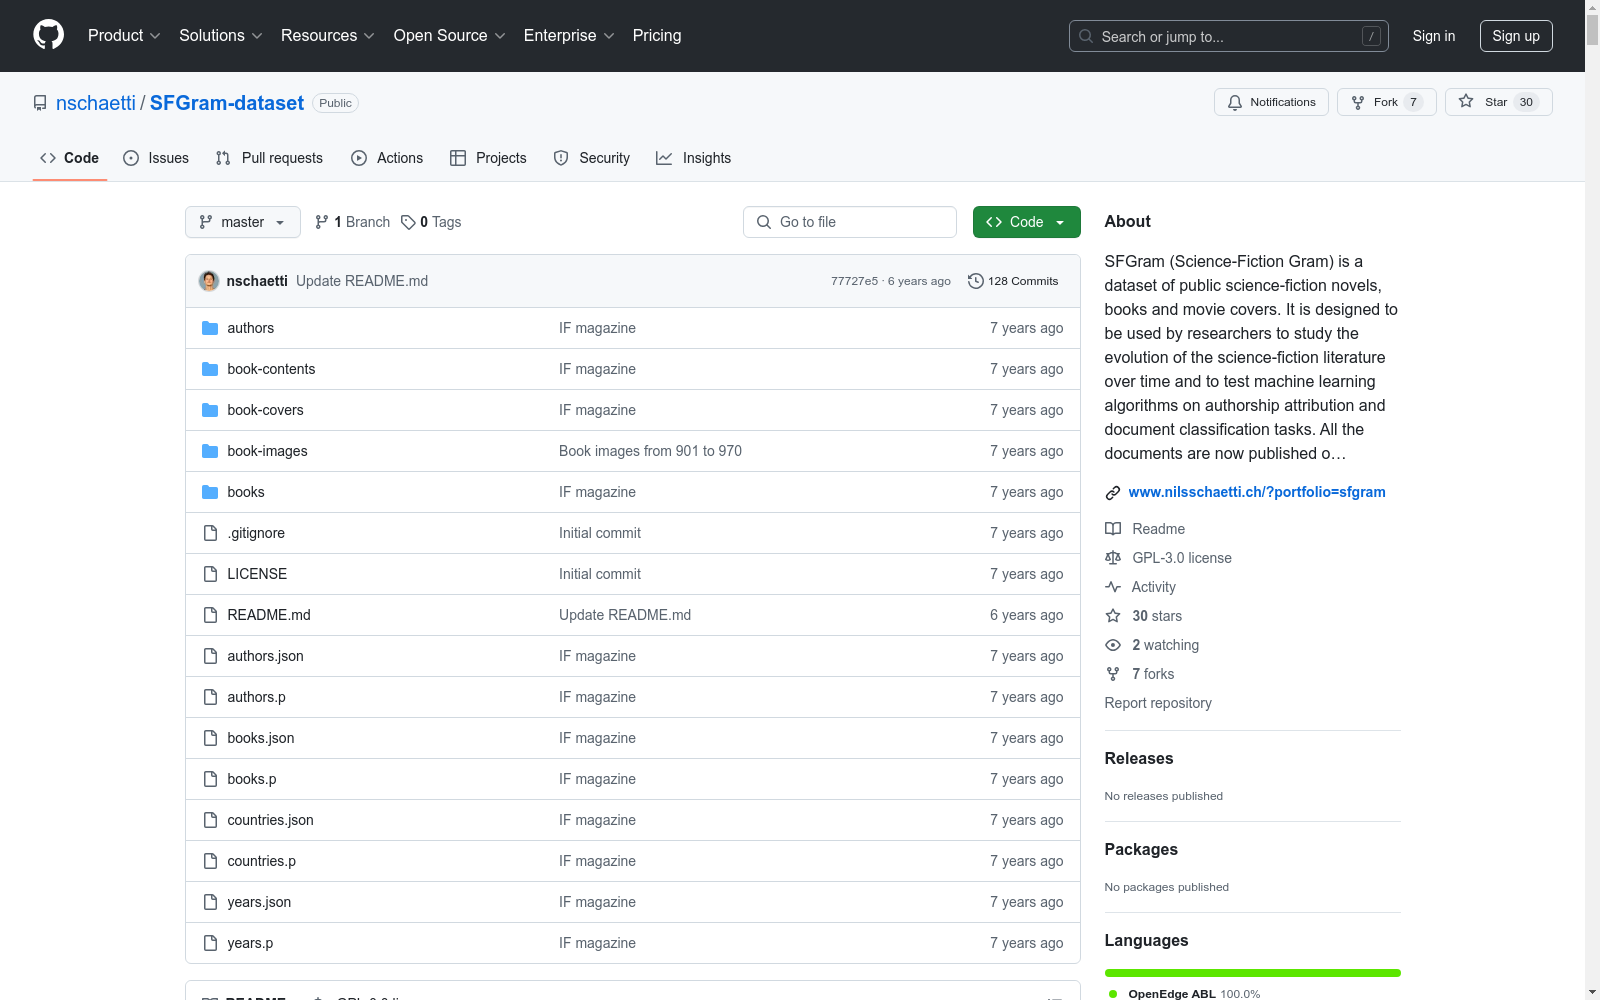
数据集结构
文件和目录:
- authors: 包含所有作者文件,每个文件名为“authorsXXXXX.json”,其中XXXXX是作者ID。
- book-contents: 包含所有文本文档,每个文件名为“bookXXXXX.txt”,其中XXXXX是书籍ID。
- book-covers: 包含所有书籍封面,每个文件名为“bookXXXXX-NAME.jpg”。
- book-images: 包含书籍的图像,如果对应的书籍在维基百科页面存在。
- books: 包含所有书籍的JSON文件。
- authors.json: 包含所有作者目录中的JSON对象列表。
- books.json: 包含所有书籍目录中的JSON对象列表。
- countries.json: 包含国家列表,每个对象包含国家名称和ID,以及与之关联的书籍ID。
- years.json: 包含年份列表,每个对象包含年份和该年出版的书籍ID。
作者信息:
- 字段: 包括姓名、国家、性别、简介、出生日期、书籍列表等。
- 示例: Ayn Rand的详细信息,包括其姓名、国家、性别、简介、出生和死亡日期等。
书籍信息:
- 字段: 包括内容名称、作者姓名、图像URL、出版年份、标题、描述等。
- 示例: 《The Face and the Mask》的详细信息,包括作者、出版年份、标题、描述等。
国家信息:
- 字段: 包括书籍列表、国家ID、名称、作者列表。
- 示例: 英国的详细信息,包括与之关联的书籍和作者。
年份信息:
- 字段: 包括书籍数量、书籍列表。
- 示例: 2017年的详细信息,包括该年出版的书籍数量和列表。
数据集用途
SFGram数据集主要用于研究科幻文学的演变和测试机器学习算法,特别是在作者归属和文档分类任务上。