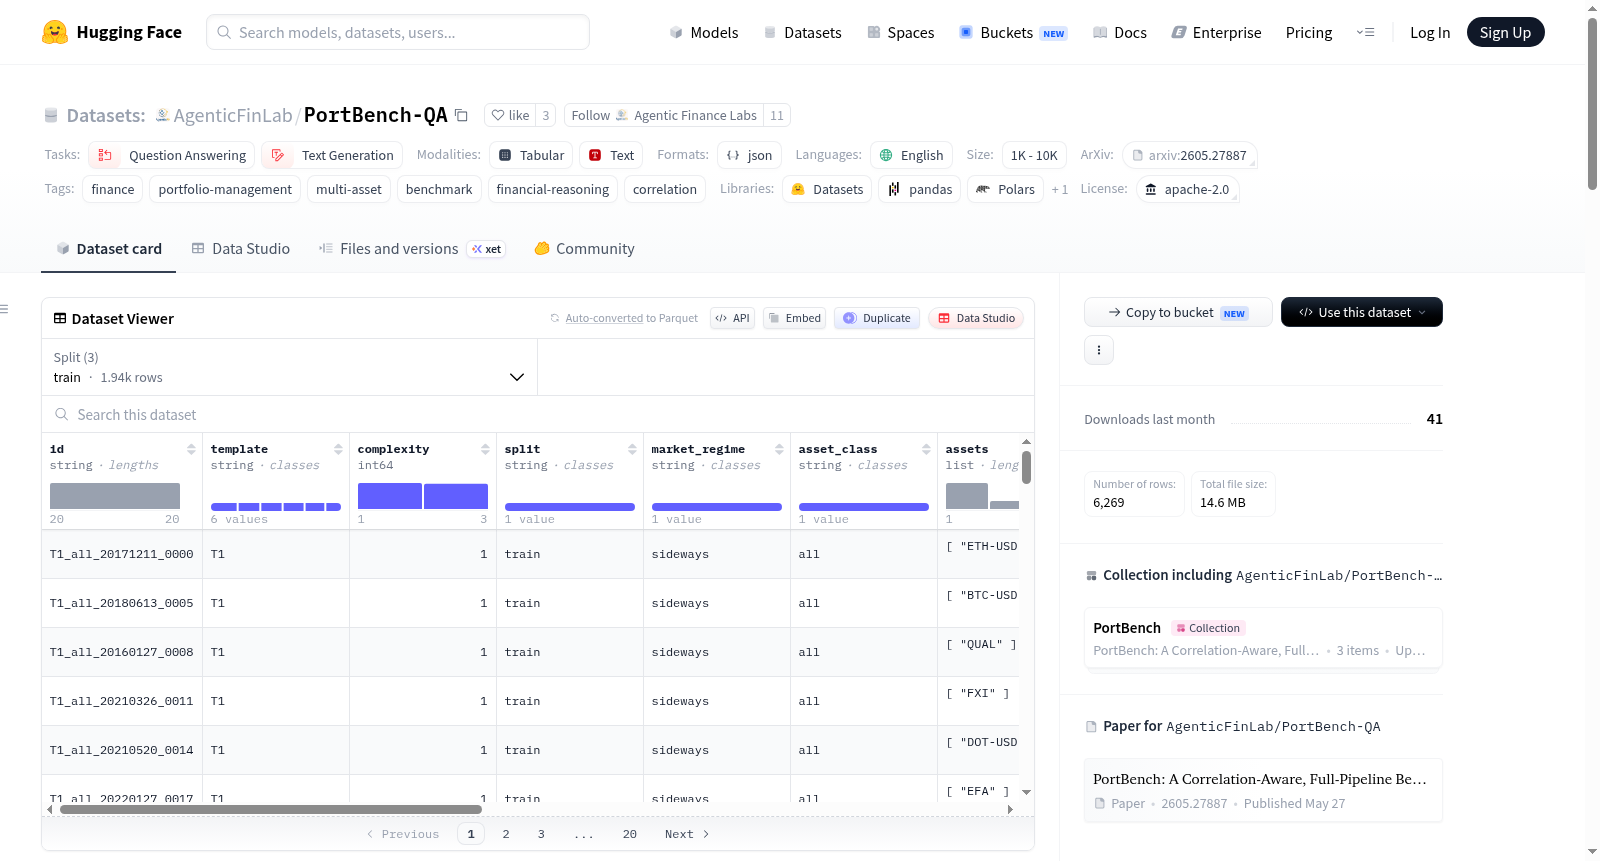
AgenticFinLab/PortBench-QA
收藏资源简介:
PortBench QA数据集包含6,269个结构化问答对,用于探究基于相关性的多资产投资组合管理金融推理。该数据集从PortBench市场基础数据集生成,涵盖7个任务模板(T1-T7),复杂度从1(单资产)到4(完整投资组合),包括回报预测、风险评估、头寸规模调整、成对分配、多资产优化、再平衡决策和状态检测等任务。数据分为训练集(2015-01-02至2022-12-31,1,941对)、验证集(2023-01-01至2024-12-31,2,700对)和测试集(2025-01-01至2025-12-31,1,628对)。每个JSONL记录包含唯一标识符、模板、复杂度、分割、市场状态、资产类别、资产列表、决策日期、市场上下文摘要、问题、答案、数值答案、解释和元数据等字段。85.3%的问答对在上下文窗口中包含相关新闻文本(平均3,997字符)。数据按市场状态(牛市、熊市、横盘、危机)分层,以支持按状态分解性能。数据集旨在评估LLM的金融推理能力、基准测试基于相关性的多资产决策,并比较静态知识(问答准确率)与动态管道性能(CEPS)。所有问题仅使用决策日期或之前的信息,真实答案基于未来实现数据计算,但未包含在问题或上下文中。
--- 语言: - 英语(en) 许可证:apache-2.0 任务类别: - 问答(question-answering) - 文本生成(text-generation) 标签: - 金融 - 投资组合管理(portfolio-management) - 多资产(multi-asset) - 基准(benchmark) - 金融推理(financial-reasoning) - 相关性(correlation) 数据规模类别: - 100万<样本量<1000万 --- [](https://arxiv.org/abs/2605.27887) [](https://github.com/AgenticFinLab/portbench) # PortBench问答数据集 ## 数据集描述 本数据集包含6269组结构化问答样本,用于探究多资产投资组合管理中的相关性驱动金融推理能力,数据源自PortBench市场基础数据集。 ### 任务模板 | 任务模板 | 任务内容 | 复杂度 | 样本量 | |----------|----------|:------:|-------:| | T1 | 收益预测——未来N个交易日的涨跌方向 | 1(单资产) | 1000 | | T2 | 风险评估——给定置信水平下的风险价值(VaR) | 1 | 1000 | | T3 | 头寸规模确定——给定最大回撤约束 | 1 | 1000 | | T4 | 两两资产配置——双资产组合的方差最小化 | 2(两两资产) | 1000 | | T5 | 多资产优化——3种及以上资产的夏普比率最大化 | 3(多资产) | 1000 | | T6 | 再平衡决策——基于阈值的触发条件 | 3 | 778 | | T7 | 市场状态检测——识别多头/空头/盘整行情并调整配置 | 4(全投资组合) | 491 | ### 数据集划分 | 数据集划分 | 时间区间 | 样本量 | |------------|----------|-------:| | 训练集 | 2015-01-02 – 2022-12-31 | 1941 | | 验证集 | 2023-01-01 – 2024-12-31 | 2700 | | 测试集 | 2025-01-01 – 2025-12-31 | 1628 | ### 数据字段 | 字段名 | 数据类型 | 字段说明 | |--------|----------|----------| | `id` | 字符串 | 唯一标识符,格式为`{template}_{class}_{date}_{seq}` | | `template` | 字符串 | 任务模板(T1至T7) | | `complexity` | 整数 | 难度等级(1至4) | | `split` | 字符串 | 数据集划分(训练集/验证集/测试集) | | `market_regime` | 字符串 | 市场行情状态(多头/空头/盘整/危机) | | `asset_class` | 字符串 | 目标资产类别 | | `assets` | 字符串列表 | 涉及的标的代码(ticker) | | `decision_date` | 字符串 | 时点决策日期,格式为YYYY-MM-DD | | `context_summary` | 字符串 | 市场上下文窗口,包含价格、宏观经济、相关性、新闻等信息 | | `question` | 字符串 | 包含所有必要数值上下文的问题文本 | | `answer` | 字符串 | 标准答案 | | `answer_numeric` | 浮点数 | 数值化标准答案,用于模型评估 | | `explanation` | 字符串 | 答案的分步推导说明 | | `metadata` | 对象类型 | 额外元数据字段,包含未来收益、预测周期、波动率、文本覆盖度等 | ### 示例 json { "id": "T1_all_20251226_0002", "template": "T1", "complexity": 1, "split": "test", "market_regime": "sideways", "assets": ["DBB"], "decision_date": "2025-12-26", "question": "Asset: DBB Historical prices (past 60 trading days): start=20.40, end=22.01, cumulative_return=+7.9%, annualized_volatility=14.0% ... Predict whether the return of DBB over the next 21 trading days will be: positive (>+1%), negative (<-1%), or flat (within ±1%).", "answer": "flat", "answer_numeric": 0.0, "explanation": "The actual 21-day forward return for DBB starting 2025-12-26 was +0.00%, which classifies as 'flat'." } ### 文本覆盖度 85.3%的问答样本的上下文窗口中包含关联新闻文本,平均长度为3997个字符。 ### 市场行情状态分布 本数据集按照市场行情状态(多头/空头/盘整/危机)进行分层,以支持分行情下的模型性能拆解分析。 ### 预期用途 - 评估大语言模型(LLM)在四个难度等级下的金融推理能力 - 为基于相关性的多资产决策任务提供基准测试 - 对比静态知识问答准确率与动态流水线(CEPS)的性能表现 ### 时点(PiT)约束 所有问题仅使用决策日期`decision_date`当天或更早的可用信息,标准答案基于已实现的未来数据计算得出,且该未来数据不会出现在问题或上下文之中。