
yelp-review-infill-test
收藏官方服务:
资源简介:
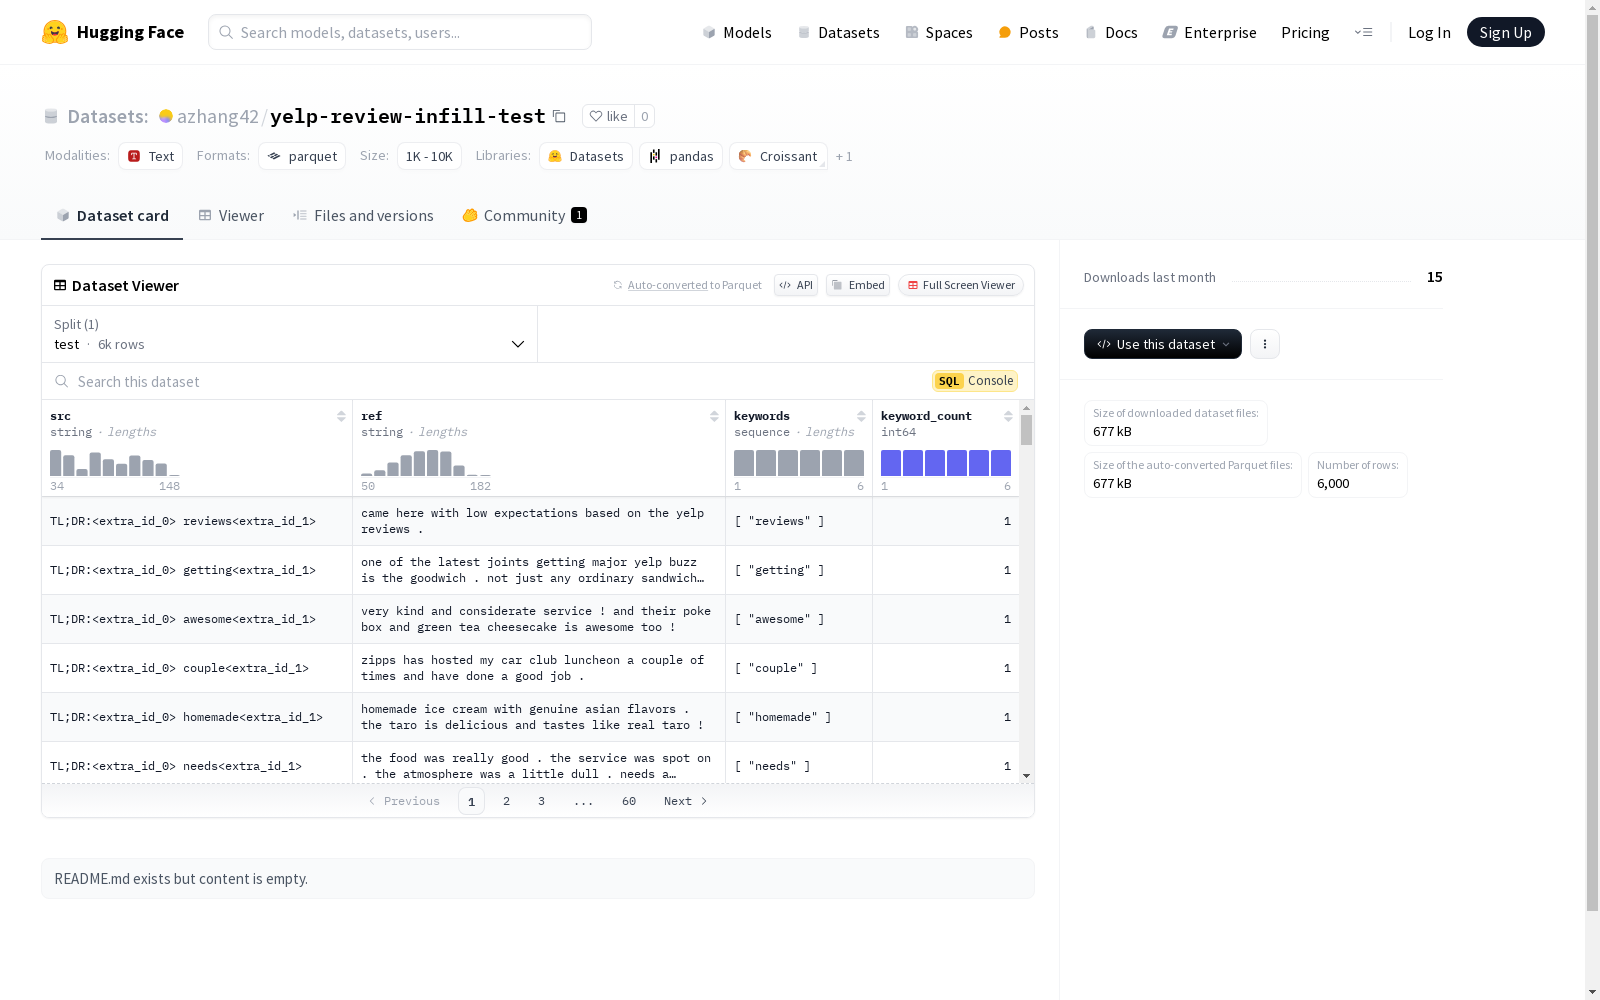
该数据集包含源文本(src)、参考文本(ref)、关键词(keywords)和关键词计数(keyword_count)四个特征。数据集被分割为测试集(test),包含6000个样本。数据集的下载大小为676590字节,数据集大小为1523647字节。
This dataset includes four features: source text (src), reference text (ref), keywords, and keyword_count. The dataset is split into the test set, which contains 6000 samples. The download size of the dataset is 676590 bytes, and the total size of the dataset is 1523647 bytes.
创建时间:
2024-12-14
原始信息汇总
数据集概述
数据集信息
-
特征:
- src: 数据类型为字符串。
- ref: 数据类型为字符串。
- keywords: 数据类型为字符串序列。
- keyword_count: 数据类型为整数(int64)。
-
数据分割:
- test: 包含6000个样本,数据大小为1523647字节。
-
下载大小: 676590字节
-
数据集大小: 1523647字节
配置
- 配置名称: default
- 数据文件:
- split: test
- path: data/test-*
- 数据文件:
搜集汇总
数据集介绍
构建方式
yelp-review-infill-test数据集的构建基于Yelp评论数据,旨在提供一个用于测试文本填充任务的资源。该数据集包含了6000条评论样本,每条样本由源文本(src)、参考文本(ref)、关键词列表(keywords)以及关键词数量(keyword_count)组成。通过这种方式,数据集为研究者提供了一个结构化的测试平台,以便评估和优化文本填充算法。
特点
yelp-review-infill-test数据集的主要特点在于其结构化的数据格式和明确的目标任务。每条评论样本不仅提供了源文本和参考文本,还包含了关键词列表及其数量,这为研究者提供了丰富的信息来评估文本填充模型的性能。此外,数据集的规模适中,适合用于快速验证和测试算法,同时保持了数据的多样性和代表性。
使用方法
使用yelp-review-infill-test数据集时,研究者可以将其作为测试集来评估文本填充模型的性能。具体而言,可以通过比较模型生成的文本与参考文本(ref)的相似度,以及关键词的保留情况(keywords和keyword_count),来量化模型的表现。数据集的结构化格式使得加载和处理变得简单,适合集成到各种机器学习和自然语言处理框架中进行实验和分析。
背景与挑战
背景概述
Yelp-Review-Infill-Test数据集由Yelp公司发布,专注于评论文本的填充与生成任务。该数据集的核心研究问题是如何在给定部分评论内容的情况下,自动生成或填充缺失的文本部分,以提高评论的完整性和可读性。这一研究背景源于自然语言处理领域对文本生成技术的持续探索,尤其是在用户生成内容(UGC)平台中,评论的完整性对于用户体验至关重要。Yelp-Review-Infill-Test数据集的发布,为研究人员提供了一个标准化的测试平台,以评估和改进文本填充与生成模型的性能。
当前挑战
Yelp-Review-Infill-Test数据集在构建和应用过程中面临多项挑战。首先,评论文本的多样性和复杂性使得生成模型需要具备高度的语言理解和生成能力,以确保生成的文本既符合语境又具有自然流畅性。其次,数据集的构建过程中,如何准确提取和标注关键字及其数量,以指导模型的生成过程,也是一个技术难点。此外,在实际应用中,模型需要能够在保持评论原意的基础上,生成符合用户预期的文本,这对模型的语义理解和上下文把握能力提出了更高的要求。
常用场景
经典使用场景
Yelp评论填充测试数据集(yelp-review-infill-test)主要用于自然语言处理领域中的文本生成和填充任务。该数据集通过提供源文本(src)和参考文本(ref),以及相关的关键词(keywords)和关键词计数(keyword_count),帮助研究者和开发者训练和评估模型在缺失文本填充任务中的表现。经典的使用场景包括基于关键词的文本生成、文本修复以及对话系统中的上下文补全等。
衍生相关工作
基于Yelp评论填充测试数据集,研究者们开发了多种文本生成和填充模型,推动了自然语言处理技术的进步。例如,有研究利用该数据集进行关键词驱动的文本生成模型训练,提升了生成文本的连贯性和相关性。此外,该数据集还被用于评估不同模型的文本修复能力,促进了相关算法的优化和创新。这些衍生工作不仅丰富了自然语言处理的研究内容,也为实际应用提供了技术支持。
数据集最近研究
最新研究方向
在自然语言处理领域,yelp-review-infill-test数据集的最新研究方向主要集中在文本生成与补全技术的优化上。该数据集通过提供源文本(src)、参考文本(ref)以及关键词(keywords)和关键词计数(keyword_count),为研究者提供了一个评估和改进文本生成模型的理想平台。当前的研究热点包括利用关键词信息进行更精准的文本补全,以及通过对比源文本与参考文本的差异,提升生成文本的连贯性和语义准确性。这些研究不仅有助于提高自然语言处理系统的性能,还对增强用户体验、优化推荐系统等领域具有重要意义。
以上内容由遇见数据集搜集并总结生成


