Torch-Trade/btc-reasoning-traces-05_2021-05_2022-gemma4-31B
收藏资源简介:
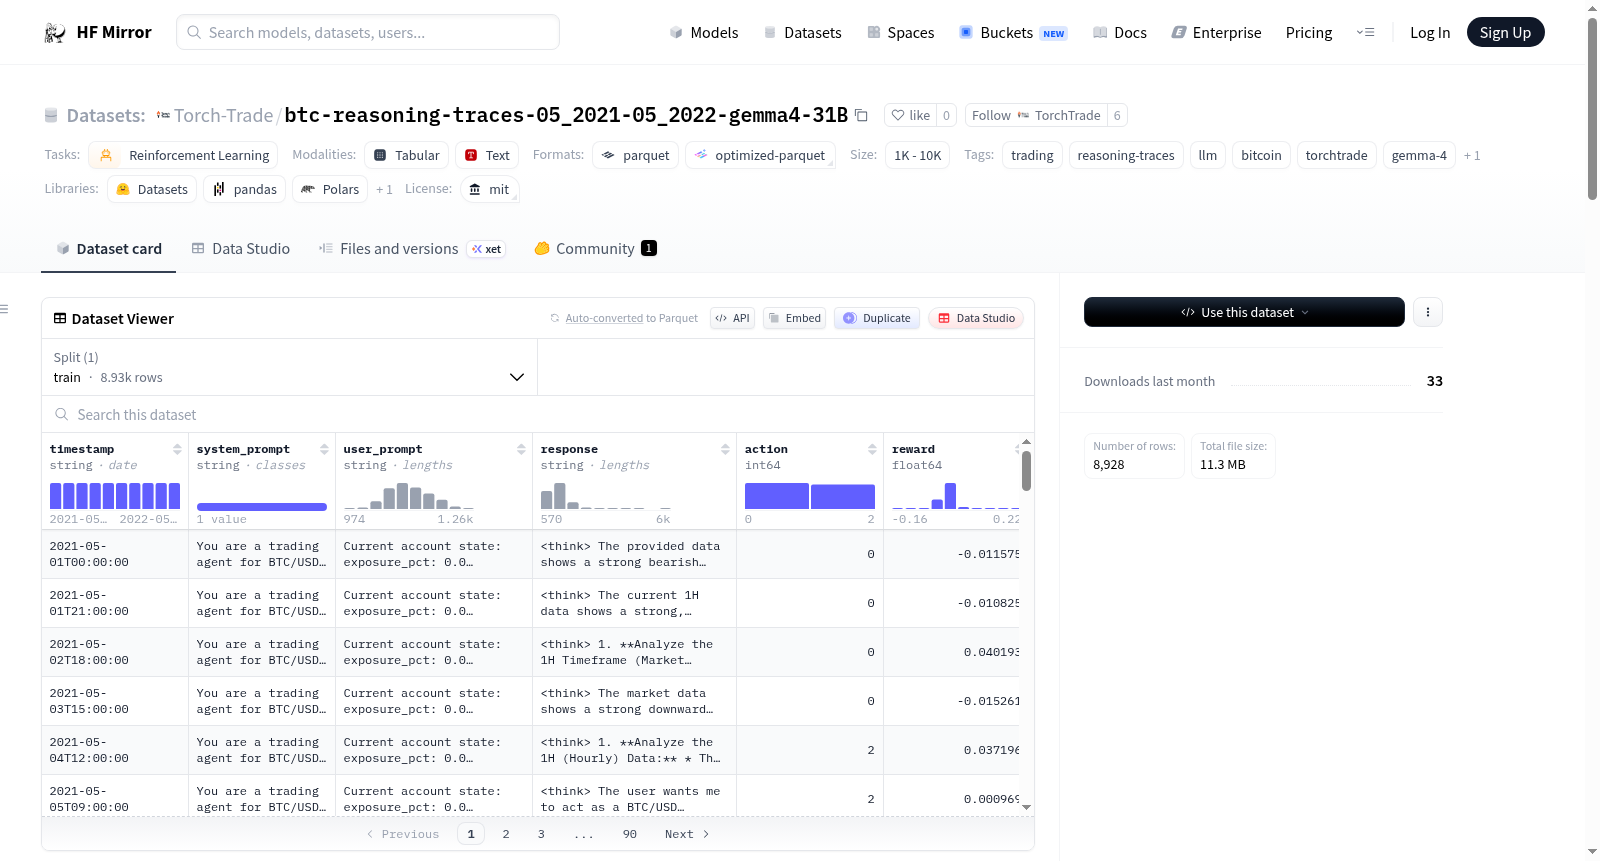
--- license: mit task_categories: - reinforcement-learning tags: - trading - reasoning-traces - llm - bitcoin - torchtrade - gemma-4 - nvfp4 size_categories: - 1K<n<10K --- # BTC Reasoning Traces: Gemma 4 31B (May 2021 - May 2022) LLM reasoning traces for BTC/USD hourly trading decisions, generated by **nvidia/Gemma-4-31B-IT-NVFP4** running locally on a DGX Spark via vLLM. Each row is one hourly trading decision with full chain-of-thought reasoning. ## Generation | Field | Value | |---|---| | Teacher model | `nvidia/Gemma-4-31B-IT-NVFP4` (30.7B params, NVFP4 quantized) | | Inference engine | vLLM 0.19.1 on DGX Spark (128GB unified memory, GB10) | | Temperature | 0.6 | | Prompt format | Compact (delta-encoded OHLCV, ~400 tokens/prompt) | | Batch size | 64 parallel episodes | | Throughput | ~370-390 tok/s | | Total traces | 8,928 | | Valid action rate | 100.0% | ## Data coverage **8,928 hourly trading decisions** covering ~1 year of BTC/USD perpetual futures: | Period | Date range (UTC) | |---|---| | Start | 2021-05-01T00:00:00 | | End | 2022-05-07T23:00:00 | Source data: [`Torch-Trade/btcusdt_perp_1m_05_2021_to_02_2026`](https://huggingface.co/datasets/Torch-Trade/btcusdt_perp_1m_05_2021_to_02_2026) ## Environment configuration | Parameter | Value | |---|---| | Symbol | BTC/USD | | Execution timeframe | 1Hour (decisions every hour) | | Action space | `[-1, 0, 1]` (short / flat / long) | | Leverage | 3x | | Initial cash | $10,000 | | Observation | 12-bar 5min + 24-bar 1hour OHLCV (compact delta-encoded) | ## Action distribution | Action | Count | Pct | |---|---|---| | 0 (short) | 4,592 | 51.4% | | 1 (flat) | 1,080 | 12.1% | | 2 (long) | 3,256 | 36.5% | ## Columns | Column | Type | Description | |---|---|---| | `timestamp` | string | ISO timestamp of the trading decision | | `system_prompt` | string | System instructions for the trading agent | | `user_prompt` | string | Compact delta-encoded OHLCV data + account state | | `response` | string | Full `<think>reasoning</think><answer>N</answer>` output | | `action` | int | Extracted action (0=short, 1=flat, 2=long) | | `reward` | float | Reward received after taking the action | ## Usage ```python from datasets import load_dataset ds = load_dataset("Torch-Trade/btc-reasoning-traces-05_2021-05_2022-gemma4-31B") # Browse a reasoning trace row = ds["train"][42] print(row["response"]) # For SFT training: build messages def to_messages(row): return {"messages": [ {"role": "system", "content": row["system_prompt"]}, {"role": "user", "content": row["user_prompt"]}, {"role": "assistant", "content": row["response"]}, ]} sft_ds = ds["train"].map(to_messages) ``` ## Generated by [TorchTrade](https://github.com/TorchTrade/torchtrade) using `generate_traces_local.py` with batched vLLM inference on DGX Spark.
许可证:MIT 任务类别: - 强化学习 标签: - 交易 - 推理轨迹 - 大语言模型(LLM) - 比特币 - TorchTrade - Gemma-4 - NVFP4 样本规模:1K<n<10K # BTC推理轨迹:Gemma 4 31B(2021年5月 - 2022年5月) 本数据集包含BTC/USD小时级交易决策的大语言模型推理轨迹,由**nvidia/Gemma-4-31B-IT-NVFP4**通过vLLM在DGX Spark本地运行生成。每一行对应一条小时级交易决策,包含完整的思维链推理过程。 ## 生成流程 | 字段 | 取值 | |---|---| | 教师模型 | `nvidia/Gemma-4-31B-IT-NVFP4`(307亿参数,采用NVFP4量化) | | 推理引擎 | DGX Spark(128GB统一显存,GB10架构)上的vLLM 0.19.1 | | 温度系数 | 0.6 | | 提示格式 | 紧凑格式(增量编码OHLCV数据,单提示约400个Token) | | 批量大小 | 64个并行任务 | | 吞吐量 | 约370-390 tok/s | | 总轨迹数 | 8928条 | | 有效动作率 | 100.0% | ## 数据覆盖范围 **8928条小时级交易决策**覆盖约1年的BTC/USD永续合约市场: | 时段 | UTC日期范围 | |---|---| | 起始时间 | 2021-05-01T00:00:00 | | 结束时间 | 2022-05-07T23:00:00 | 源数据集:[`Torch-Trade/btcusdt_perp_1m_05_2021_to_02_2026`](https://huggingface.co/datasets/Torch-Trade/btcusdt_perp_1m_05_2021_to_02_2026) ## 环境配置 | 参数 | 取值 | |---|---| | 交易标的 | BTC/USD | | 执行周期 | 1小时(每小时生成一次交易决策) | | 动作空间 | `[-1, 0, 1]`(分别对应做空、平仓、做多) | | 杠杆倍数 | 3倍 | | 初始资金 | 10000美元 | | 观测数据 | 12根5分钟K线+24根1小时K线的OHLCV数据(紧凑增量编码格式) | ## 动作分布 | 动作 | 数量 | 占比 | |---|---|---| | 0(做空) | 4592 | 51.4% | | 1(平仓) | 1080 | 12.1% | | 2(做多) | 3256 | 36.5% | ## 字段说明 | 列名 | 数据类型 | 说明 | |---|---|---| | `timestamp` | 字符串 | 交易决策的ISO格式时间戳 | | `system_prompt` | 字符串 | 交易智能体的系统指令 | | `user_prompt` | 字符串 | 紧凑增量编码的OHLCV数据与账户状态 | | `response` | 字符串 | 完整的`<think>推理过程</think><answer>N</answer>`格式输出 | | `action` | 整数 | 提取得到的交易动作(0=做空,1=平仓,2=做多) | | `reward` | 浮点数 | 执行该动作后获得的奖励 | ## 使用示例 python from datasets import load_dataset ds = load_dataset("Torch-Trade/btc-reasoning-traces-05_2021-05_2022-gemma4-31B") # 浏览单条推理轨迹 row = ds["train"][42] print(row["response"]) # 用于监督微调训练:构建对话消息格式 def to_messages(row): return {"messages": [ {"role": "system", "content": row["system_prompt"]}, {"role": "user", "content": row["user_prompt"]}, {"role": "assistant", "content": row["response"]}, ]} sft_ds = ds["train"].map(to_messages) ## 生成方 由[TorchTrade](https://github.com/TorchTrade/torchtrade)通过`generate_traces_local.py`脚本,在DGX Spark上使用批量vLLM推理生成。