translations
收藏资源简介:
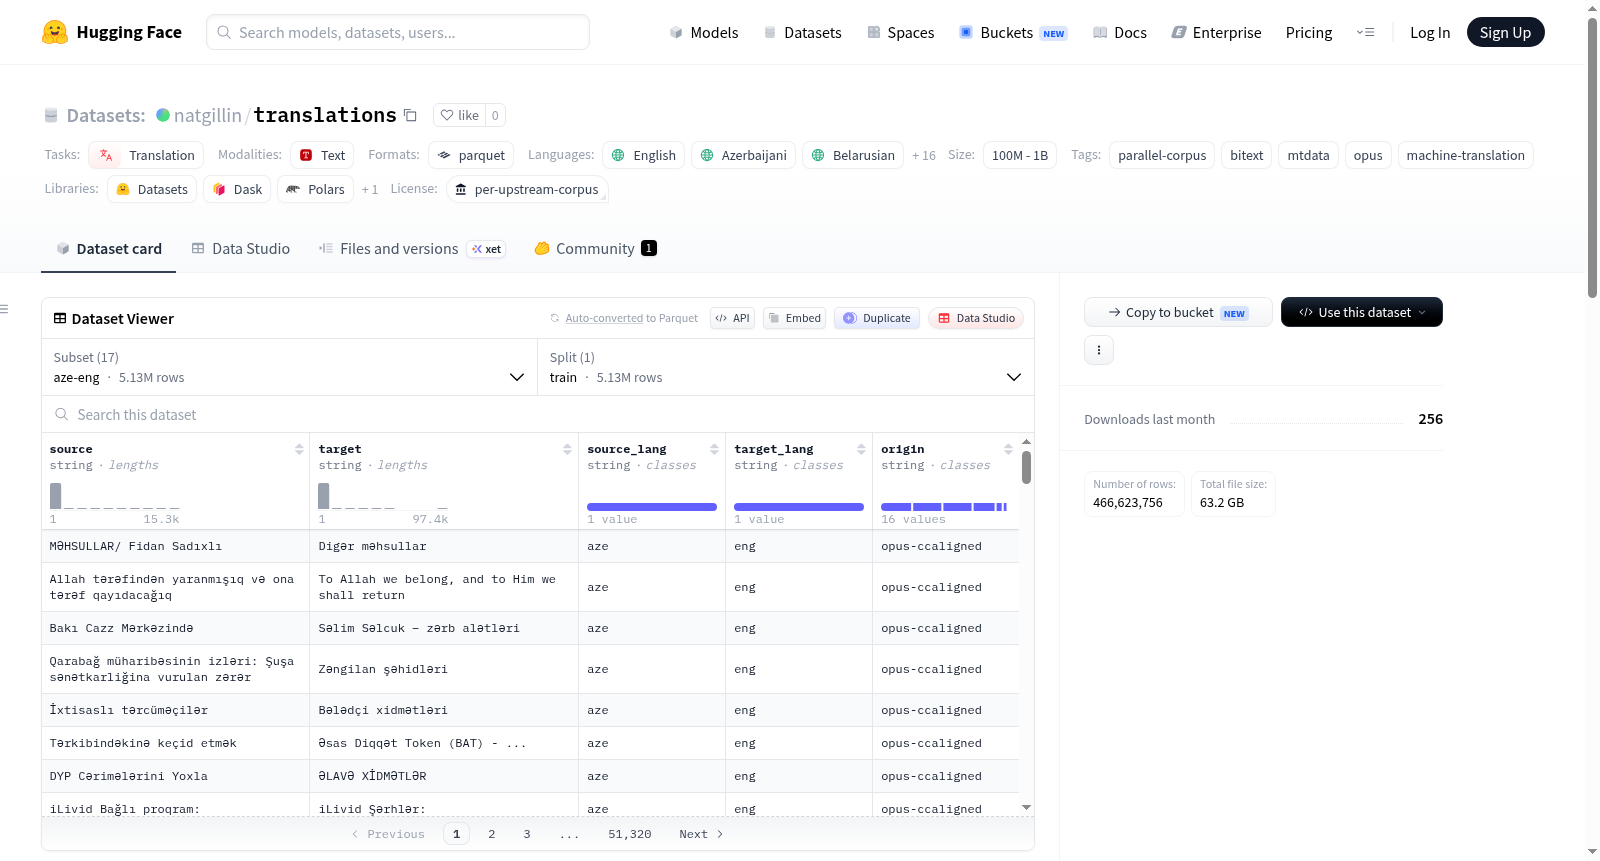
Translations 是一个平行双语语料库,专为机器翻译任务设计,采用Parquet格式,从上游mtdata和OPUS版本汇编而成。该数据集覆盖英语与多种语言(如阿塞拜疆语、白俄罗斯语、保加利亚语、加泰罗尼亚语、丹麦语、爱沙尼亚语、芬兰语、古吉拉特语、匈牙利语、卡纳达语、马拉雅拉姆语、挪威语、奥里亚语、旁遮普语、罗马尼亚语、斯洛伐克语、泰米尔语、乌尔都语)之间的翻译对,数据规模在1亿至10亿个token之间。数据以语言对为单位组织,每个语言对(例如aze-eng, bel-eng)对应一个配置,包含训练集文件。每个数据样本包含五个字段:源语言句子(source)、目标语言句子(target)、源语言代码(source_lang,ISO 639-3)、目标语言代码(target_lang,ISO 639-3)以及标识上游具体子语料来源的origin字段(例如opus-ccmatrix, opus-nllb, mtdata-merged等)。源语言和目标语言的顺序根据其ISO 639-3代码按字母顺序固定,以确保数据对的一致性和明确性。数据集遵循其上游OPUS来源的各自许可证。
The Translations parallel bilingual corpus is purpose-built for machine translation tasks, stored in Parquet format, and compiled from upstream mtdata and OPUS datasets. This corpus covers translation pairs between English and a wide range of languages including Azerbaijani, Belarusian, Bulgarian, Catalan, Danish, Estonian, Finnish, Gujarati, Hungarian, Kannada, Malayalam, Norwegian, Odia, Punjabi, Romanian, Slovak, Tamil, and Urdu, with a total size ranging from 100 million to 1 billion tokens. The dataset is organized by language pairs, where each pair (e.g., aze-eng, bel-eng) corresponds to a configuration that includes training set files. Each data sample contains five fields: the source language sentence ("source"), the target language sentence ("target"), the source language code ("source_lang", ISO 639-3 standard), the target language code ("target_lang", ISO 639-3 standard), and the "origin" field that identifies the specific upstream sub-corpus source (e.g., opus-ccmatrix, opus-nllb, mtdata-merged, etc.). The order of the source and target languages is fixed alphabetically based on their ISO 639-3 codes to ensure the consistency and clarity of the translation pairs. This dataset adheres to the respective licenses of its upstream OPUS sources.
数据集概述
数据集名称:natgillin/translations
地址:https://huggingface.co/datasets/natgillin/translations
许可证:其他(遵循上游语料库的许可条款,关联 OPUS 来源许可)
任务与语言
- 任务类型:翻译(Translation)
- 支持语言:
- 源语言(19种):英语(en)、阿塞拜疆语(az)、白俄罗斯语(be)、保加利亚语(bg)、加泰罗尼亚语(ca)、丹麦语(da)、爱沙尼亚语(et)、芬兰语(fi)、古吉拉特语(gu)、匈牙利语(hu)、卡纳达语(kn)、马拉雅拉姆语(ml)、挪威语(no)、奥里亚语(or)、旁遮普语(pa)、罗马尼亚语(ro)、斯洛伐克语(sk)、泰米尔语(ta)、乌尔都语(ur)
- 数据配对方向:所有配对均按 ISO 639-3 代码的字母顺序固定方向(例如
bel在eng之前,cat在eng之前),确保配对名称确定性且双向连接无歧义。
数据集规模
- 大小类别:100M < n < 1B 条记录
数据构成与模式
- 列结构:
| 列名 | 类型 | 描述 |
|---|---|---|
source |
字符串 | 源语言句子 |
target |
字符串 | 目标语言句子 |
source_lang |
字符串 | 源语言,ISO 639-3 三位字母代码(如 bel, cat, eng) |
target_lang |
字符串 | 目标语言,ISO 639-3 三位字母代码 |
origin |
字符串 | 上游子语料库标识(如 opus-ccmatrix, opus-nllb, mtdata-merged 等) |
- 文件格式:Parquet
- 数据分割:所有语言配对均固定为
train拆分,避免自动检测测试拆分。
配置与布局
-
配置方式:每个语言对对应一个配置(config),配置名称如
aze-eng、bel-eng等。共包含 17 个配置:aze-eng(阿塞拜疆语-英语)bel-eng(白俄罗斯语-英语)bul-eng(保加利亚语-英语)cat-eng(加泰罗尼亚语-英语)dan-eng(丹麦语-英语)eng-est(英语-爱沙尼亚语)eng-fin(英语-芬兰语)eng-guj(英语-古吉拉特语)eng-hun(英语-匈牙利语)eng-kan(英语-卡纳达语)eng-mal(英语-马拉雅拉姆语)eng-ori(英语-奥里亚语)eng-pan(英语-旁遮普语)eng-ron(英语-罗马尼亚语)eng-slk(英语-斯洛伐克语)eng-tam(英语-泰米尔语)eng-urd(英语-乌尔都语)
-
文件目录结构示例:
data/ cat-eng/ opus-ccmatrix-00000-of-00200.parquet opus-nllb-00000-of-00200.parquet ... bel-eng/ ...
数据来源
- 上游来源:由 mtdata / OPUS 发布的双语平行语料库汇编而成。
origin列常见值:mtdata-merged— mtdata 为配对去重合并的双语文本opus-<source>— 上游 OPUS 子语料库(如opus-ccmatrix、opus-nllb、opus-ccaligned、opus-multiccaligned、opus-wikimatrix、opus-eubookshop、opus-kde4、opus-gnome、opus-neulab-tedtalks、opus-elrc-*、opus-tatoeba、opus-ted2020等)elr— ELRA / ELR 特定片段unknown— 无法匹配已知 OPUS 模式的 URL 行
许可证与引用
- 许可证:继承自上游 OPUS 来源的语料库许可条款。
- 引用要求:引用 OPUS 原始来源(https://opus.nlpl.eu)。