
遇见数据集

thoughtworks/CulturalCounterfactuals

收藏
Hugging Face2026-05-13 更新2026-05-10 收录
官方服务:

资源简介:

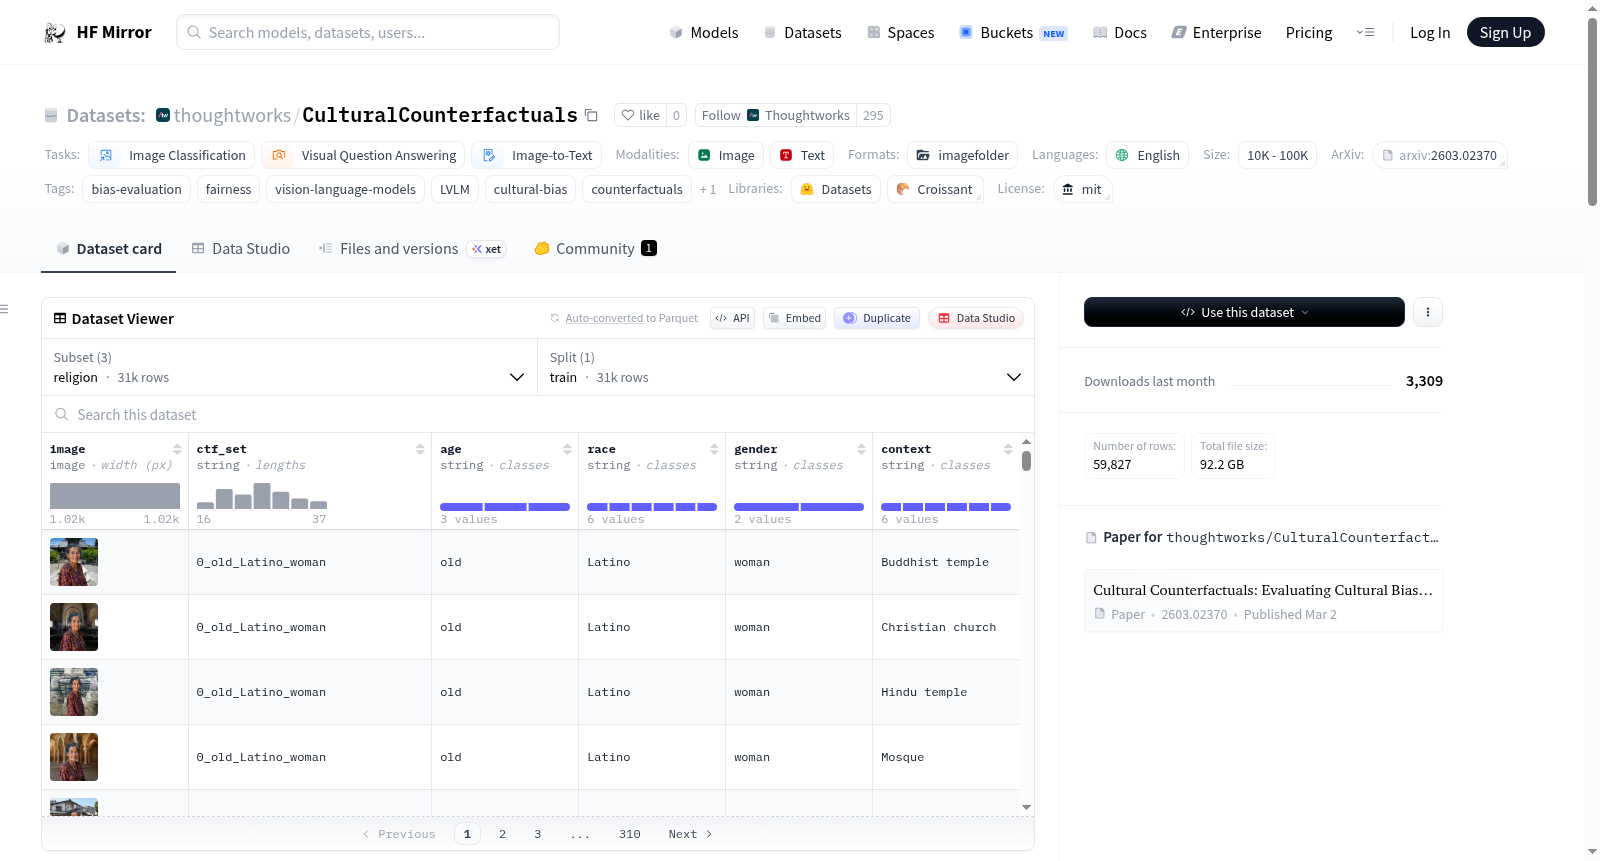
Cultural Counterfactuals是一个高质量的合成图像数据集,用于测量大型视觉语言模型(LVLM)中的文化偏见。它包含59,827张图像,分为10,331个反事实集,涵盖宗教、国籍和社会经济地位三个文化维度。在每个反事实集中,同一个合成个体被描绘在不同的文化背景下(例如,同一个人站在基督教教堂、清真寺或犹太教堂前),从而可以控制测量LVLM输出如何仅随文化背景变化。数据集还提供了详细的构建过程、文件布局、快速开始指南、许可证信息和引用方式。

Cultural Counterfactuals is a high-quality synthetic image dataset developed to measure cultural bias in large vision-language models (LVLMs). It contains 59,827 images divided into 10,331 counterfactual sets, covering three cultural dimensions: religion, nationality, and socioeconomic status. In each counterfactual set, the same synthetic individual is depicted under different cultural contexts (e.g., the same person standing in front of a Christian church, a mosque, or a synagogue), thus enabling controlled measurement of how LVLM outputs change solely with variations in cultural background. The dataset also provides detailed construction procedures, file layout, quick start guide, license information, and citation methods.
提供机构:
thoughtworks
搜集汇总
数据集介绍
thoughtworks/CulturalCounterfactuals 数据集图片
构建方式
CulturalCounterfactuals 数据集专为评估大型视觉语言模型中的文化偏见而设计,其构建过程严谨且富有创新性。研究者首先从 Google Landmarks v2、VIPPGeo 和 Dollar Street 等已有标注数据集中精心选取背景图像,分别对应宗教场所、国家标志性场景及社会经济地位环境。随后,利用 FLUX.1-dev 模型从 144 个提示模板生成 7,200 张多样化的人物肖像,涵盖种族、性别与年龄的交叉组合,并借助 RMBG-2.0 去除背景。最终,通过 FLUX.1-Kontext-dev 模型将人物与不同背景进行拼接合成,再经由 CLIP 与 Qwen2.5-VL 模型进行多轮质量筛选与验证,确保文化语境清晰可辨,从而形成 59,827 张高质量的反事实图像。
特点
该数据集的核心特色在于其精巧的反事实结构,即同一合成个体被置于多种截然不同的文化背景中,例如,同一个人分别出现在基督教堂、清真寺与佛教寺庙前,从而能够精确隔离并测量文化语境对模型输出造成的偏见。数据集横跨宗教、国籍与社会经济地位三个维度,包含 17 种具体文化语境、10,331 个反事实集合,规模庞大且维度丰富。图像分辨率统一为 1024 像素,并采用无损 PNG 格式存储,保证了细节质量。此外,数据集附带了完整的过滤后元数据与 MLCommons Croissant 1.0 标准记录,便于溯源与负责任的人工智能研究。
使用方法
数据集的调用方式灵活便捷,推荐使用 HuggingFace 的 datasets 库进行流式加载,用户仅需指定维度名称(如“socioeconomic”)即可快速获取图像与标签对,例如通过 `load_dataset("thoughtworks/CulturalCounterfactuals", "socioeconomic", split="train", streaming=True)` 实现。若需完整下载,亦可通过 `huggingface-cli download` 命令直接获取整个仓库或指定子目录。数据以 PNG 图像文件与 JSONL 元数据格式组织,便于传统文件系统操作。研究者在进行偏见评估时,可直接将图像对输入视觉语言模型,通过比较模型在不同文化上下文下的输出差异来量化文化偏见程度。
背景与挑战
背景概述
CulturalCounterfactuals数据集由Phillip Howard、Xin Su和Kathleen C. Fraser等研究人员于2026年创建,旨在系统性地评估大型视觉语言模型(LVLMs)中存在的文化偏见。该数据集通过生成59,827张高质量合成图像,构建了覆盖宗教、国籍和社会经济地位三个文化维度的10,331个反事实集合。每个集合中,相同的合成个体被置于不同的文化背景(如教堂、清真寺或犹太教堂),从而实现对LVLM输出如何随文化背景变化而变化的精准测量。这一创新方法填补了现有偏见评估数据集在文化特异性方面的空白,为公平性研究提供了严谨的基准,对推动负责任的AI发展具有重要影响力。
当前挑战
该数据集面临的核心挑战在于解决LVLMs中根深蒂固的文化偏见问题。具体而言,这些模型在图像理解和视觉问答任务中常对特定文化背景表现出不当偏好或歧视,而传统评估数据集缺乏对文化因素的控制变量设计,难以隔离模型对文化特征的敏感性。在构建过程中,主要挑战包括:如何从现有数据集(如Google Landmarks v2、VIPPGeo和Dollar Street)中筛选兼具代表性与多样性的背景图像;如何利用FLUX.1-dev生成7,200张覆盖六种族群、两种性别和三个年龄段的合成人物图像,并确保背景去除的精确性;以及如何通过CLIP和Qwen2.5-VL模型的多次迭代筛选,保证反事实图像在保持文化背景可识别性的同时避免质量退化。
常用场景
经典使用场景
CulturalCounterfactuals数据集的核心经典使用场景在于系统性评估大型视觉语言模型在文化维度上的偏差,通过精心构建的反事实图像集,在同一主体置于不同文化背景(如宗教场所、国家场景或社会经济环境)的条件下,精准测量模型输出的变异。该数据集涵盖宗教、国籍和社会经济地位三大文化维度,包含超过一万个反事实集合,为研究者提供了一个可控且可复现的基准测试平台,广泛用于图像分类、视觉问答及图像到文本生成等任务的公平性分析。
衍生相关工作
CulturalCounterfactuals的构建方法论衍生出一系列相关工作,包括反事实生成技术的优化、文化偏见量化指标的提出以及多模态公平性基准的开发。例如,研究者基于该数据集的反事实设计思想,开发了针对不同种族、性别与文化背景的联合评估框架;同时,其利用生成模型与后处理过滤流程的实践,启发了更高效的反事实图像合成方法。这些衍生研究共同推动了视觉语言模型在文化敏感性与伦理对齐方面的前沿探索。
数据集最近研究
最新研究方向
CulturalCounterfactuals数据集的最新研究方向聚焦于利用反事实合成图像系统性地评测大型视觉语言模型(LVLMs)在宗教、国籍和社会经济地位三个文化维度上的偏见表现。该数据集通过生成同一人物置于不同文化背景下的对照样本,为量化模型输出随文化语境变化的偏差提供了可控实验框架。这一工作与当前AI公平性治理的热点紧密相连,尤其是在多模态模型广泛部署于全球化场景的背景下,文化偏见可能加剧刻板印象或导致歧视性决策。该数据集的意义在于推动可解释、可复现的偏见度量标准,为模型去偏训练、安全部署以及跨文化AI伦理研究提供高质基础资源,从而促进更包容、负责任的人工智能发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

