
mctd-opd-cache
收藏官方服务:
资源简介:
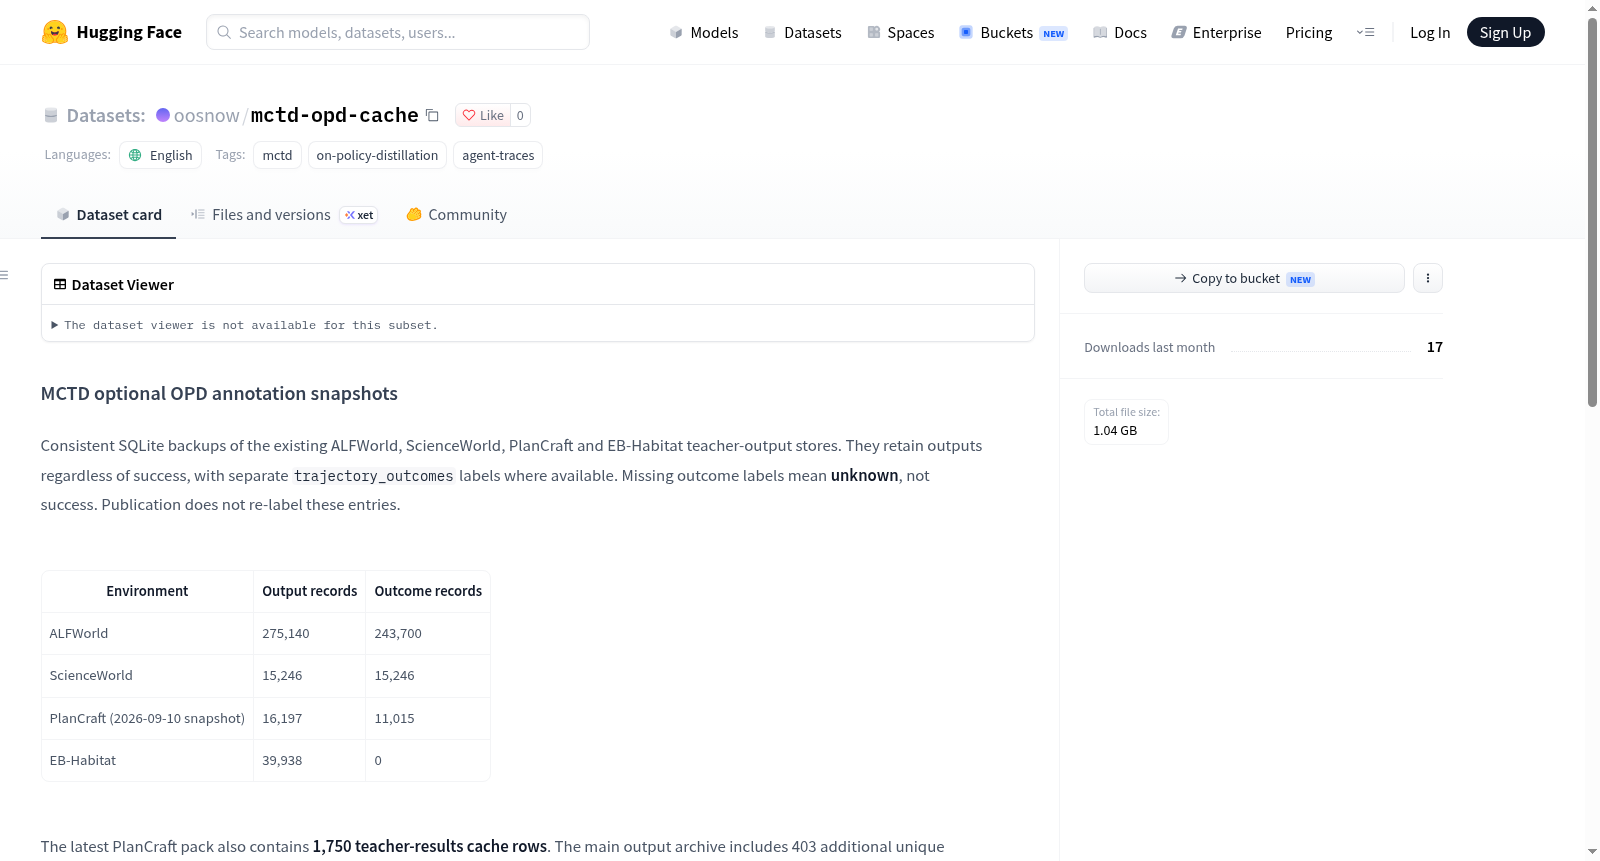
本数据集为 MCTD 可选的 OPD 标注快照,由 ALFWorld、ScienceWorld、PlanCraft 和 EB-Habitat 四种环境的教师输出存储的 SQLite 数据库备份组成。数据集保留了所有成功的和失败的输出,并附有独立的 `trajectory_outcomes` 标签(缺失标签表示结果未知,而非成功)。各环境输出记录数分别为:ALFWorld 275,140 条(含结果标签 243,700 条)、ScienceWorld 15,246 条(全部含结果标签)、PlanCraft(2026-09-10 快照)16,197 条(含结果标签 11,015 条)、EB-Habitat 39,938 条(无单独轨迹结果标签)。最新 PlanCraft 包还包含 1,750 条教师结果缓存行。数据集主要用于基于策略蒸馏(OPD)的训练加速,作为可选缓存输入,而非仅成功的监督微调数据。用户可通过 `download_resources.py` 脚本下载。复用时应遵守合约:保留原始命名空间、上下文、负载键、来源、质量标志和结果;不保证所有历史输出都能命中缓存;EB-Habitat 的输出结果未知,不得绕过结果感知的重用规则。
创建时间:
2026-09-08
搜集汇总
数据集介绍
构建方式
该数据集源自MCTD强化学习框架下的在线策略蒸馏流程,旨在为智能体训练提供可复用的教师输出缓存。构建过程以ALFWorld、ScienceWorld、PlanCraft及EB-Habitat四个交互式环境为数据采集场域,将教师模型生成的轨迹输出与对应的结果标签分别持久化至SQLite数据库,形成结构化的缓存快照。导出环节实施SQLite完整性校验、SHA-256哈希验证以及归档清单核对,确保数据在传输与存储过程中的一致性与可追溯性。各环境输出记录数量不等,其中ALFWorld规模最大,包含超过27万条输出记录与24万余条结果记录;PlanCraft快照额外收录了1750条教师结果缓存及来自早期Qwen3.8归档的403条唯一输出,以补充历史数据覆盖。
特点
该数据集的核心特征在于对教师输出与轨迹结果进行分离存储,并明确区分已知结果与未知结果标签。输出记录与结果记录并非严格一一对应,同一上下文可能对应多条结果与多个回合结局,保留了原始命名空间、上下文键、载荷键、来源信息及质量标志。值得注意的是,EB-Habitat快照不包含独立的结果标签,其条目属于未知结果输出,不得据此推断轨迹成功或失败。数据集刻意省略了重复的静态成功索引,相关索引由训练代码从教师数据集动态重建,从而避免冗余存储。这些缓存被定位为可选的加速输入,而非仅含成功样本的监督微调数据,其重用需遵循结果感知的重用规则与奖励加权机制。
使用方法
使用者可通过执行下载脚本并指定环境参数与缓存选项,将不可变的SQLite数据库安装至指定快照目录下。在线策略蒸馏工作流在首次使用时基于这些缓存播种独立可写的运行时存储,已有的实时缓存不会被下载内容覆盖。需特别留意的是,历史路径或模型契约差异可能导致缓存命中失败,快照并不保证所有历史输出均可在另一台机器上复用,不兼容的条目不得强行重用。模型管理标签不应被视为实际生成器的证明,原始后端来源须予以保留。文件不包含模型权重、API凭证或训练优化器状态,环境衍生材料的使用仍需遵循上游提供方的适用条款。
背景与挑战
背景概述
面向具身智能体与交互式决策研究的持续进展,跨环境策略学习对高质量行为轨迹的依赖日益显著。mctd-opd-cache数据集由相关研究团队于2026年前后构建,汇集ALFWorld、ScienceWorld、PlanCraft与EB-Habitat四类环境的教师输出缓存,涵盖逾三十万条输出记录与二十余万条结果标注,并以SQLite快照形式固化。该数据集聚焦在线策略蒸馏中的结果感知复用与奖励加权问题,为智能体轨迹的监督信号管理、缓存一致性与可复现训练提供了重要基础设施,对交互式学习与具身智能体研究具有支撑意义。
当前挑战
该数据集所应对的核心难题在于交互式环境中稀疏奖励与结果标注不完整条件下的策略蒸馏稳定性,其覆盖的ALFWorld、ScienceWorld、PlanCraft与EB-Habitat任务在状态空间、动作语义与任务复杂度上差异显著,致使跨环境泛化与轨迹复用面临本质困难。构建层面,输出与结果记录并非一一对应,同一上下文可能对应多组结果与回合结局,且部分快照完全缺失结果标签,需依赖命名空间、上下文与载荷键的原样保留及来源追溯加以甄别;历史路径与模型契约差异还会阻碍缓存命中,因此导出过程须经SQLite完整性校验、SHA-256与归档清单核验,以确保数据可靠且不被误用。
常用场景
经典使用场景
在智能体策略优化与知识蒸馏的研究中,mctd-opd-cache数据集充当着on-policy蒸馏流程里的缓存基石,为ALFWorld、ScienceWorld、PlanCraft与EB-Habitat四类交互环境提供了教师模型输出及其轨迹结局的持久化快照。研究者可依托该缓存加速教师输出的复用与检索,在保持原始命名空间、上下文及载荷键值不变的前提下,结合结局感知的重用规则与奖励加权机制,对策略模型开展高效蒸馏训练。该数据集尤其适用于需要大量教师交互轨迹、但重复计算代价高昂的强化学习与语言智能体实验场景。
实际应用
在实际应用中,mctd-opd-cache为语言智能体训练框架提供了可下载、可校验的教师输出缓存,覆盖ALFWorld等四个基准环境,显著缩减重复调用教师模型所产生的算力开销。开发者通过运行下载脚本即可将不可变数据库安装至指定目录,并在此基础上派生出可写的运行时存储。该数据集以可选的加速输入形式融入现有蒸馏工作流,适用于需要频繁复用历史教师结果、同时严格维持结局感知重用策略的工程实践。
衍生相关工作
围绕mctd-opd-cache,已有工作衍生出与之配套的教师数据集oosnow/mctd-data,负责从教师数据中重建重复的静态成功索引,并单独发布成功的静态轨迹。缓存快照本身则作为可选加速输入,与主训练代码形成互补。相关衍生实践包括PlanCraft快照的版本化更新、早期Qwen3.8归档输出的合并保留,以及依据清单计数进行一致性校验的导出流程,共同构成结局感知蒸馏方法在多种环境下的可复用基础设施。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


