
DEMO_DATASET
收藏官方服务:
资源简介:
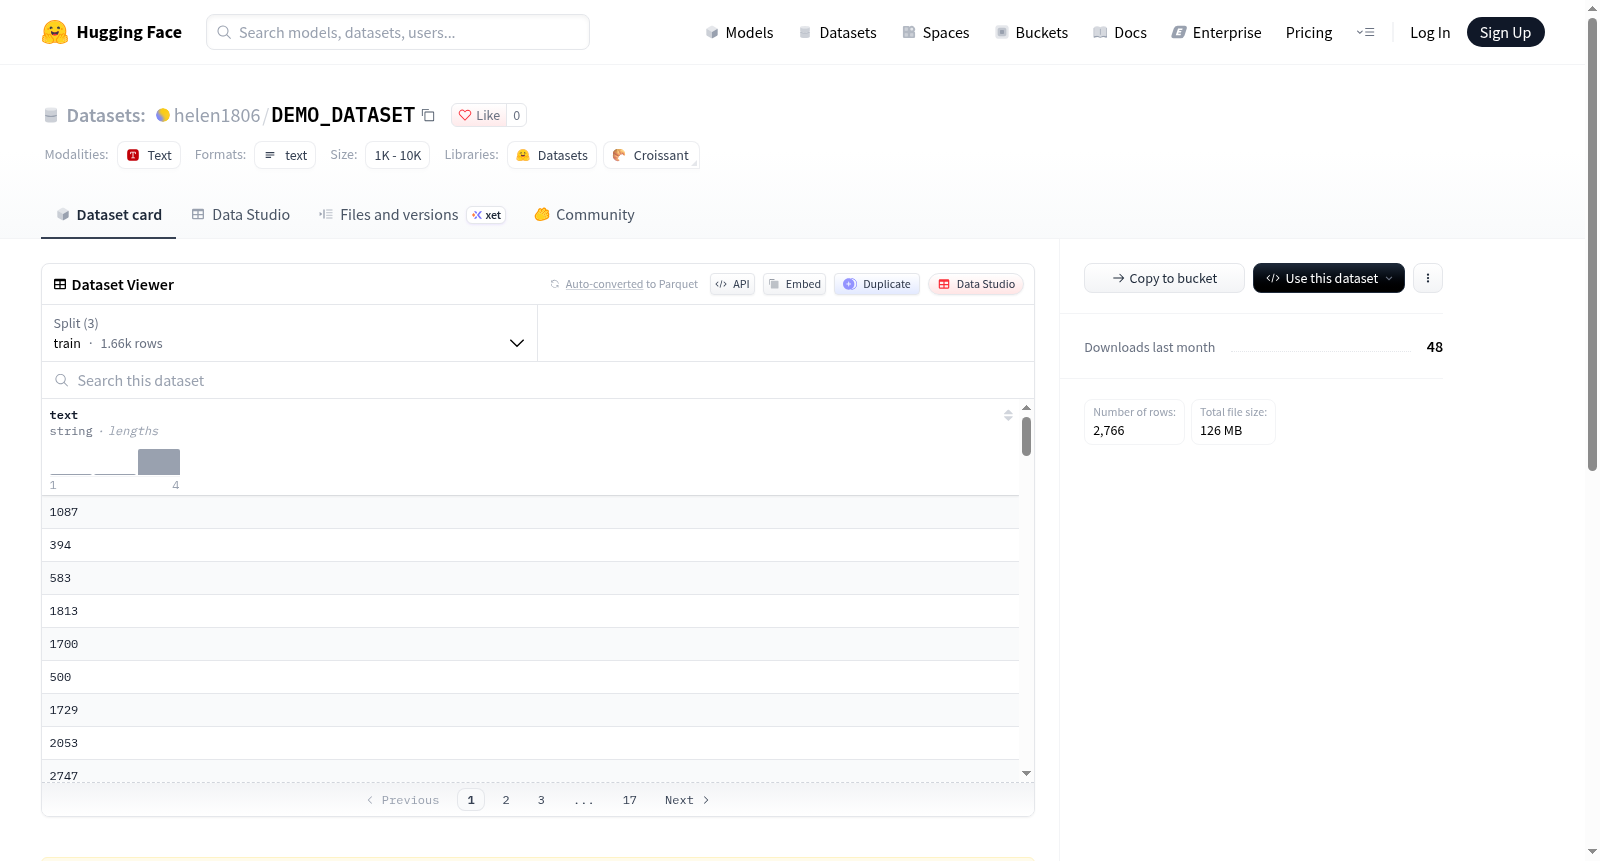
G-Retriever GQA Demo Subset 是一个用于图检索应用原型的小型数据集,包含 GQA 场景图的一个子集。该数据集并非完整的 GQA 数据集,而是小规模原型子集。其内容包括:graphs/ 目录保存 PyTorch Geometric 图对象,这些图对象包含 SBERT 节点嵌入和边嵌入;nodes/ 目录以 CSV 文件形式提供文本节点描述;edges/ 目录以 CSV 文件形式提供文本边描述;graph_summary.csv 提供每个图的节点数和边数统计;questions.csv 包含选定的问题和参考答案;sceneGraphs_subset.json 保存选定的原始场景图。数据集使用的嵌入模型为 sentence-transformers/all-roberta-large-v1,嵌入维度为 1024。该数据集适用于图检索、场景图相关实验或原型系统开发,并可结合节点与边的文本描述、图结构、问题及参考答案进行使用。
创建时间:
2026-10-23
原始信息汇总
G-Retriever GQA Demo Subset 数据集概述
- 数据集名称:G-Retriever GQA Demo Subset
- 数据集地址:https://huggingface.co/datasets/helen1806/DEMO_DATASET
- 数据集简介:包含 GQA 场景图的小型子集,用于原型图检索应用。
- 数据集性质:小型原型子集,不是完整 GQA 数据集。
内容组成
| 内容项 | 说明 |
|---|---|
| graphs | PyTorch Geometric 图对象,包含 SBERT 节点嵌入和边嵌入 |
| nodes | 文本节点描述,以 CSV 文件形式提供 |
| edges | 文本边描述,以 CSV 文件形式提供 |
| graph_summary.csv | 每个图的节点数量和边数量 |
| questions.csv | 选定的问题及参考答案 |
| sceneGraphs_subset.json | 选定的原始场景图 |
嵌入信息
- 嵌入模型:sentence-transformers/all-roberta-large-v1
- 嵌入维度:1024
说明
- 该数据集为小型原型子集。
- 该数据集不是完整的 GQA 数据集。
搜集汇总
数据集介绍
构建方式
在图神经网络与结构化场景理解研究日益倚重真实场景图资源的背景下,本数据集从GQA场景图体系中筛选出小规模子集,以支撑图检索原型验证。构建过程将原始场景图转换为PyTorch Geometric图对象,并保留节点与边的文本描述,分别整理为CSV文件。节点和边描述经由sentence-transformers/all-roberta-large-v1编码,生成维度为1024的SBERT嵌入,使图结构获得语义化表征。同步汇总每图的节点与边计数、选定问题及参考答案,并保存sceneGraphs_subset.json作为原始场景图记录。该子集并非完整GQA数据集,而是面向原型开发的抽样版本。
使用方法
在图检索系统开发与图问答模型评估中,该数据集可按照图结构、文本描述与嵌入向量三条线索联合使用。研究者可借助PyTorch Geometric加载graphs目录中的图对象,并读取nodes与edges目录下的CSV文件,以还原节点和边的语义信息。questions.csv提供问题与参考答案,可用于检索增强生成或问答准确率评测;graph_summary.csv有助于快速把握各图规模。sceneGraphs_subset.json保留原始场景图,便于与预处理结果对照。使用时需注意其为原型子集,结果解释应限定于该抽样范围,并遵循相应模型与数据的许可要求。
背景与挑战
背景概述
在视觉问答与结构化场景图推理深度耦合的背景下,DEMO_DATASET作为G-Retriever的GQA演示子集,聚焦图检索增强生成的原型验证。GQA源自Visual Genome场景图,由斯坦福大学等机构于2019年提出,旨在检验组合式视觉理解与多跳推理;该子集未在README中标注确切创建时间与主要研究人员,但可辨识其服务于G-Retriever相关研究脉络。其收录PyTorch Geometric图对象、SBERT节点与边嵌入(维度1024)、文本描述、图摘要、问题答案及原始场景图,为语言模型与图神经网络的协同提供轻量实验载体。影响力体现在降低图检索问答复现门槛,推动文本图理解、检索增强生成与可解释推理的交叉探索。
当前挑战
在图检索问答领域,核心难题在于从大规模场景图中精准定位与问题相关的子图,并完成跨节点、跨边的多跳语义聚合与答案生成。构建该演示子集时,因仅抽取完整GQA的微小片段,需兼顾图结构完整性、问题覆盖度与嵌入质量;将场景图转换为PyTorch Geometric对象并以all-roberta-large-v1生成1024维节点边嵌入,亦面临语义对齐、计算成本与噪声传播等制约。其规模有限,难以充分反映完整GQA的分布多样性与长尾现象,评估结论外推需谨慎,且原型检索性能对子图抽样策略与文本化质量较为敏感。
常用场景
经典使用场景
在场景图问答与图检索增强生成研究脉络中,该数据集以GQA场景图小型子集为依托,将PyTorch Geometric图对象、SBERT节点与边嵌入、文本化节点边描述、问题及参考答案整合为统一试验床。其经典用途在于验证图检索器能否从结构化场景图中召回与自然语言问题相关的子图,并借助1024维all-roberta-large-v1嵌入实现节点与边的语义匹配。研究者可据此测试图神经网络、图Transformer与检索增强生成管线在视觉场景推理中的协同效果,涵盖图构建、子图检索、证据聚合与答案生成等环节。
解决学术问题
面对文本图理解与视觉问答中结构信息难以被大语言模型有效利用的问题,该数据集提供了可复现的小规模场景图问答样本,用以探究图结构检索、跨模态语义对齐与可解释推理等学术议题。它缓解了完整GQA体量较大、处理成本较高且图文本转换流程复杂所带来的实验门槛,使研究者能够在受控条件下比较不同图编码器、检索策略与生成模型的性能。其意义在于推动检索增强生成从纯文本片段扩展到节点边构成的图证据,为场景图问答、图推理与多跳关系理解提供基准化验证路径,并增强答案依据的可追踪性。
实际应用
在智能视觉助手、机器人环境理解与多模态问答系统等实际场景中,该数据集可支撑原型级图检索问答流程的搭建与评估。系统先以场景图表达图像中的对象、属性与关系,再利用节点边文本描述和SBERT嵌入检索与用户问题相关的子图,随后将子图证据输入语言模型生成回答。此类应用有助于提升视觉问答对复杂关系、空间配置和属性约束的处理能力,也可用于教学演示、算法快速验证与低资源条件下的检索增强生成系统调试。由于该数据集仅为小型原型子集,实际部署仍需完整GQA或领域数据扩展,以保障覆盖度与稳健性。
数据集最近研究
最新研究方向
伴随多模态大模型与图检索增强生成范式交汇,GQA场景图正成为衔接视觉感知与符号推理的关键结构化知识载体。基于该演示子集,近期研究聚焦于以SBERT节点与边嵌入驱动的可微图检索,探索面向视觉问答的子图召回、图神经网络与语言模型协同推理,以及可解释证据链构建。相关热点涵盖Graph RAG、跨模态图基础模型与组合泛化基准。该方向有望缓解大模型幻觉,增强场景图问答的透明性与迁移能力,并为小样本原型验证提供可复现的图数据接口。
以上内容由遇见数据集搜集并总结生成


