Srilankan-Tamil-NER
收藏资源简介:
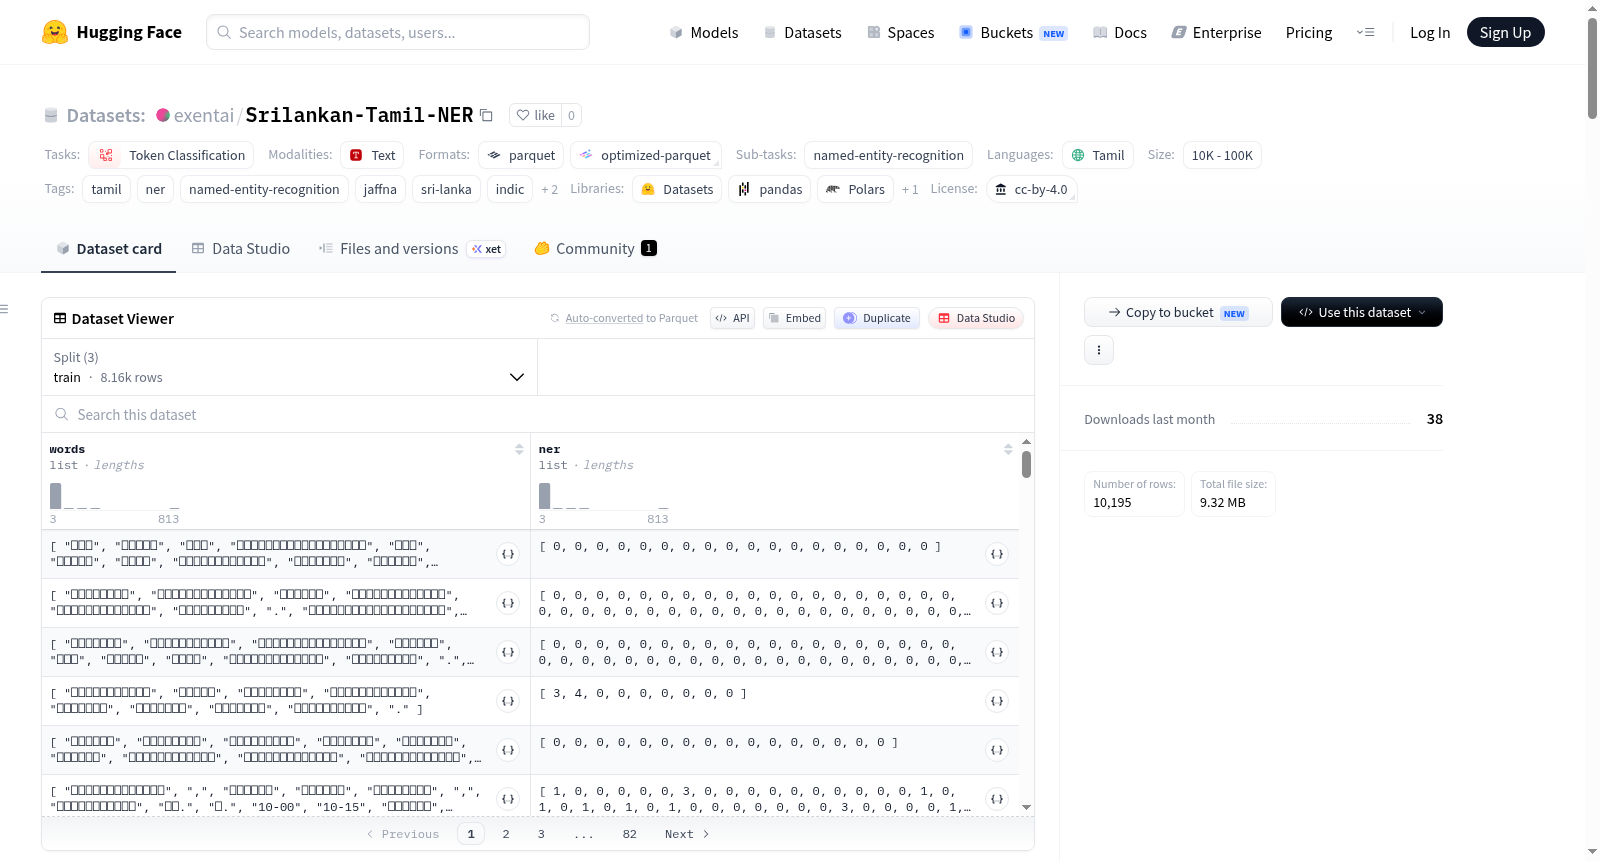
斯里兰卡泰米尔语命名实体识别(NER)数据集是一个高质量、专门针对斯里兰卡(贾夫纳)地区语境的泰米尔语命名实体识别数据集。该数据集由ExentAI构建和整理,旨在补充通用印度语言NER模型在识别斯里兰卡地名、泰米尔组织及地区人物等实体方面的不足,适用于低资源泰米尔语NLP研究。数据集包含10,195个经过精心标注的句子,总计16,012个命名实体,其中50%的句子至少包含一个命名实体。数据来源于15本泰米尔文学与历史书籍(6,393句)以及一个地区新闻和文档语料库(3,802句)。数据采用IOB2标注格式,严格遵循与`ai4bharat/IndicNER`兼容的Naamapadam标签模式,包含三类实体:人物(PER)、地点(LOC)和组织(ORG)。数据结构包含三个字段:唯一句子ID(`id`)、词元列表(`words`)和对应的整数标签ID列表(`ner`)。数据集已预先划分为训练集(约8,156句)、验证集(约1,020句)和测试集(约1,019句)。数据质量方面,该数据集经过严格验证,确保零BIO序列错误,修复了孤立的`I-`标签和连续的`B-`标签链,并强制执行了每句最大50个词元的长度限制。其主要用于微调面向斯里兰卡泰米尔文本的Indic NER模型,提升贾夫纳地区泰米尔文档的实体检测能力,以及构建泰米尔文档处理与知识图谱管道。
The Sri Lankan Tamil Named Entity Recognition (NER) dataset is a high-quality, context-specific Tamil NER dataset tailored for the Sri Lankan (Jaffna) regional context. This dataset was constructed and curated by ExentAI, aiming to address the shortcomings of general-purpose Indian language NER models in recognizing entities such as Sri Lankan toponyms, Tamil organizations, and regional figures, and is suitable for low-resource Tamil NLP research. The dataset contains 10,195 meticulously annotated sentences, totaling 16,012 named entities, with 50% of the sentences containing at least one named entity. The data is sourced from 15 Tamil literary and historical books (6,393 sentences) and a regional news and document corpus (3,802 sentences). The data adopts the IOB2 annotation format, strictly follows the Naamapadam label schema compatible with `ai4bharat/IndicNER`, and includes three types of entities: Person (PER), Location (LOC), and Organization (ORG). The dataset structure includes three fields: unique sentence ID (`id`), token list (`words`), and the corresponding integer label ID list (`ner`). The dataset has been pre-split into training set (~8,156 sentences), validation set (~1,020 sentences), and test set (~1,019 sentences). In terms of data quality, the dataset has undergone rigorous validation to ensure zero BIO sequence errors, fixes isolated `I-` tags and consecutive `B-` tag chains, and enforces a maximum token length limit of 50 tokens per sentence. It is primarily used for fine-tuning Indic NER models targeted at Sri Lankan Tamil texts, enhancing entity detection performance for Tamil documents in the Jaffna region, and constructing Tamil document processing and knowledge graph pipelines.
数据集概述:Sri Lankan Tamil NER
- 数据集名称:Sri Lankan Tamil NER
- 语言:泰米尔语(
ta) - 许可证:Creative Commons Attribution 4.0 International (CC BY 4.0)
- 任务类别:Token Classification → Named Entity Recognition (NER)
- 数据集规模:10,195 个句子(10K < n < 100K)
- 标签格式:IOB2
- 区域焦点:斯里兰卡(贾夫纳地区)
数据集详情
数据来源与组成
| 来源 | 句子数 |
|---|---|
| 书籍 V1–V15(泰米尔文学与历史文本) | 6,393 |
| Final_Tamil Corpus(区域新闻与文档) | 3,802 |
| 总计 | 10,195 |
实体分布
| 实体类型 | 数量 |
|---|---|
B-PER(人物) |
4,533 |
B-LOC(地点) |
8,110 |
B-ORG(组织) |
3,369 |
| 实体总数 | 16,012 |
- 50% 的句子包含至少一个命名实体。
标签模式
遵循 Naamapadam schema,与 ai4bharat/IndicNER 完全兼容:
| ID | 标签 | 描述 |
|---|---|---|
| 0 | O |
非实体 |
| 1 | B-PER |
人物名称开始 |
| 2 | I-PER |
人物名称内部 |
| 3 | B-LOC |
地点开始 |
| 4 | I-LOC |
地点内部 |
| 5 | B-ORG |
组织开始 |
| 6 | I-ORG |
组织内部 |
数据集结构
数据字段
python { "id": "0", # 唯一句子 ID(字符串) "words": ["யாழ்ப்பாணம்", "உள்ள", "..."], # 单词令牌列表 "ner": [3, 0, ...] # 每个单词对应的整数标签 ID 列表 }
数据集拆分
| 拆分 | 句子数 |
|---|---|
| 训练集 | ~8,156 |
| 验证集 | ~1,020 |
| 测试集 | ~1,019 |
| 总计 | 10,195 |
数据质量
- 零 BIO 错误:所有 IOB2 标签序列已完全验证。
- 孤立的
I-标签已修复:没有匹配B-的连续标签已修正。 - 连续
B-标签已合并:同一实体类型的连续B-标签已正确合并。 - 最大令牌长度 50:在预处理中严格执行。
预期用途
- 在 斯里兰卡泰米尔语文本 上微调 Indic NER 模型。
- 提升 贾夫纳领域泰米尔文档 的实体检测能力。
- 用于 低资源泰米尔语 NLP 研究。
- 构建泰米尔文档处理与知识图谱管道。
数据整理与标注
- 来源:15 本泰米尔文学/历史书籍 + 区域泰米尔语语料库。
- 标注方法:GPT 辅助的 CoNLL 格式标注,并自动进行 BIO 验证。
- 预处理:句子分割、令牌长度限制、BIO 错误修正。
- 组织:ExentAI
引用
如使用该数据集,请引用:
bibtex @dataset{exentai_srilankan_tamil_ner, author = {ExentAI}, title = {Sri Lankan Tamil NER}, year = {2025}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/exentai/Srilankan-Tamil-NER} }