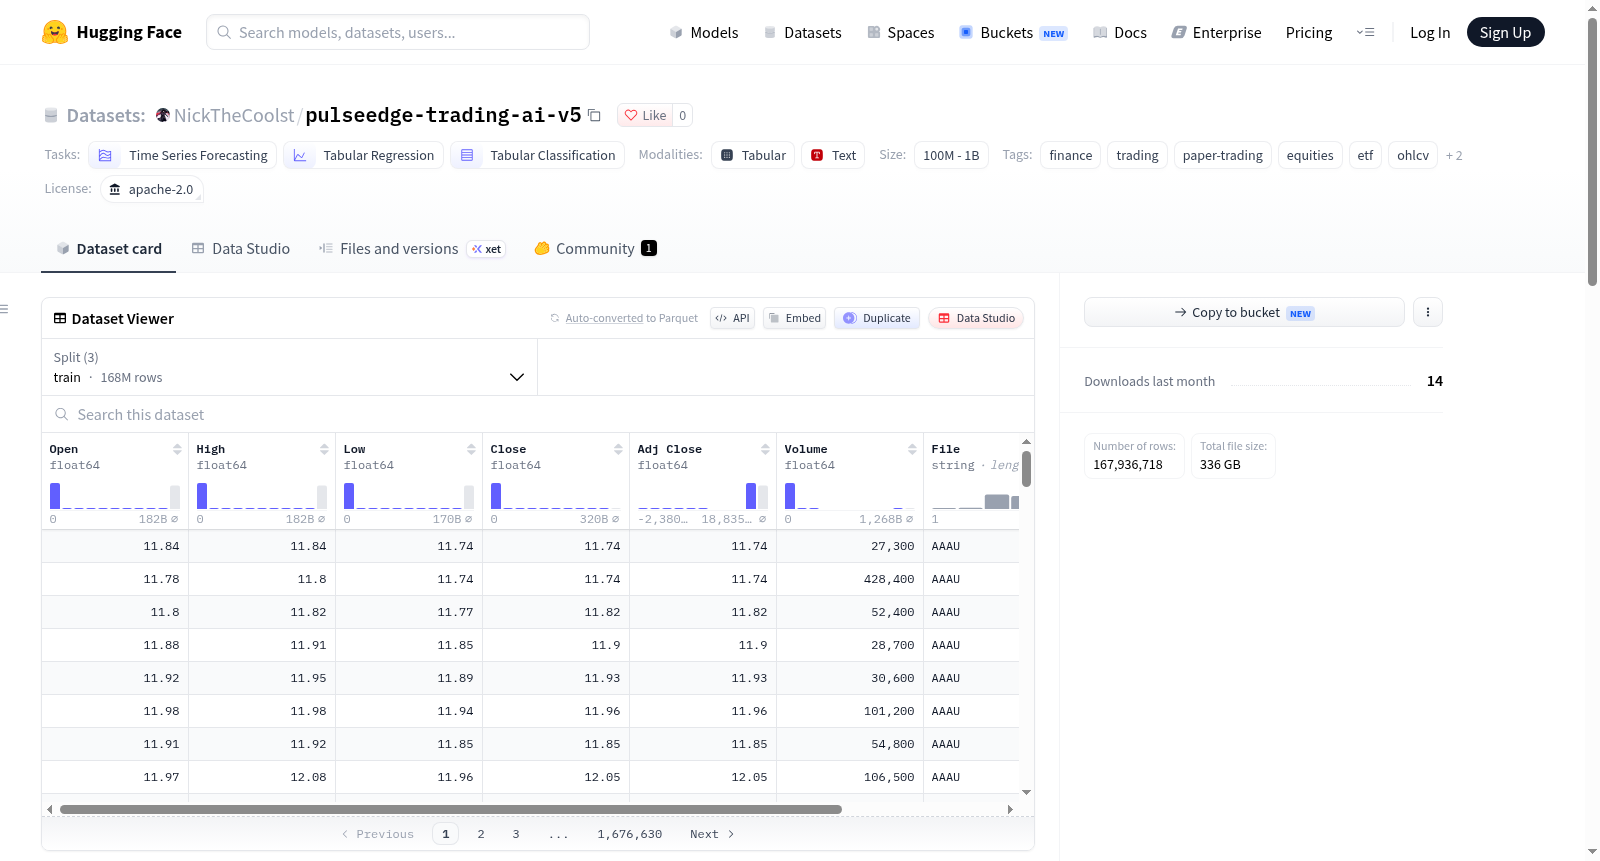
pulseedge-trading-ai-v5
收藏资源简介:
PulseEdge Trading AI v5 (categorized lake) 是一个用于金融研究的私有数据集,包含股票和ETF的多频率OHLCV数据(日、小时、15分钟、5分钟、1分钟),以及丰富的辅助数据,包括宏观指标、微观结构、公司文件、基本面信息、挂牌列表、特征面板和纸交易宇宙。数据来源包括Yahoo Finance、Twelve Data、EODHD、Tiingo、Alpha Vantage、Marketstack、StockData、NASDAQ ITCH、FRED、ECB、Fama-French等。数据集以分类文件夹组织(如ohlcv、features、macro、microstructure、filings、fundamentals、listings、processed等),并提供训练/验证/回测拆分(日/小时数据以2025-12-10为截止,2026年回测;低频数据以最后10天为验证)。打包快照显示日OHLCV约4335万行,小时约4537万行,15分钟约1052万行,5分钟约1330万行,1分钟约1675万行。该数据集适用于时间序列预测、表格回归与分类任务,以及金融建模和交易策略研究。
PulseEdge Trading AI v5 (categorized lake) is a proprietary dataset for financial research, containing multi-frequency OHLCV data (daily, hourly, 15-minute, 5-minute, 1-minute) for stocks and ETFs, along with rich auxiliary data including macro indicators, microstructure, company filings, fundamentals, listings, feature panels, and paper trading universe. Data sources include Yahoo Finance, Twelve Data, EODHD, Tiingo, Alpha Vantage, Marketstack, StockData, NASDAQ ITCH, FRED, ECB, Fama-French, etc. The dataset is organized into categorized folders (e.g., ohlcv, features, macro, microstructure, filings, fundamentals, listings, processed) and provides train/validation/backtest splits (daily/hourly data cutoff on 2025-12-10 with 2026 backtest; low-frequency data uses last 10 days for validation). The packaged snapshot shows approximately 43.35 million rows for daily OHLCV, 45.37 million for hourly, 10.52 million for 15-minute, 13.30 million for 5-minute, and 16.75 million for 1-minute. This dataset is suitable for time series forecasting, tabular regression and classification tasks, as well as financial modeling and trading strategy research.
PulseEdge Trading AI v5 (categorized lake)
基本信息
- 数据集地址: https://huggingface.co/datasets/NickTheCoolst/pulseedge-trading-ai-v5
- 许可证: apache-2.0
- 数据规模: 100M < n < 1B
- 用途: 仅限研究使用,不构成投资建议
- 资产范围: 仅限股票/ETF,无加密货币
任务类别
- 时间序列预测(time-series-forecasting)
- 表格回归(tabular-regression)
- 表格分类(tabular-classification)
标签
finance、trading、paper-trading、equities、etf、ohlcv、macro、microstructure
数据集概述
Hetzner 存储盒的私有快照,按数据类型拆分。v4 将打包表格放在仓库根目录,其余内容放在扁平的 archives/ 目录下;v5 保留相同的研究数据湖,但文件存放于分类文件夹中。
目录分类
| 文件夹 | 内容 |
|---|---|
ohlcv/packed/ |
合并的 Yahoo 行情(1d/1h/15m/5m/1m)以及训练/留出集划分 |
ohlcv/yahoo/ |
按 ticker 组织的 Yahoo 树形结构,按间隔打包的 tar.zst(兼容 CIFS) |
ohlcv/hf_1m/ |
mito0o852/OHLCV-1m 美国 1 分钟月度文件,1992–2026 |
ohlcv/hf_streams/ |
Elliott-wave、Twelve Data 世界模型、HF stocks-daily、sebdg/trading_data |
ohlcv/vendor/ |
Twelve Data、EODHD、Tiingo、Alpha Vantage、Marketstack、StockData |
features/ |
日/周排名面板(fwd_21、fwd_5、infer-liquid)及划分 |
paper/ |
模拟交易全集,仅含 Trading212 工具/交易所,清单文件 |
macro/ |
FRED、ECB FX、Fama-French / Dartmouth 因子、CBOE、财政部/CFTC 数据包、世界银行 |
microstructure/ |
NASDAQ ITCH 存档及解析事件、NOII、FINRA 做空量 |
filings/ |
SEC EDGAR、扩展摘录、公告存档及披露 |
fundamentals/ |
财报、内部人交易、期权、报表、新闻 |
listings/ |
NASDAQ 目录、Wikipedia 成分股、SEC tickers、T212 工具主表 |
processed/ |
日内训练面板、质量数据包、市场广度 |
数据划分
- 日线和小时线: 训练集截至
2025-12-10,含禁运期,2026 留出集从2026-01-01开始。 - 15m / 5m / 1m: Yahoo 历史数据较短,留出集为最后 10 个自然日,而非空的 2026 划分。
- 不要使用
*_backtest_2026.parquet或*_holdout_last10d.parquet进行训练。 - 标签列
fwd_*在构造上会泄露未来信息,需使用净化走步验证(purged walk-forward)。
打包快照统计
- 1d: 43,351,020 行,1037.1 MB,16577 个标的
- 1h: 45,372,436 行,1090.4 MB
- 15m: 10,524,461 行
- 5m: 13,304,173 行
- 1m: 16,754,134 行
- 日线 OHLCV 训练集: 40732299
- 日线 OHLCV 2026 回测集: 2438411
- 特征日线 fwd21 训练集: 25393366
- 构建时间: 2026-09-11T03:42:48.440764+00:00