遇见数据集

EnDev_RAGAS_testset

收藏
Hugging Face2026-09-11 更新2026-09-12 收录
官方服务:

资源简介:

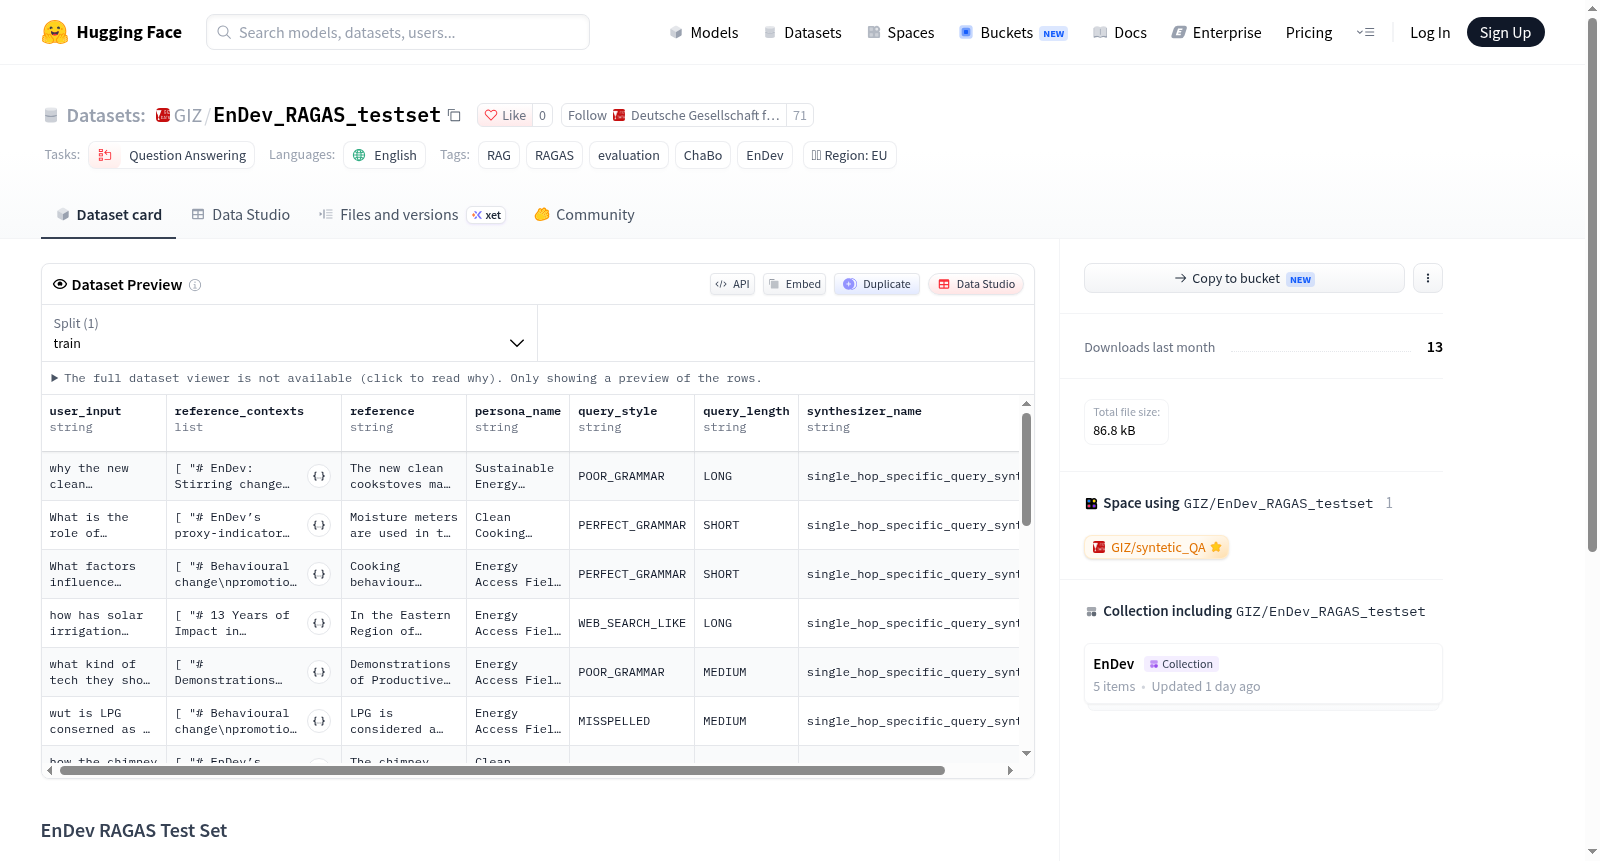
EnDev RAGAS测试集是一个基于RAGAS工具生成的合成问答测试数据集,包含21个问答对。该数据集从EnDev语料库中采样的文本块生成(使用TestsetGenerator.generate_with_chunks方法),用于评估部署在https://giz-endev-orchestrator.hf.space的ChaBo问答管道的性能。生成日期为2026年9月10日,生成器和评判LLM采用Qwen/Qwen3-235B-A22B-Instruct-2507,嵌入模型为BGE-M3(通过EnDev TEI推理端点)。数据集的列包括:用户输入(user_input)、参考答案(reference)、参考上下文(reference_contexts)以及合成器名称(synthesizer_name)。数据集提供JSONL格式(RAGAS就绪)和CSV格式(扁平化)两种文件。该数据集适用于检索增强生成(RAG)系统的评估和测试。

The EnDev RAGAS test set is a synthetic question-answering test dataset generated using the RAGAS tool, containing 21 QA pairs. The dataset is generated from text chunks sampled from the EnDev corpus (using the TestsetGenerator.generate_with_chunks method) and is used to evaluate the performance of the ChaBo QA pipeline deployed at https://giz-endev-orchestrator.hf.space. The generation date is September 10, 2026. The generator and judge LLM use Qwen/Qwen3-235B-A22B-Instruct-2507, and the embedding model is BGE-M3 (via the EnDev TEI inference endpoint). The dataset columns include: user_input, reference, reference_contexts, and synthesizer_name. The dataset is provided in JSONL format (RAGAS-ready) and CSV format (flattened). This dataset is suitable for evaluation and testing of Retrieval-Augmented Generation (RAG) systems.

创建时间:
2026-09-11
原始信息汇总

EnDev RAGAS Test Set

数据集概述

  • 合成问答测试集,共21对问答。
  • 使用 RAGAS(TestsetGenerator.generate_with_chunks)生成。
  • 数据来源于 EnDev 语料库中抽取的文本块,存储于 Qdrant 集合 endev-bgem3-512(Gradio-gateway Space GIZ/EnDev_Qdrant)。

生成信息

  • 生成时间:2026-09-10 UTC
  • 生成器/评判 LLM:Qwen/Qwen3-235B-A22B-Instruct-2507
  • 嵌入模型:BGE-M3,通过 EnDev TEI Inference Endpoint

数据字段

  • user_input
  • reference
  • reference_contexts
  • synthesizer_name

数据集结构

  • 配置名称:default
  • 数据文件:endev_testset.jsonl
  • 划分:train
    • 样本数:21

任务与语言

  • 任务类别:question-answering
  • 语言:en

标签

  • RAG
  • RAGAS
  • evaluation
  • ChaBo
  • EnDev

用途

  • 用于评估部署于 https://giz-endev-orchestrator.hf.space 的 ChaBo pipeline。

文件

  • endev_testset.jsonl(RAGAS-ready)
  • endev_testset.csv(flat)
搜集汇总
数据集介绍
EnDev_RAGAS_testset 数据集图片
构建方式
面向检索增强生成系统的评估需求,该数据集依托RAGAS框架的TestsetGenerator.generate_with_chunks方法自动合成问答对。构建过程以Qdrant向量数据库中endev-bgem3-512集合存储的EnDev语料为知识来源,经采样后由生成器逐块构造问题与参考答案,并同步产出参考上下文。生成与评判环节采用Qwen/Qwen3-235B-A22B-Instruct-2507模型,向量表示则由BGE-M3通过EnDev TEI推理端点完成,最终形成21组问答样本,覆盖用户输入、参考答案、参考上下文及合成器名称四个字段。
使用方法
该数据集主要用于对部署于Hugging Face Space的ChaBo流水线开展系统评估。使用者可将endev_testset.jsonl直接载入RAGAS评测流程,借助其内置指标对检索与生成环节进行量化分析,亦可依据reference_contexts字段单独考察上下文召回效果。若需进行传统问答评测,则可选用endev_testset.csv以扁平结构接入自建评估脚本。在具体实践中,建议将user_input作为系统输入,reference与reference_contexts作为评判基准,从而获得检索增强生成系统在EnDev领域内的性能画像。
背景与挑战
背景概述
检索增强生成(RAG)系统在专业领域的评估长期受限于高质量测试集的匮乏。EnDev_RAGAS_testset由GIZ机构研究人员于2026年9月构建,依托Qwen3-235B大模型与BGE-M3嵌入,基于EnDev语料库自动生成21组问答对,旨在为ChaBo管道提供标准化评估基准。该数据集聚焦能源发展领域的知识问答,推动了RAG系统在垂直领域评估方法论的实践,为后续研究提供了可复用的合成数据范式。
当前挑战
RAG评估面临的核心难题在于测试集需兼具语义多样性与领域准确性。EnDev_RAGAS_testset的构建需克服合成问答与真实查询分布偏差的风险,确保参考上下文与原始语料严格对齐。同时,仅21组样本的规模限制了统计效力,可能无法覆盖能源发展领域的复杂多跳推理场景。此外,依赖单一LLM生成与评判引入的模型偏好,亦对评估结论的客观性构成潜在威胁。
常用场景
经典使用场景
在检索增强生成系统的评估实践中,EnDev_RAGAS_testset充当了标准化基准的角色。该数据集通过RAGAS框架的TestsetGenerator,从EnDev语料库的文本块中合成出21组问答对,每组包含用户输入、参考答案及参考上下文。研究者可将其直接输入至待测的RAG流水线,借助RAGAS的忠实度、答案相关性、上下文精确度等指标,系统性地量化生成内容与检索质量,从而形成对系统性能的客观判断。
解决学术问题
该数据集缓解了RAG评估领域长期存在的测试集稀缺与领域适配困难问题。传统评估多依赖人工标注或通用问答数据,难以贴合特定垂直领域的检索与生成特性。EnDev_RAGAS_testset以合成方式生成具备领域针对性的问答对,为学术研究提供了可复现、可扩展的评测资源,推动了RAG系统在专业场景下的性能比较与方法迭代,对检索增强生成技术的规范化评估具有积极意义。
实际应用
在工程落地层面,该数据集被用于评估部署于Hugging Face Space上的ChaBo流水线。开发团队可借助该测试集快速诊断检索模块与生成模块的协同表现,识别答案幻觉、上下文遗漏或无关检索等典型缺陷。其RAGAS就绪的JSONL格式与扁平化CSV格式,便于集成至持续评估流程,支撑模型选型、参数调优与版本回归测试,有效降低实际部署中的试错成本。
数据集最近研究
最新研究方向
在检索增强生成(RAG)系统的评估实践中,合成测试集的构建与基准化正成为前沿探索的焦点。EnDev_RAGAS_testset依托RAGAS框架,从EnDev语料库中采样文本块并自动生成21组问答对,为部署于GIZ/EnDev orchestrator的ChaBo流水线提供了轻量级、可复现的评估基准。该数据集关联到RAG评估领域对自动化、可解释性指标的迫切需求,其意义在于以低资源方式验证RAG系统在真实开发场景中的检索与生成质量,推动评估流程从人工标注向合成数据驱动的范式转变,并为后续跨领域RAG基准的标准化与可扩展性研究奠定基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务