
ANT (Arabic News Texts) Corpus
收藏官方服务:
资源简介:
ANT语料库是一个多源新闻版本的数据集,包含从2018年2月至10月的数据,共有31,798篇文章,超过967万字,分为6个类别,来自5个不同的消息来源。
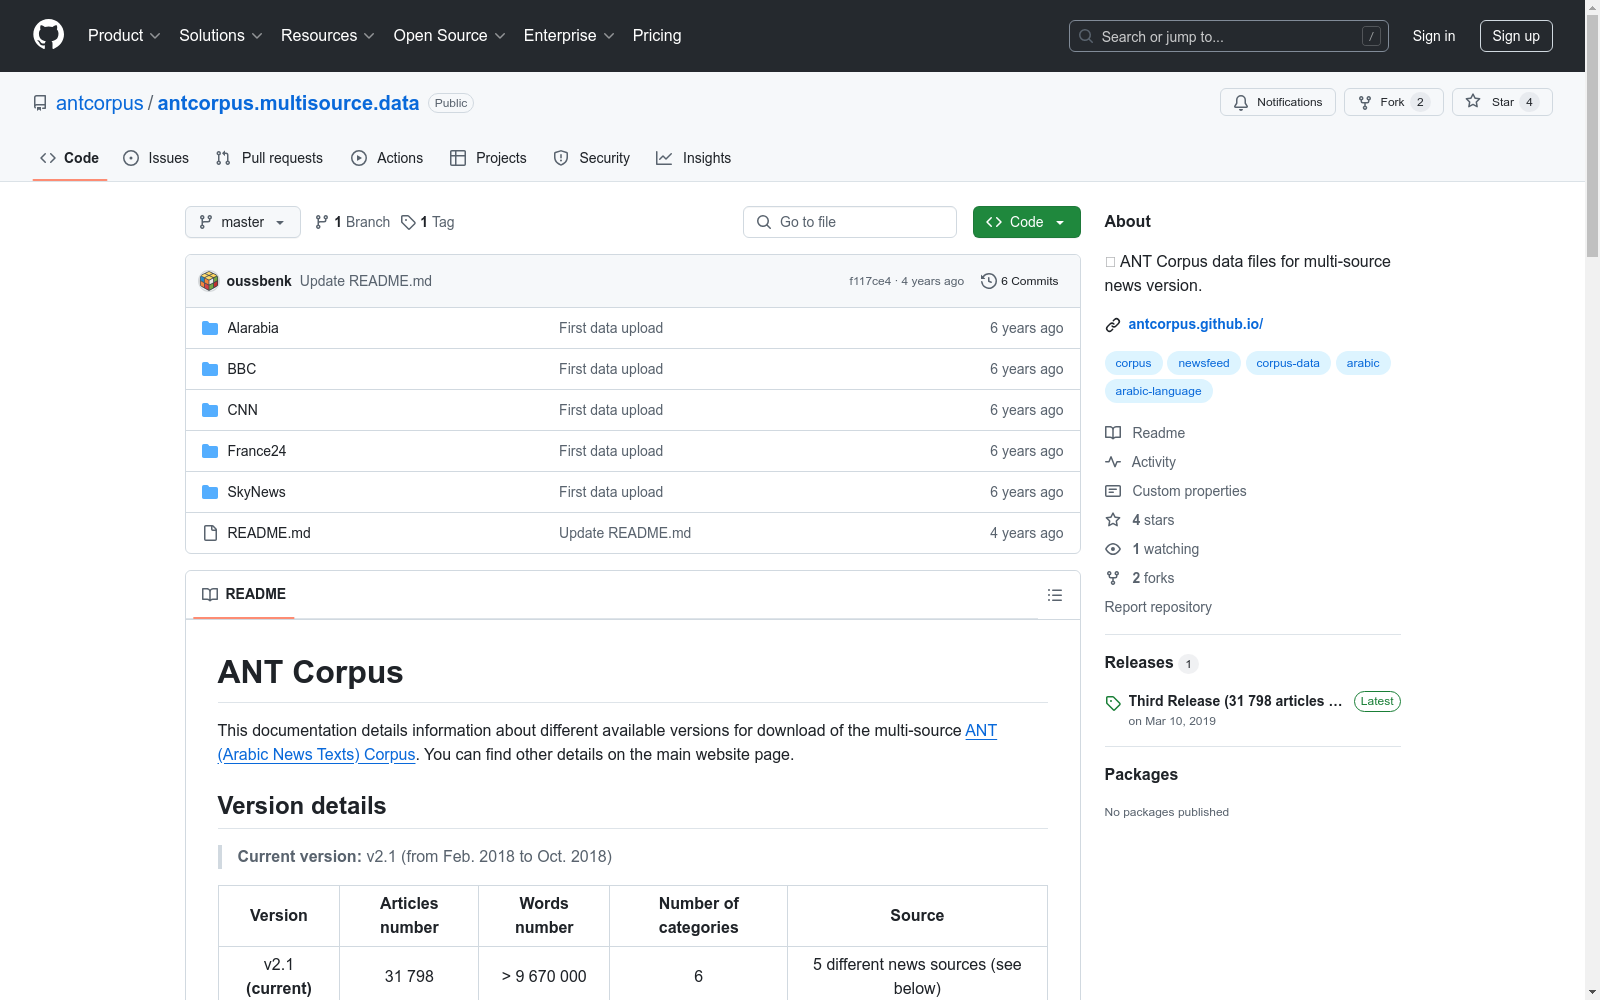
The ANT Corpus is a multi-source news version dataset, encompassing data from February to October 2018. It consists of 31,798 articles, totaling over 9.67 million words, categorized into 6 classes and sourced from 5 distinct news outlets.
创建时间:
2019-03-09
原始信息汇总
ANT Corpus 数据集概述
数据集版本信息
当前版本
- 版本号: v2.1
- 时间范围: 2018年2月至2018年10月
- 文章数量: 31,798篇
- 总字数: 超过9,670,000字
- 分类数量: 6类
- 来源: 5个不同的新闻源
历史版本
-
v1.1
- 文章数量: 10,161篇
- 总字数: 超过1,474,000字
- 分类数量: 9类
- 来源: JawharaFM
-
v1.0
- 文章数量: 6,005篇
- 总字数: 超过865,500字
- 分类数量: 9类
- 来源: JawharaFM
分类信息
| 类别(英文) | 类别(阿拉伯文) | AlArabiya | BBC | CNN | France24 | SkyNews | 总计 |
|---|---|---|---|---|---|---|---|
| culture | ثقافة | 606 | 338 | - | 126 | - | 1,070 |
| economy | اقتصاد | 1,071 | 281 | 463 | 78 | 1,479 | 3,372 |
| international news | العالم | 2,030 | 1,220 | 734 | 2,793 | 3,575 | 10,352 |
| middle East | الشرق الأوسط | - | 1,131 | 1,640 | 947 | 3,972 | 7,690 |
| sport | رياضة | 2,443 | 385 | 483 | 297 | 2,975 | 6,583 |
| technology | تكنولوجيا | 369 | 460 | 187 | - | 1,715 | 2,731 |
| 文档数量 | 6,519 | 3,815 | 3,507 | 4,241 | 13,716 | 31,798 |
文件格式
ANT Corpus 文件采用XML格式,使用与TREC和CLEF标准测试集合相似的标签。
引用许可
使用ANT Corpus数据集需遵守引用许可,即在使用数据集进行搜索或实验的任何材料中,至少引用一篇描述ANT Corpus的论文或参考项目主页。
搜集汇总
数据集介绍
构建方式
ANT (Arabic News Texts) Corpus 数据集的构建基于多源阿拉伯新闻文本的收集与整理。该数据集从多个新闻网站(如 AlArabiya、BBC、CNN 等)获取新闻文章,涵盖文化、经济、国际新闻、中东、体育和技术等多个类别。每篇文章均以 XML 格式存储,遵循 TREC 和 CLEF 标准测试集的标签规范,确保数据的结构化和标准化。数据集的版本迭代从 v1.0 到 v2.1,逐步扩展了文章数量和类别覆盖范围。
特点
ANT Corpus 数据集的特点在于其多源性和多样性。数据集包含来自五个不同新闻源的超过 31,000 篇文章,涵盖六个主要类别,总词汇量超过 967 万。每篇文章均包含标题、摘要、正文等结构化信息,且部分文章还标注了作者和时间戳。数据集的 XML 格式设计使其易于解析和处理,适用于文本分类、摘要生成等自然语言处理任务。此外,数据集的多语言支持(阿拉伯语和英语)为跨语言研究提供了便利。
使用方法
ANT Corpus 数据集的使用方法主要围绕其 XML 格式展开。用户可以通过解析 XML 文件获取每篇文章的元数据(如标题、时间、来源等)和正文内容。数据集适用于多种自然语言处理任务,包括文本分类、情感分析、事件提取和摘要生成等。使用该数据集时,用户需遵循引用许可协议,确保在相关研究成果中引用指定的文献或项目主页。此外,用户可通过 GitHub 提交问题或建议,参与数据集的改进与扩展。
背景与挑战
背景概述
ANT (Arabic News Texts) Corpus 是一个专注于阿拉伯语新闻文本的多源数据集,由突尼斯的RIADI-ENSI实验室、Manouba大学和Sousse大学的研究团队于2017年创建。该数据集旨在为阿拉伯语自然语言处理(NLP)任务提供高质量的文本资源,特别是在文本分类、摘要生成和事件提取等领域。ANT Corpus 的构建基于多个阿拉伯语新闻来源,涵盖了文化、经济、国际新闻、中东新闻、体育和技术等多个类别。自发布以来,该数据集已在多个国际会议和期刊中被引用,推动了阿拉伯语NLP研究的发展。
当前挑战
ANT Corpus 在构建和应用过程中面临多重挑战。首先,阿拉伯语的复杂形态和丰富的方言变体使得文本预处理和标准化变得尤为困难,尤其是在多源数据整合时。其次,新闻文本的时效性和多样性要求数据集必须不断更新以保持其代表性,这对数据采集和维护提出了较高要求。此外,阿拉伯语的资源稀缺性使得数据集的扩展和优化面临技术瓶颈。在应用层面,如何有效利用ANT Corpus进行跨领域的NLP任务(如情感分析、机器翻译等)仍是一个亟待解决的问题。
常用场景
经典使用场景
ANT (Arabic News Texts) Corpus 是一个多源阿拉伯新闻文本数据集,广泛应用于自然语言处理领域,特别是在文本分类、信息提取和自动摘要生成等任务中。该数据集通过提供来自多个新闻源的阿拉伯语新闻文章,为研究人员提供了一个丰富的语料库,用于训练和评估各种文本处理模型。其XML格式的文件结构使得数据易于解析和处理,适用于多种NLP任务。
实际应用
在实际应用中,ANT Corpus 被广泛用于新闻推荐系统、舆情分析、以及多语言信息检索系统。通过分析新闻文本的内容和类别,企业可以更好地理解市场动态和用户需求,从而优化其产品和服务。此外,该数据集还被用于开发阿拉伯语的自动摘要工具,帮助用户快速获取新闻要点,提升信息获取效率。
衍生相关工作
ANT Corpus 的发布催生了一系列相关研究,特别是在阿拉伯语文本处理领域。例如,基于该数据集的研究工作包括单文档摘要生成、文本分类、以及基于词嵌入的相关术语提取等。这些研究不仅推动了阿拉伯语自然语言处理技术的发展,还为其他低资源语言的文本处理研究提供了借鉴和参考。
以上内容由遇见数据集搜集并总结生成


