
giannor/dala_gen_large_v3
收藏官方服务:
资源简介:
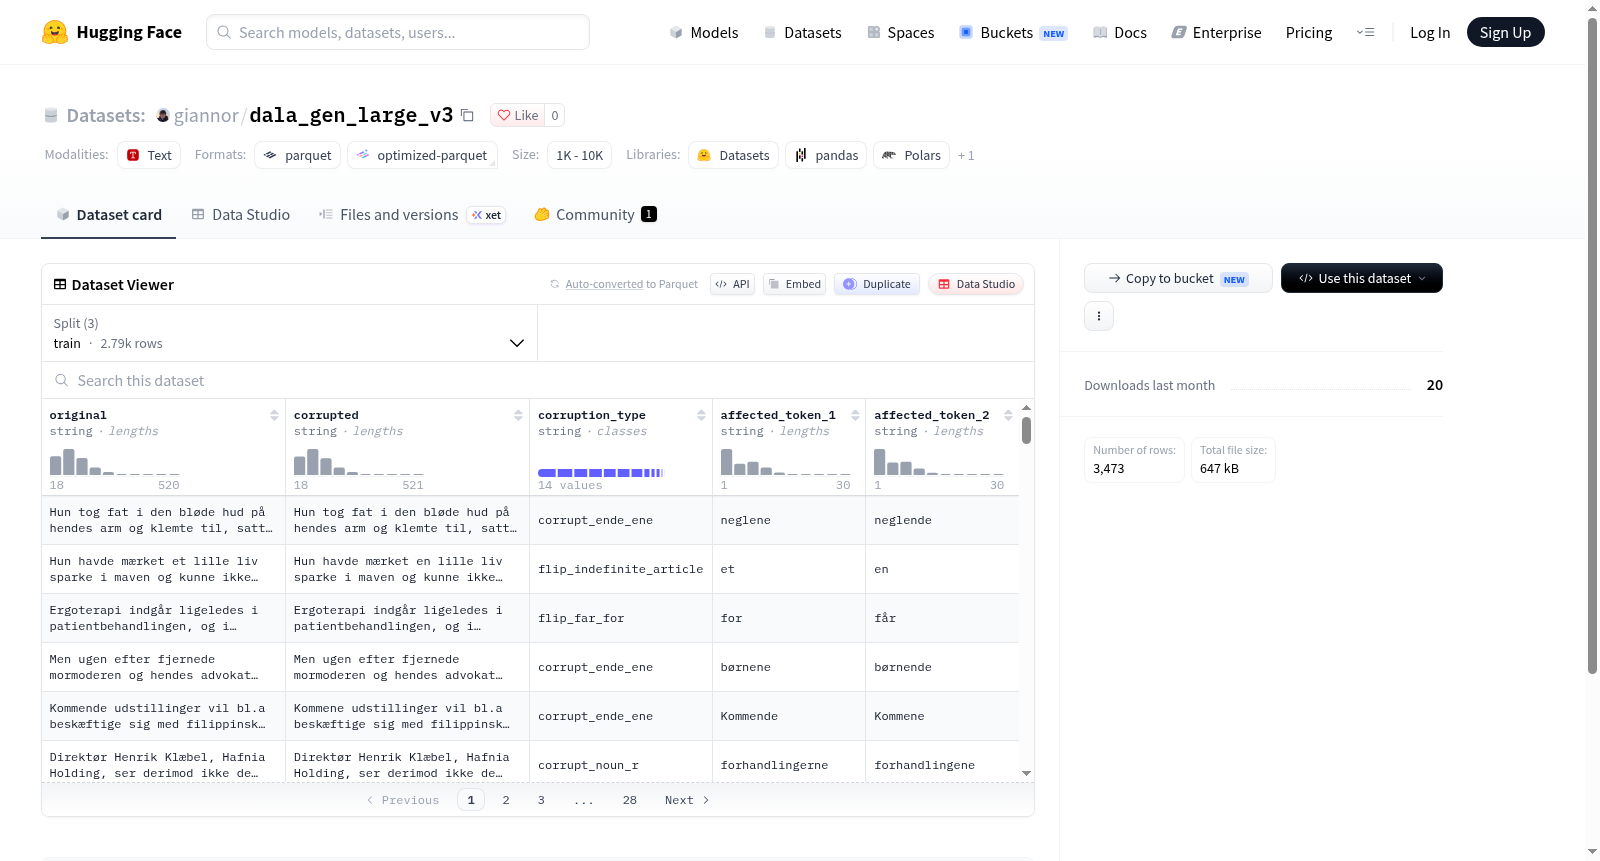
该数据集包含文本对,每对由原始文本和经过损坏处理的文本组成,并标注了损坏类型及受影响的具体标记。数据集分为训练集、验证集和测试集,适用于文本损坏检测、修复或相关自然语言处理任务的研究。
This dataset comprises text pairs, where each pair consists of an original text and a corrupted version thereof. Each pair is annotated with the specific corruption type and the exact affected tokens. The dataset is split into training, validation, and test sets, and is applicable to research on text corruption detection, restoration, and other related natural language processing tasks.
提供机构:
giannor搜集汇总
数据集介绍
构建方式
在自然语言处理领域,针对文本扰动与鲁棒性评估的需求,该数据集通过系统化的扰动注入策略构建而成。原始文本经特定算法处理,生成对应的扰动版本,并记录扰动类型及受影响的具体词元。数据集划分为训练集、验证集与测试集,分别包含2786、173和514个样本,确保模型评估的全面性与可靠性。每个样本均标注了原始文本、扰动文本、扰动类别以及两个受影响词元,为细粒度分析提供了结构化基础。
使用方法
使用者可通过HuggingFace数据集库便捷加载该数据集,利用内置的 splits 划分进行模型训练、验证与测试。在鲁棒性评估中,可将原始文本作为输入,扰动文本作为目标或对比,分析模型性能变化。受影响词元标注可用于可视化或注意力机制研究。该数据集亦适用于微调模型以增强对特定扰动的抵抗力,或作为扰动检测任务的监督信号。
背景与挑战
背景概述
在自然语言处理领域,文本噪声与对抗性扰动始终是制约模型鲁棒性的关键因素。针对此问题,研究者构建了dala_gen_large_v3数据集,旨在为文本纠错与鲁棒性评估提供系统化资源。该数据集由专业团队于近年创建,核心研究问题在于如何量化并定位文本中细微的语义级干扰。通过提供原始文本、受扰文本、干扰类型及受影响词元标注,该数据集为模型训练与评测建立了细粒度基准,推动了纠错算法与防御机制的发展,对提升下游任务可靠性具有显著影响力。
当前挑战
该数据集所应对的领域问题聚焦于文本噪声的精准识别与纠正,其核心挑战在于干扰的隐蔽性与多样性。构建过程中,如何生成既自然又具破坏性的扰动样本,并确保标注的一致性与覆盖度,构成了主要难点。具体挑战包括:多类型干扰(如替换、插入、删除)的均衡生成、受影响词元的精确边界界定、以及保持原始语义与语法合法性的同时注入可控错误。这些挑战要求数据构建兼顾真实场景分布与对抗强度,以支撑鲁棒性评估的严谨性。
常用场景
经典使用场景
在自然语言处理领域,文本纠错任务始终是提升语言模型鲁棒性的关键环节。dala_gen_large_v3数据集以原始文本与相应 corrupted 版本配对的形式,为语法错误纠正与拼写检查提供了高质量的监督信号。其经典使用场景集中于训练序列到序列的纠错模型,诸如基于Transformer架构的纠错系统,通过学习原始与扰动文本之间的映射关系,模型能够精准定位并修正各类错误,涵盖替换、插入、删除等常见 corruption 类型,并借助 affected_token 标注实现细粒度的错误定位与修正。
解决学术问题
该数据集有效缓解了文本纠错研究中高质量平行语料匮乏的困境。过往学术探索常受限于错误类型单一、标注粒度粗糙等瓶颈,难以系统评估模型对多样化错误的鲁棒性。dala_gen_large_v3通过提供细粒度的错误类型标签与受影响词元标注,使研究者能够深入剖析模型在不同错误模式下的表现差异,进而推动纠错算法在泛化能力与可解释性方面的理论突破,为鲁棒语言理解奠定了数据基础。
实际应用
在实际应用层面,该数据集赋能诸多文本处理场景。智能写作辅助工具可借助其训练的模型实时检测并修正用户输入中的拼写与语法错误,提升内容质量;搜索引擎与问答系统能利用纠错能力优化查询理解,降低因输入错误导致的检索偏差;在社交媒体与在线评论分析中,该数据集支持的模型可有效净化噪声文本,为下游情感分析与观点挖掘提供可靠输入,展现出广泛的工业应用价值。
数据集最近研究
最新研究方向
在自然语言处理领域,数据增强与鲁棒性评估日益成为研究焦点,dala_gen_large_v3数据集通过系统化地注入多样化的文本损坏类型,并精确标注受影响词汇,为模型在对抗性环境下的表现提供了细粒度诊断资源。当前前沿研究致力于利用此类数据探索语言模型对拼写错误、字符替换等噪声的容忍边界,并推动基于损坏模式的预训练目标与自监督修复策略的发展。该数据集所蕴含的细粒度标注信息,亦与可解释性人工智能和模型纠错机制等热点方向紧密关联,为构建更稳健、可信的自然语言理解系统奠定了数据基础,其影响延伸至机器翻译、信息检索等对输入噪声敏感的诸多应用场景。
以上内容由遇见数据集搜集并总结生成


