
shi3z/MTbenchJapanese
收藏官方服务:
资源简介:
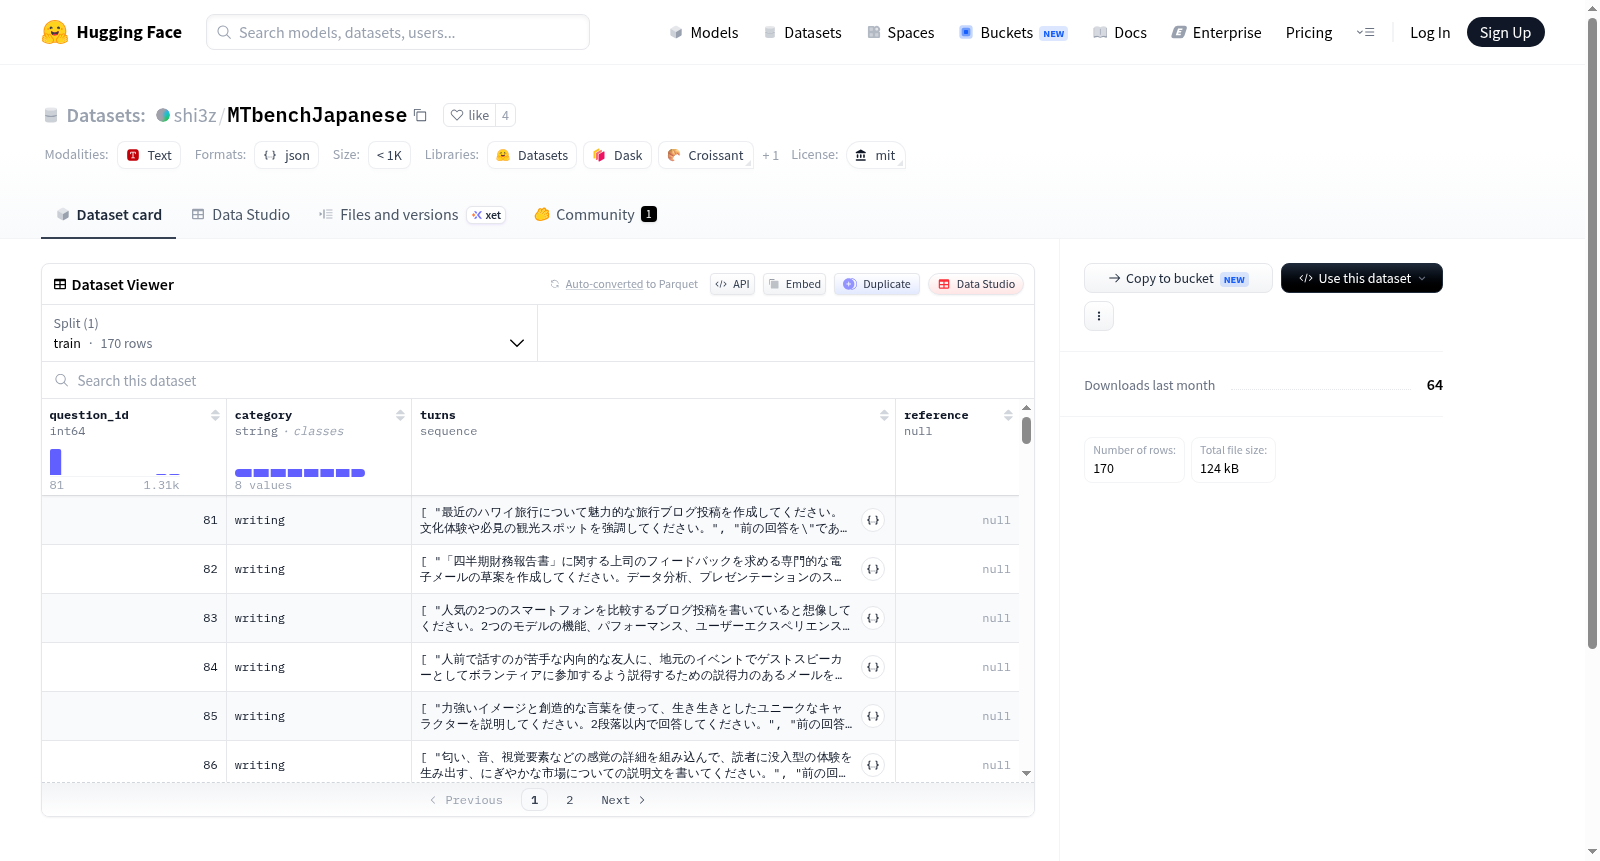
--- license: mit --- Japanese translated file from Vicuna MT bench question.jsonl https://github.com/lm-sys/FastChat/blob/main/fastchat/llm_judge/data/mt_bench/question.jsonl fixed by npaka https://note.com/npaka/n/na28f31e96599
许可证:MIT许可证 本文件为Vicuna MT基准测试(Vicuna MT Bench)问题集jsonl文件的日语翻译版本 原文件地址:https://github.com/lm-sys/FastChat/blob/main/fastchat/llm_judge/data/mt_bench/question.jsonl 由npaka整理修正 相关说明页面:https://note.com/npaka/n/na28f31e96599
提供机构:
shi3z原始信息汇总
数据集概述
数据集名称
Japanese translated file from Vicuna MT bench question.jsonl
数据集来源
- 原始文件链接:https://github.com/lm-sys/FastChat/blob/main/fastchat/llm_judge/data/mt_bench/question.jsonl
- 修正者:npaka
- 修正者链接:https://note.com/npaka/n/na28f31e96599
许可协议
MIT
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,多轮对话评估是衡量大语言模型能力的重要环节。MT-bench作为广泛使用的基准测试,其日文版本的构建尤为关键。该数据集基于Vicuna项目官方提供的MT-bench英文版问题集,通过人工翻译与专家校对的方式,将原始question.jsonl文件中的英文对话问题逐条转化为地道日语。翻译过程由社区贡献者npaka主导,并参考了其公开的技术笔记进行质量修正,最终形成涵盖多领域知识的多轮对话评估集。
特点
该数据集的核心特色在于其跨语言适配的严谨性与实用性。作为MT-bench的日文镜像,它完整保留了原始基准测试的8个对话类别与80组多轮交互场景,涵盖写作、推理、数学等多元能力维度。通过专业翻译确保了日语语境下的语义准确性,同时采用与英文版一致的JSONL格式,使得模型在日文环境下的评估结果可直接与英文基线进行对比分析,为跨语言大模型研究提供了标准化工具。
使用方法
使用该数据集时,研究人员可将其直接替换为FastChat框架中llm_judge组件的评估输入。具体操作包括下载question.jsonl文件后,通过FastChat的评估脚本调用日文对话样本,对目标模型进行多轮交互测试。数据集采用MIT开源协议,允许自由修改与分发,开发者可根据需要调整评估流程,例如结合自动评分系统或人工评审机制,对模型在日文场景下的对话质量进行量化分析。
背景与挑战
背景概述
在大型语言模型评估领域,多轮对话能力已成为衡量模型智能水平的关键指标。MT-bench作为Vicuna团队构建的经典基准测试,通过80道涵盖写作、推理、数学等领域的多轮问题,推动了对话系统的标准化评估。然而,原始MT-bench数据集以英文为主,限制了其在非英语场景下的适用性。shi3z/MTbenchJapanese数据集于2023年由研究者shi3z创建,基于FastChat项目的英文MT-bench问题集,经npaka的修正后完成日文翻译。该数据集的核心研究问题在于构建日文多轮对话评估基准,填补了日语大模型评测领域的空白,为日本学术界和工业界的模型对比提供了可靠工具,对推动日语自然语言处理研究具有重要影响力。
当前挑战
该数据集面临的主要挑战源于跨语言迁移的复杂性。首先,翻译过程中需确保日语表达的自然性与多轮对话逻辑的连贯性,避免因直译导致语义偏差或文化不适配,例如日语中敬语体系与对话场景的匹配问题。其次,原始MT-bench的问题设计基于英文语言习惯与文化背景,直接翻译可能无法完全反映日语用户的实际交互需求,需评估其评估效度。在构建过程中,翻译质量的验证缺乏统一标准,依赖人工修正(如npaka的修订)虽提升了准确性,但难以规模化扩展。此外,数据集规模较小(80道问题),在覆盖日语特有的语言现象(如省略主语、语境依赖)方面存在局限,可能影响评测结果的泛化性。
常用场景
经典使用场景
MTbenchJapanese数据集是Vicuna团队开发的MT-bench基准测试的日文翻译版本,专为评估日语大语言模型的多轮对话能力而设计。该数据集包含80个精心构造的多轮对话问题,覆盖写作、角色扮演、推理、数学、编程、提取、STEM和人文学科八大领域。研究者利用此数据集对模型进行指令跟随和对话连贯性的系统评测,通过GPT-4等强大模型作为裁判,对模型回答进行1至10分的量化打分,从而客观比较不同日语LLM的对话质量。这一经典场景已成为日语自然语言处理领域模型性能评估的标配流程。
解决学术问题
该数据集解决了日语大语言模型评测中缺乏标准化、多维度、多轮对话基准的学术难题。此前日语模型评估多依赖单轮问答或翻译任务,难以全面反映模型在复杂对话场景下的真实能力。MTbenchJapanese通过提供涵盖多个认知层级的对话任务,使研究者能够系统考察模型的知识广度、逻辑推理、创造力和语境理解等核心能力。其引入的GPT-4自动化评估方法,不仅大幅降低了人工评测成本,还确保了评估的一致性和可重复性,为日语LLM的学术研究建立了客观、可比较的评估范式,推动了模型优化方向的明确化。
衍生相关工作
MTbenchJapanese数据集衍生了一系列重要的相关工作,包括日语版MT-bench的改进版本和基于该基准的模型排行榜。例如,研究者基于此数据集开发了更细粒度的日语对话评估指标,如结合日语敬语和文化语境的评分体系。同时,该数据集被用于训练日语专用的奖励模型,如Japanese Reward Model,以提升模型对齐能力。此外,多个日语大语言模型(如Rinna、ELYZA等)在发布时均引用该数据集作为性能对比依据,形成了日语LLM社区公认的评估标准,并催生了类似Japanese Vicuna Benchmark等扩展工作,进一步丰富了日语模型评测生态。
以上内容由遇见数据集搜集并总结生成


