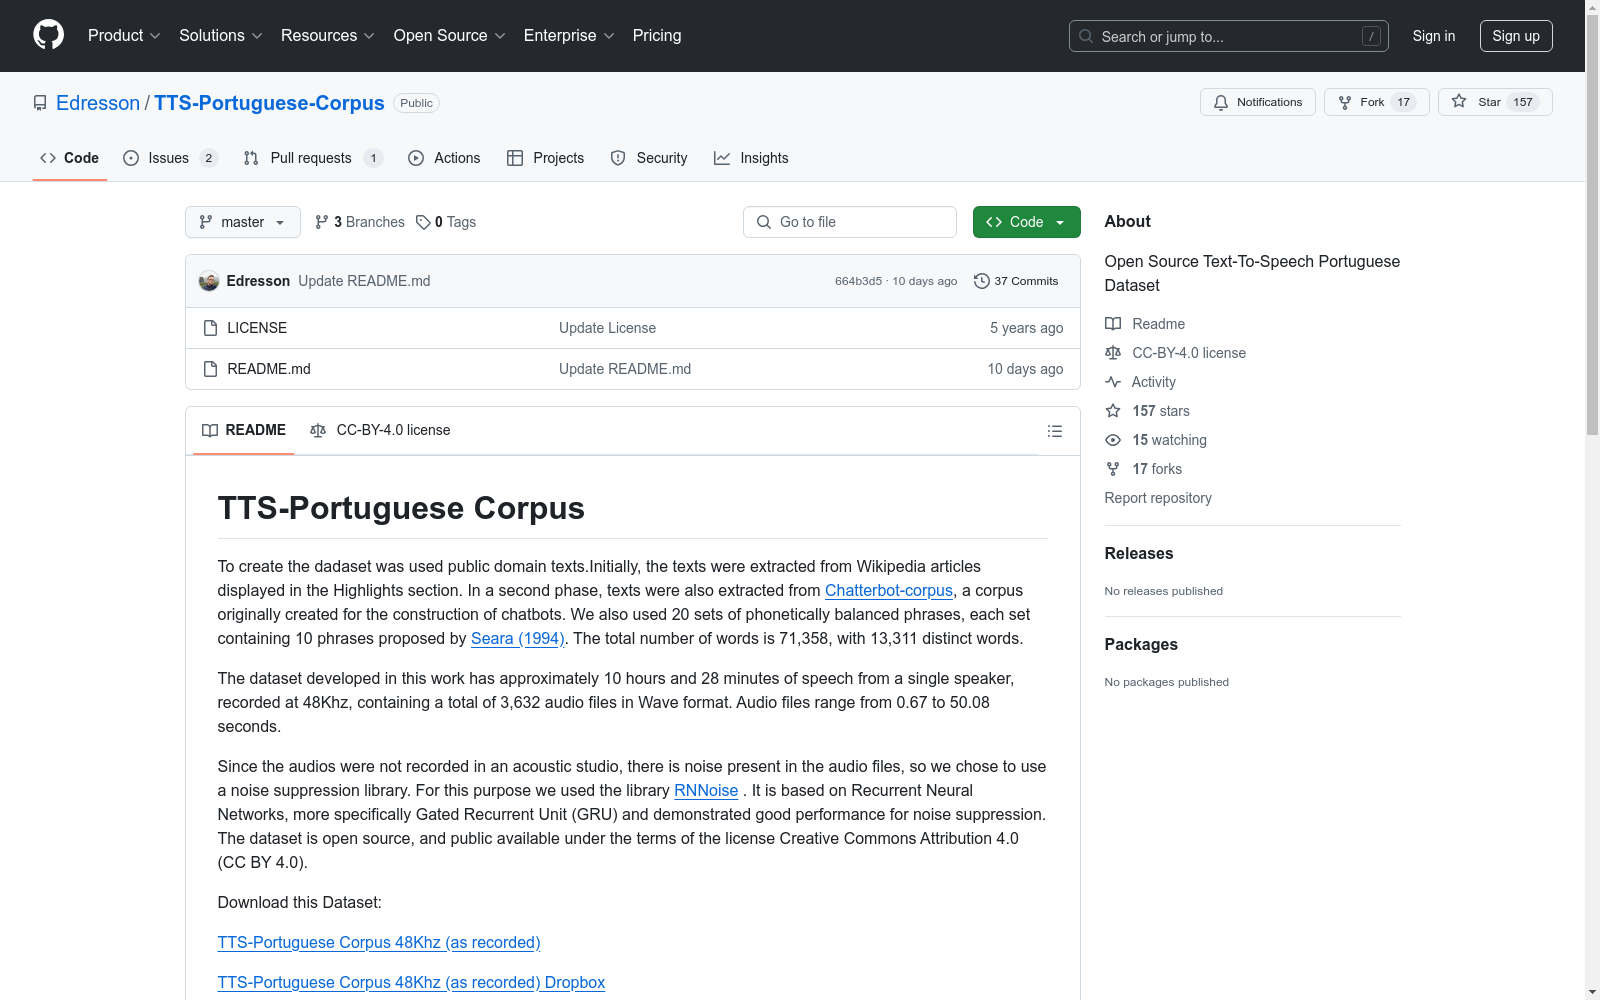
TTS-Portuguese Corpus
收藏资源简介:
该数据集用于巴西葡萄牙语的语音合成,包含约10小时28分钟的单个说话者的语音,记录在48Khz,共有3,632个Wave格式的音频文件。数据集使用了公共领域的文本,包括维基百科文章和Chatterbot-corpus,以及20组语音平衡的短语。
This dataset is designed for Brazilian Portuguese speech synthesis, comprising approximately 10 hours and 28 minutes of speech from a single speaker, recorded at 48 kHz. It includes a total of 3,632 audio files in Wave format. The dataset utilizes texts from the public domain, including Wikipedia articles and the Chatterbot-corpus, along with 20 sets of phonetically balanced phrases.
TTS-Portuguese Corpus 概述
数据集来源与内容
- 文本来源:数据集使用了公共领域的文本,包括Wikipedia Highlights部分的文章内容和Chatterbot-corpus中的葡萄牙语文本。
- 语音内容:包含20组由Seara (1994)提出的音韵平衡短语,每组10个短语。
- 词汇量:总词数为71,358,其中13,311个不同的词汇。
音频特性
- 时长:数据集包含约10小时28分钟的语音,由单一说话者录制。
- 格式与质量:音频文件为Wave格式,采样率为48Khz,时长从0.67秒至50.08秒不等。
- 噪音处理:由于录音环境非专业录音室,音频中含有噪音,使用了RNNoise库进行噪音抑制。
数据集使用与下载
- 授权:数据集开放源代码,根据Creative Commons Attribution 4.0 (CC BY 4.0)许可证公开可用。
- 下载链接:
模型与演示
- 模型:数据集用于训练多种语音合成模型,包括DCTTS模型、TTS Mozilla模型(Tacotron)和GlowTTS模型结合HiFi-GAN-FT。
- 演示链接:
引用信息
-
预印本:
@misc{casanova2020ttsportuguese, title={TTS-Portuguese Corpus: a corpus for speech synthesis in Brazilian Portuguese}, author={Edresson Casanova and Arnaldo Candido Junior and Christopher Shulby and Frederico Santos de Oliveira and João Paulo Teixeira and Moacir Antonelli Ponti and Sandra Maria Aluisio}, year={2020}, eprint={2005.05144}, archivePrefix={arXiv}, primaryClass={eess.AS} }
-
完整论文:
@article{casanova2022tts, title={TTS-Portuguese Corpus: a corpus for speech synthesis in Brazilian Portuguese}, author={Casanova, Edresson and Junior, Arnaldo Candido and Shulby, Christopher and Oliveira, Frederico Santos de and Teixeira, Jo{~a}o Paulo and Ponti, Moacir Antonelli and Alu{\i}sio, Sandra}, journal={Language Resources and Evaluation}, pages={1--13}, year={2022}, publisher={Springer} }