
anirudhb11/gemma-4-E4B-it-mv-rg_cognition
收藏官方服务:
资源简介:
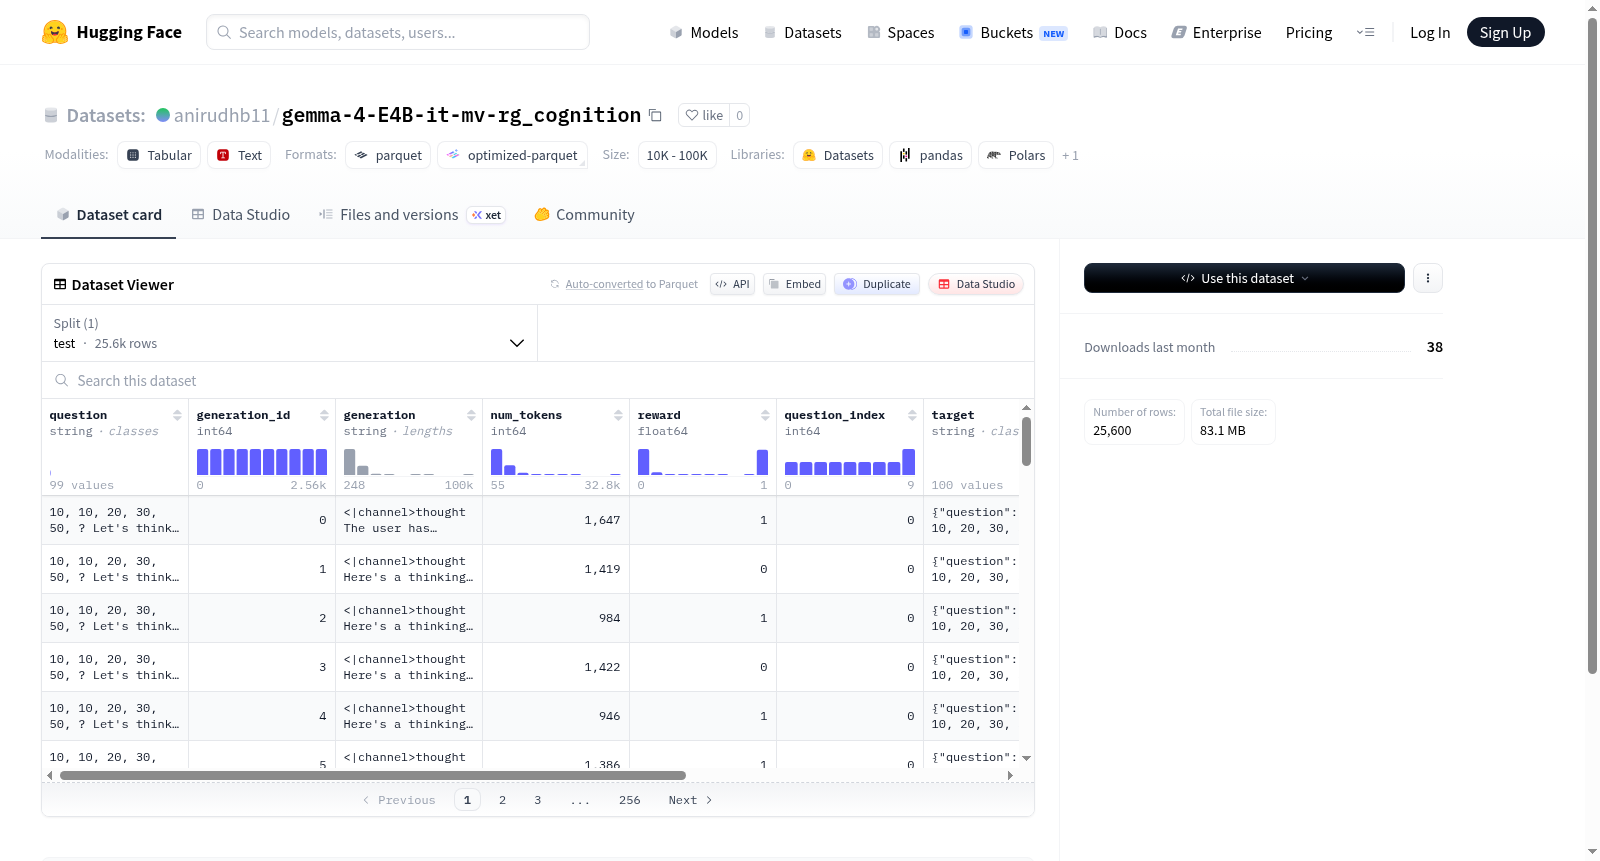
该数据集包含25600个测试样本,每个样本具有多个特征字段,包括问题(question)、生成文本(generation)、奖励值(reward)、目标(target)、任务类型(task)等,可能用于文本生成或问答任务的强化学习评估,其中奖励值和预测值(vf_prediction)指示生成质量或模型输出评分。数据分割为测试集,总大小约293MB。
This dataset contains 25,600 test samples. Each sample has multiple feature fields including question, generation, reward, target, task type, and others. It can be utilized for reinforcement learning evaluation in text generation or question answering tasks, where the reward and vf_prediction serve as indicators of generation quality or model output scoring. The data is split into a test set, with a total size of approximately 293 MB.
提供机构:
anirudhb11搜集汇总
数据集介绍
构建方式
本数据集基于Gemma-4-E4B-it模型,通过多轮迭代生成与奖励信号反馈机制构建而成。具体而言,系统针对预设的认知类问题(question)生成多个候选回答(generation),并依据奖励分数(reward)与价值函数预测值(vf_prediction)进行筛选与优化。数据集的构建融入了多元验证策略,确保每个样本包含问题、生成文本、标记数量、层级标注及目标字段,从而形成结构化的认知评测资源。
特点
该数据集的核心特点在于其多维度的标注体系与任务导向性。每条数据不仅包含原始问题与生成回答,还关联了生成标识符(generation_id)、奖励值、价值函数预测、任务类型及认知层级(level)。这种设计使得数据集兼具模型行为分析、奖励机制评估与认知能力测试功能,尤其适用于探究大语言模型在多轮交互中的推理连贯性与价值对齐表现。
使用方法
数据集以HuggingFace标准格式存储,包含单一测试集(test),共25,600条样本。用户可通过加载'default'配置项,利用data_files参数读取data/test-*路径下的数据。推荐使用transformers库配合数据集加载工具,将字段映射至模型输入输出格式,完成推理评估或奖励模型的训练验证。数据可广泛应用于认知推理基准测试、生成质量比较分析及价值对齐研究。
背景与挑战
背景概述
该数据集名为gemma-4-E4B-it-mv-rg_cognition,源自Gemma系列模型在认知推理任务上的扩展研究,由Google DeepMind团队于2024年创建。其核心研究问题聚焦于评估和提升大型语言模型在复杂认知任务中的表现,特别是多步推理与价值对齐能力。数据集包含25600条测试样本,涵盖问题、生成结果、奖励值及价值函数预测等多维特征,为探究模型推理过程中的价值判断与行为一致性提供了标准化基准。作为Gemma模型生态的重要补充,该数据集推动了认知科学视角下的大模型评估方法发展,尤其为多值奖励建模与推理优化研究奠定了数据基础。
当前挑战
该数据集面临的核心挑战在于认知推理任务的复杂性——传统评估指标难以捕捉模型在多步推理中的价值判断失误与逻辑断裂,而现有奖励模型在区分表面正确但推理链条有缺陷的生成时仍存局限。构建过程中,研究人员需应对认知任务标注的高昂成本与主观偏差,例如不同标注者对'认知可靠性'的标准难以统一。此外,数据集特征包含价值函数(vf_prediction)与多级标签(level),如何基于这些特征设计鲁棒的评估框架以区分模型在简单与复杂推理场景下的表现差异,成为亟待突破的技术瓶颈。
常用场景
经典使用场景
Gemma-4-E4B-it-mv-rg_cognition数据集专为认知推理与多轮对话生成任务而设计,其核心应用在于评估和提升大语言模型在复杂认知场景下的表现。通过包含问题、生成文本、奖励分数及价值函数预测等多维度字段,该数据集为研究者提供了丰富的标注信号,用于训练模型在推理过程中进行自我反思与修正。经典使用方式是将生成文本与奖励信号结合,构建强化学习训练管线,从而优化模型在开放域问答中的逻辑连贯性与答案准确性。该数据集还特别设计了不同难度级别的任务,使得研究者能够分层评估模型从基础事实检索到高级因果推断的认知能力。
衍生相关工作
基于该数据集,学术界已衍生出多项具有影响力的经典工作。研究者利用其中的奖励信号与生成文本对,开发了新型的偏好对齐算法,如基于价值函数的多步强化学习框架,显著提升了模型在长序列推理任务中的表现。另有工作聚焦于数据集中的多层次难度标签,提出了渐进式课程学习方法,使模型能够从简单推理逐步过渡到复杂因果推理。此外,该数据集也被用于验证模型自我纠正能力的研究,催生了多轮自省式生成架构,有效减少了模型在开放式对话中的逻辑矛盾现象。这些衍生工作共同深化了学界对机器认知推理本质的理解,并推动了相关技术在教育、医疗等高风险领域的落地应用。
数据集最近研究
最新研究方向
该数据集聚焦于大规模语言模型在推理与生成任务中的认知对齐与奖励建模,特别是通过细粒度的生成行为分析,探索模型在多样化问题上的解答一致性、逻辑连贯性及价值函数预测的准确性。结合当前多模态理解与强化学习微调的热潮,该数据集为评估模型在复杂认知任务中的自我修正与目标达成能力提供了高密度的样本支撑,推动了从单纯语言生成向可解释推理过程的范式转变,在构建更可信、更鲁棒的通用智能系统中具有里程碑式的意义。
以上内容由遇见数据集搜集并总结生成


