
遇见数据集

electricsheepasia/asia-who-alcohol-0000001818

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

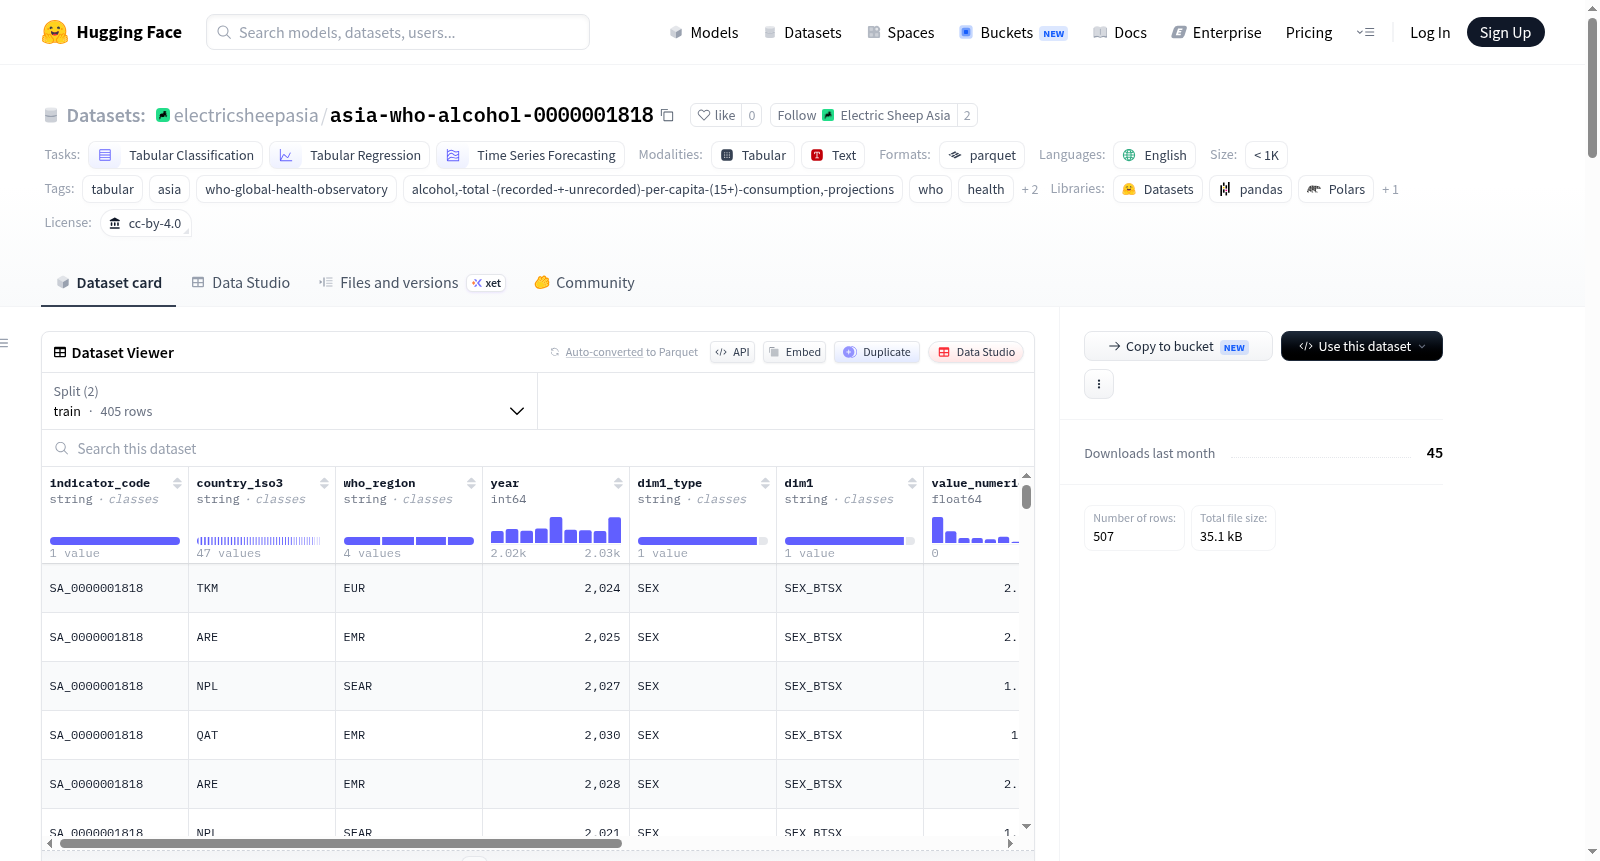
该数据集包含507个观测值,涉及“酒精,总计(记录+未记录)人均(15岁以上)消费量,预测”数据,覆盖47个亚洲国家,时间跨度为2021年至2030年,涵盖1个独特指标。数据来源于世界卫生组织全球健康观察站,主题聚焦于亚洲地区15岁及以上人群的人均酒精总消费量(包括记录和未记录的消费)的预测。数据集包括指标代码、国家ISO3代码、世界卫生组织区域、年份、维度类型(如性别)、数值估计值及其高低范围等列,适用于表格分类、回归和时间序列预测等任务。

This dataset contains 507 observations, involving forecast data on per capita total alcohol consumption (recorded + unrecorded) for individuals aged 15 years and above. It covers 47 Asian countries, spans the period from 2021 to 2030, and includes one unique indicator. The data is sourced from the World Health Organization (WHO) Global Health Observatory. The core focus of this dataset is forecasting the per capita total alcohol consumption (including both recorded and unrecorded consumption) for people aged 15 years and older across Asia. The dataset provides columns including indicator code, country ISO3 code, WHO region, year, dimension type (e.g., gender), numerical estimated values, and their upper and lower bounds. It is suitable for tasks such as tabular classification, regression, and time series forecasting.
提供机构:
electricsheepasia
搜集汇总
数据集介绍
electricsheepasia/asia-who-alcohol-0000001818 数据集图片
构建方式
该数据集源自世界卫生组织全球健康观察站(WHO GHO)发布的酒精消费预测数据,由Electric Sheep Asia团队进行整合与重包装。数据集聚焦于亚洲47个国家在2021至2030年间15岁以上人群的酒精总消费量(包括记录与未记录部分),共包含507条观测记录。数据以Parquet格式存储,并统一了架构,包括指标代码、国家ISO3代码、年份、性别维度、数值及其置信区间等字段,确保研究人员能够通过HuggingFace的`load_dataset()`函数快速加载并直接用于分析。
使用方法
用户可通过HuggingFace Datasets库直接调用,示例代码为`load_dataset("electricsheepasia/asia-who-alcohol-0000001818")`,加载后转换为pandas DataFrame即可进行灵活的数据操作。支持按国家筛选(如`df[df["country_iso3"] == "IDN"]`)以聚焦特定区域,或按指标代码排序并绘制时间序列图以观察变化趋势。亦可利用pivot_table将数据重塑为以年份为行、国家为列的矩阵形式,便于进行跨国的面板数据分析或机器学习建模。
背景与挑战
背景概述
亚洲地区作为全球酒精消费增长最为迅速的区域之一,其酒精摄入对公共健康的影响日益受到国际关注。世界卫生组织(WHO)下属的全球卫生观测站(GHO)长期致力于收集并发布全球健康指标数据,以支持循证决策。在此背景下,Electric Sheep Asia于2024年对WHO GHO的原始数据进行了重新整合,构建了名为asia-who-alcohol-0000001818的数据集。该数据集聚焦于亚洲47个国家2021至2030年间15岁以上人群的酒精总消费(含记录与未记录部分)预测值,共包含507条观测记录。通过标准化架构与Parquet格式封装,该数据集为流行病学、公共政策建模以及时间序列预测研究提供了高可获取性的基础资源,推动了对亚洲酒精消费趋势及健康干预策略的深入探索。
当前挑战
该数据集所应对的核心领域挑战在于,亚洲各国酒精消费数据普遍存在统计口径不一、记录覆盖不全以及预测模型缺乏统一基准的问题。WHO GHO虽提供权威指标,但原始数据分散、格式各异,研究者难以直接用于跨区域比较与机器学习的端到端分析。在构建过程中,面临的关键挑战包括:需要从多个异构数据源中提取并校验超过500条时间序列记录,确保47个国家的数据在年份跨度上完整且一致;同时,处理酒精单位、人口基数等维度差异,并生成可靠的低值、高值置信区间,以反映预测不确定性。此外,数据集的持续更新与维护也需应对WHO数据发布节奏的变化,保证长期研究的时效性。
常用场景
经典使用场景
该数据集最经典的使用场景在于对亚洲地区未来十年(2021-2030年)人均酒精消费量进行建模与趋势分析。依托世界卫生组织全球健康观察站的权威统计数据,研究者可利用其包含的507条观测记录、覆盖47个亚洲国家的面板数据,开展时间序列预测、回归分析或分类任务。通过整合国家ISO代码、年份、性别维度及消费量的点估计与置信区间,能够系统性地刻画亚洲各国酒精消费的时空演变轨迹,为公共卫生领域的宏观趋势研判提供坚实的数据底座。
解决学术问题
该数据集有效解决了亚洲区域酒精消费长期预测数据匮乏的学术瓶颈。传统研究常受限于碎片化的调查数据或过时的统计年鉴,难以支撑跨国家、长周期的比较分析。此数据集提供了标准化、机器可读的纵向面板结构,使得研究者能够量化酒精消费与经济社会发展指标之间的动态关联,检验政策干预效果,并识别高风险群体。其开放许可与可复现的预处理流程,显著降低了跨国健康经济学研究的数据门槛,推动了循证决策的科学化进程。
实际应用
在实际应用层面,该数据集为公共卫生决策者与政策分析师提供了精准的数据支撑。基于人均酒精消费量的时间序列与国别对比,可辅助各国卫生部门识别超量饮酒趋势,制定差异化的限酒法规与税收调节方案。同时,保险公司与健康科技企业能借此评估区域健康风险,设计有针对性的健康管理产品。非政府组织亦可利用其置信区间信息,在资源有限的地区优先部署酒精危害干预项目,实现公共卫生资源的优化配置。
数据集最近研究
最新研究方向
该数据集聚焦于亚洲地区成人人均酒精消费量的预测趋势,属于全球健康监测与公共卫生政策评估的前沿交叉领域。结合WHO全球健康观察站的数据权威性,研究者可基于2021至2030年的时序预测,分析亚洲47国的酒精消费模式演变,尤其关注性别维度(如SEX_BTSX分层)下的差异。近期热点事件包括世界卫生组织推动的《2022-2030年全球酒精行动计划》,该数据集为评估亚洲区域酒精控制政策成效提供了量化基础,助力揭示经济增长与消费风险的关联,对预防非传染性疾病、优化健康干预资源配置具有重要学术与实践意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

