us-federal-awards-usaspending-dataset
收藏资源简介:
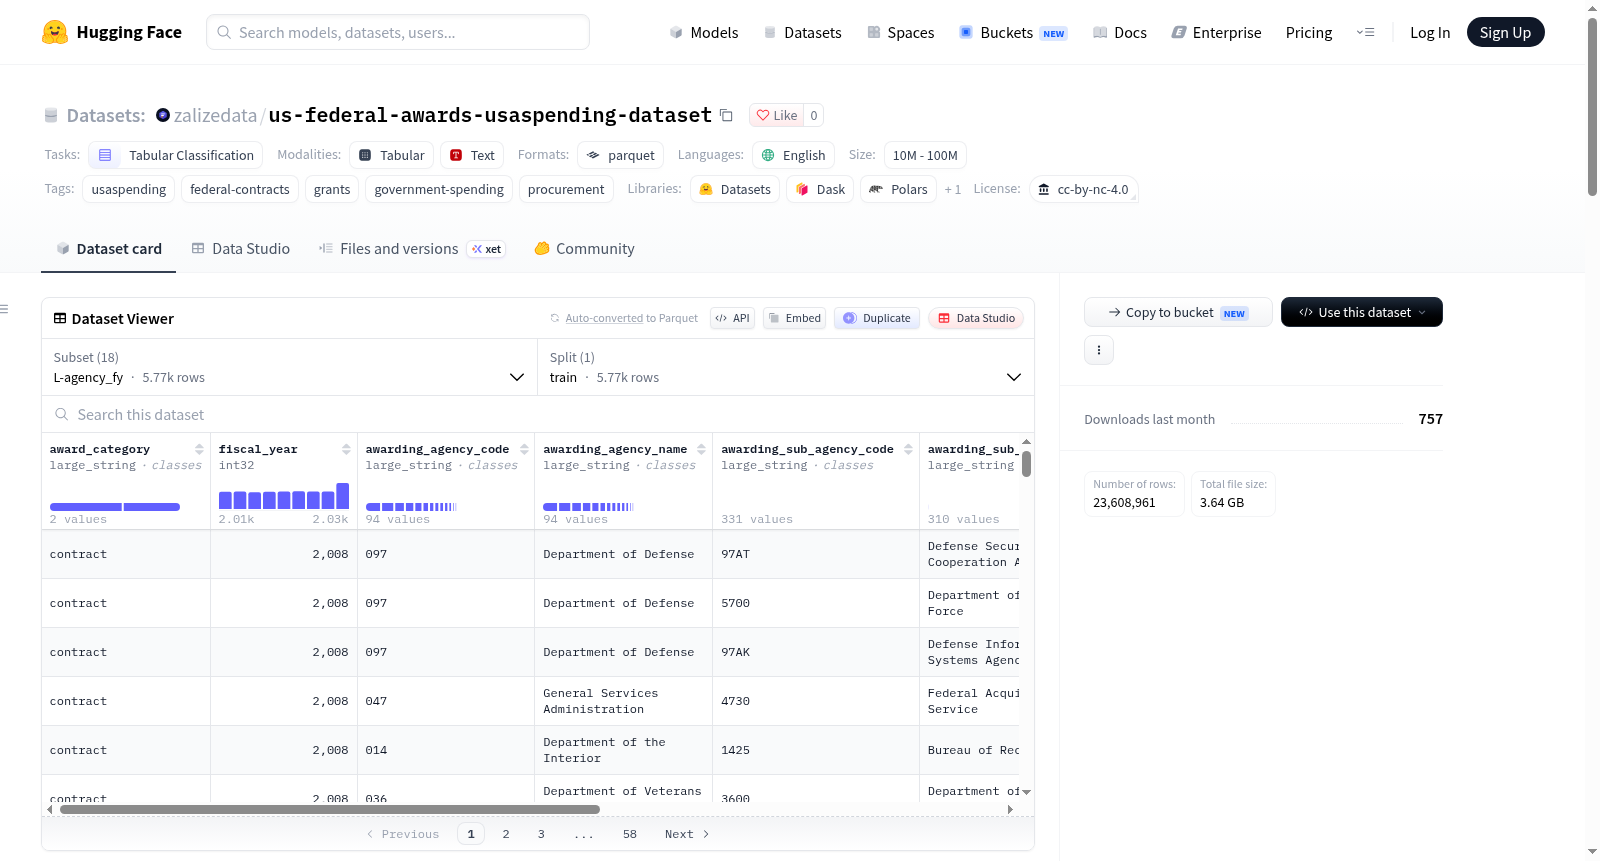
US Federal Awards & Spending (USAspending) 数据集基于美国官方USAspending.gov档案(2008财年至今),提供联邦合同、拨款和援助奖励数据,以分析就绪的表格形式呈现,包含接收方、机构、金额和奖励元数据。数据集分为三个层级(S、M、L),分别对应精简版、研究版和完整版,每个层级包含多个配置表,如按机构-财年、合同奖励、NAICS代码、接收方概况等。数据格式为Snappy压缩的Parquet文件,总规模在1000万到1亿行之间,语言为英文,适用于表格分类任务。该数据集可用于政府市场规模评估、投标情报、接收方和供应商分析、资助格局研究等场景。许可证为CC BY-NC 4.0(学术/个人使用),商业使用需获取商业许可。
The US Federal Awards & Spending (USAspending) dataset provides federal contract, grant, and assistance award data from the official USAspending.gov archive (FY2008-present), presented in analysis-ready tabular format including recipient, agency, amount, and award metadata. It is organized into three tiers (S, M, L) corresponding to lite, research, and full versions, each containing multiple configuration tables such as by agency-fiscal year, contract awards, NAICS code, recipient profiles, etc. The data is in Snappy-compressed Parquet format, with total rows ranging from 10 million to 100 million, language English, suitable for tabular classification tasks. This dataset can be used for government market size assessment, bid intelligence, recipient and supplier analysis, funding landscape research, etc. License: CC BY-NC 4.0 (academic/personal use), commercial use requires a commercial license.
数据集概述:美国联邦奖励与支出(USAspending)
基本信息
- 数据集名称:US Federal Awards & Spending (USAspending)
- 语言:英语
- 许可协议:CC BY-NC 4.0(知识共享-非商业使用)
- 任务类型:表格分类(tabular-classification)
- 数据规模:10M < n < 100M 行
- 时间范围:2008财年至今(FY2008–present)
数据来源与背景
该数据集基于 USAspending.gov 官方存档构建,涵盖美国联邦合同、拨款及援助奖励数据,由 DataForge 开放数据项目整理并提供。数据经整理为可直接分析的表格式数据,包含受助方、机构、金额及奖励元数据。
数据集分层(Tiers)
数据集分为三个层级,对应不同数据规模与用途:
| 层级 | 说明 | 包大小 |
|---|---|---|
| S | 近期奖励记录入门切片 | 1.45 GB |
| M | 跨奖励类型和年份的研究包 | 3.84 GB |
| L | 完整存档:FY2008–至今的奖励与交易表 | 1.04 GB |
数据配置(Configs)
数据集共包含 18 个配置,按层级(S/M/L)与表格类型划分:
| 表格类型 | S层级 | M层级 | L层级 |
|---|---|---|---|
| agency_fy(机构/财年) | ✓ | ✓ | ✓ |
| contract_awards(合同奖励) | ✓ | ✓ | — |
| naics_fy(NAICS行业/财年) | ✓ | ✓ | ✓ |
| recipient_profiles(受助方档案) | ✓ | ✓ | ✓ |
| assistance_awards(援助奖励) | — | ✓ | — |
| cfda_fy(CFDA/财年) | — | ✓ | ✓ |
| recipient_fy(受助方/财年) | — | ✓ | ✓ |
| state_fy(州/财年) | — | ✓ | ✓ |
所有数据以 snappy-parquet 格式存储于 data/<tier>/ 目录下。
数据内容与用途
主要应用场景
- 政府市场规模分析与投标情报
- 受助方与供应商分析
- 拨款资金格局研究
- 通过UEI/DUNS将奖励关联至注册库
数据包内容
每个原始压缩包内包含:
- CSV及Parquet格式数据
- 数据字典(DATA-DICTIONARY)
- 数据表(DATASHEET,含FCRA禁止使用声明)
- 质量保证报告(QA report)
使用方式
python from datasets import load_dataset
ds = load_dataset("zalizedata/us-federal-awards-usaspending-dataset", "S-agency_fy", split="train") print(ds[0])
许可说明
- 学术/个人使用:采用 CC BY-NC 4.0 许可,需注明出处并回链至 https://data.zalize.com
- 商业使用:需获取 DataForge 商业许可
- 上游数据:来自美国官方 USAspending.gov 存档,属于公共领域(17 U.S.C. §105)
引用方式
text DataForge (data.zalize.com), built from official USAspending.gov archives — https://data.zalize.com/datasets/us-federal-awards-usaspending-dataset
DOI: 10.5281/zenodo.21837786