
遇见数据集

elene234/trip-planner-eval-results

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

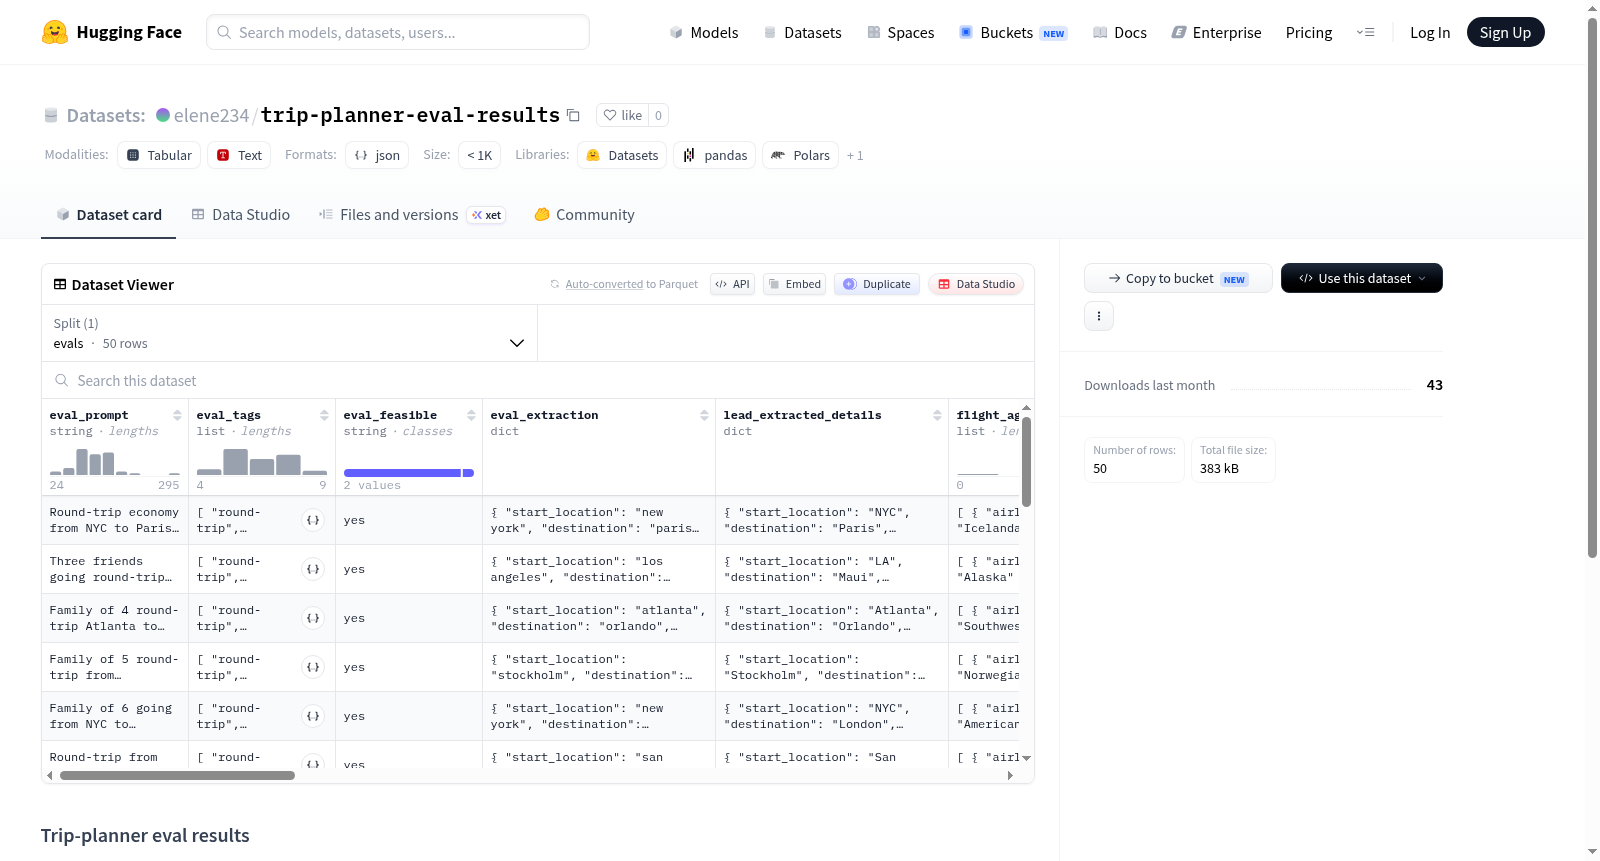
该数据集包含每行三个选定行程的评估对齐分数、针对评估真实值的分数以及自由格式的注释。它基于[elene234/trip-planner-evals-outputs]数据集构建。每行数据包含源输出行的所有列,以及以下额外列:`eval_choice_1_flight`、`eval_choice_1_hotel`(选定行程1的航班和酒店对齐分数,范围为0-1),`eval_choice_2_flight`、`eval_choice_2_hotel`(选定行程2的相同分数),`eval_choice_3_flight`、`eval_choice_3_hotel`(选定行程3的相同分数),以及`note`(评估者的单句总体观察)。

This dataset contains, for each row, evaluation alignment scores for three selected trips, scores against the ground truth, and free-form annotations. It is constructed based on the [elene234/trip-planner-evals-outputs] dataset. Each row includes all columns from the source output row, plus the following additional columns: `eval_choice_1_flight`, `eval_choice_1_hotel` (alignment scores for flight and hotel of selected trip 1, ranging from 0 to 1), `eval_choice_2_flight`, `eval_choice_2_hotel` (the same scores for selected trip 2), `eval_choice_3_flight`, `eval_choice_3_hotel` (the same scores for selected trip 3), and `note` (the rater's single-sentence overall observation).
提供机构:
elene234
搜集汇总
数据集介绍
elene234/trip-planner-eval-results 数据集图片
构建方式
该数据集是在elene234/trip-planner-evals-outputs数据集基础上构建的评估结果集合。通过引入专家评判机制,为每个样本中的三条备选行程分别计算航班与酒店的对齐分数,从而量化生成行程与真实标注之间的一致性程度。每条记录不仅保留了源数据集的所有字段,还新增了六个浮点数类型的评估指标以及一段自由文本形式的综合评价,形成结构清晰且信息完备的评估数据集。
特点
该数据集的核心特色在于其多维度的细粒度评估架构。通过将行程拆解为航班和酒店两个独立维度,分别赋予0到1之间的对齐分数,能够精准捕捉生成结果在各关键环节的吻合程度。同时,每条数据均附带一条由评审人员撰写的一句话总体评语,为定量指标提供了定性解读的补充视角,使得评估结果既具有统计可比性,又不失语境化的深度。
使用方法
该数据集主要面向行程规划系统的性能评估场景。研究人员可借助其中的对齐分数,对模型生成的三条备选行程进行逐项打分比较,从而识别系统在航班推荐与酒店匹配方面的优势与短板。同时,文本形式的评语可作为案例分析的依据,辅助研究者理解分数背后的具体原因,进而指导模型迭代与优化方向。
背景与挑战
背景概述
该数据集诞生于智能行程规划系统评估领域,由研究人员elene234及其团队构建,旨在解决自动化旅行规划结果的质量度量问题。随着大语言模型在复杂决策任务中的广泛应用,如何客观评估模型生成的行程方案成为关键挑战。该数据集聚焦于对三种备选旅行方案与人工标注基准的逐项对齐评分,涵盖航班与酒店两个核心维度,为行程规划系统的性能评估提供了标准化工具。通过引入0-1区间的对齐分数,研究者能够量化不同规划方案的细节匹配程度,从而推动该领域从定性分析向定量评估的范式转变。作为elene234/trip-planner-evals-outputs的衍生数据集,其在实证研究方法论上具有重要意义,为后续研究建立了可复现的评估基准。
当前挑战
当前面临的首要挑战在于旅行规划领域本身的多目标优化特性:优质行程需同时满足时间衔接、预算约束、用户偏好等相互冲突的指标,而现有数据集仅量化了航班和酒店两维度的对齐程度,未能涵盖景点路线、餐饮安排等更复杂的规划要素。在数据构建过程中,标注者需对三个备选方案逐一比对基准行程,这种细粒度评估易受主观判断偏差影响,尤其当基准方案本身存在语义歧义时,不同标注者可能产生分歧。此外,现有评分体系采用0-1连续值,但缺乏对评分可靠性的置信度度量,且自由文本注释的规范性不足,为后续的自动化评估训练带来了数据一致性挑战。
常用场景
经典使用场景
在智能旅行规划系统的评估与优化领域,trip-planner-eval-results数据集被广泛用于衡量多模态行程推荐算法的输出质量。研究者可借助该数据集中每条行程与人工标注的真值之间的对齐分数(flight与hotel维度),对模型生成的旅行方案进行细粒度的量化评价。该数据集特别适用于对比不同规划策略(如基于规则、强化学习或大语言模型)在航班与酒店组合上的匹配精度,从而筛选出最优的行程排序算法。其经典用法包括作为验证集参与模型迭代、构建自动化评估指标,以及监督学习场景下的弱监督信号生成。
实际应用
实际应用中,该数据集助力在线旅行社与差旅管理平台构建更稳健的智能规划引擎。通过对输出行程的实时评分,开发者可动态调整推荐策略,优先展示与用户隐式偏好(如偏好直飞航班或特定酒店品牌)契合度更高的方案。此外,数据集中的自由文本备注为产品迭代提供了诊断线索,例如分析低分行程是否源于数据稀疏导致的酒店推荐偏差。在旅行聚合应用如TripAdvisor或Expedia中,该工具还可用于A/B测试,量化新算法相对于基准模型的性能增益。
衍生相关工作
基于该数据集衍生的相关工作集中在评估指标创新与多任务联合学习两个方向。例如,研究者提出了加权对齐分数,将flight与hotel的得分通过用户历史行为特征进行自适应融合,改进了原始单一维度的评价方式。另一项经典工作利用该数据的对齐分数作为弱标签,训练端到端的行程排序模型,显著降低了对人工标注的依赖。此外,有团队基于数据集的备注文本生成细粒度评价报告,推动了可解释旅行推荐系统的发展。这些工作共同拓展了规划类任务评估的深度与自动化程度。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

