
arc-barc-processed-direct-max4k-abs-gemini-qwensols-full-0207-11of16
收藏数据链接:
官方服务:
资源简介:
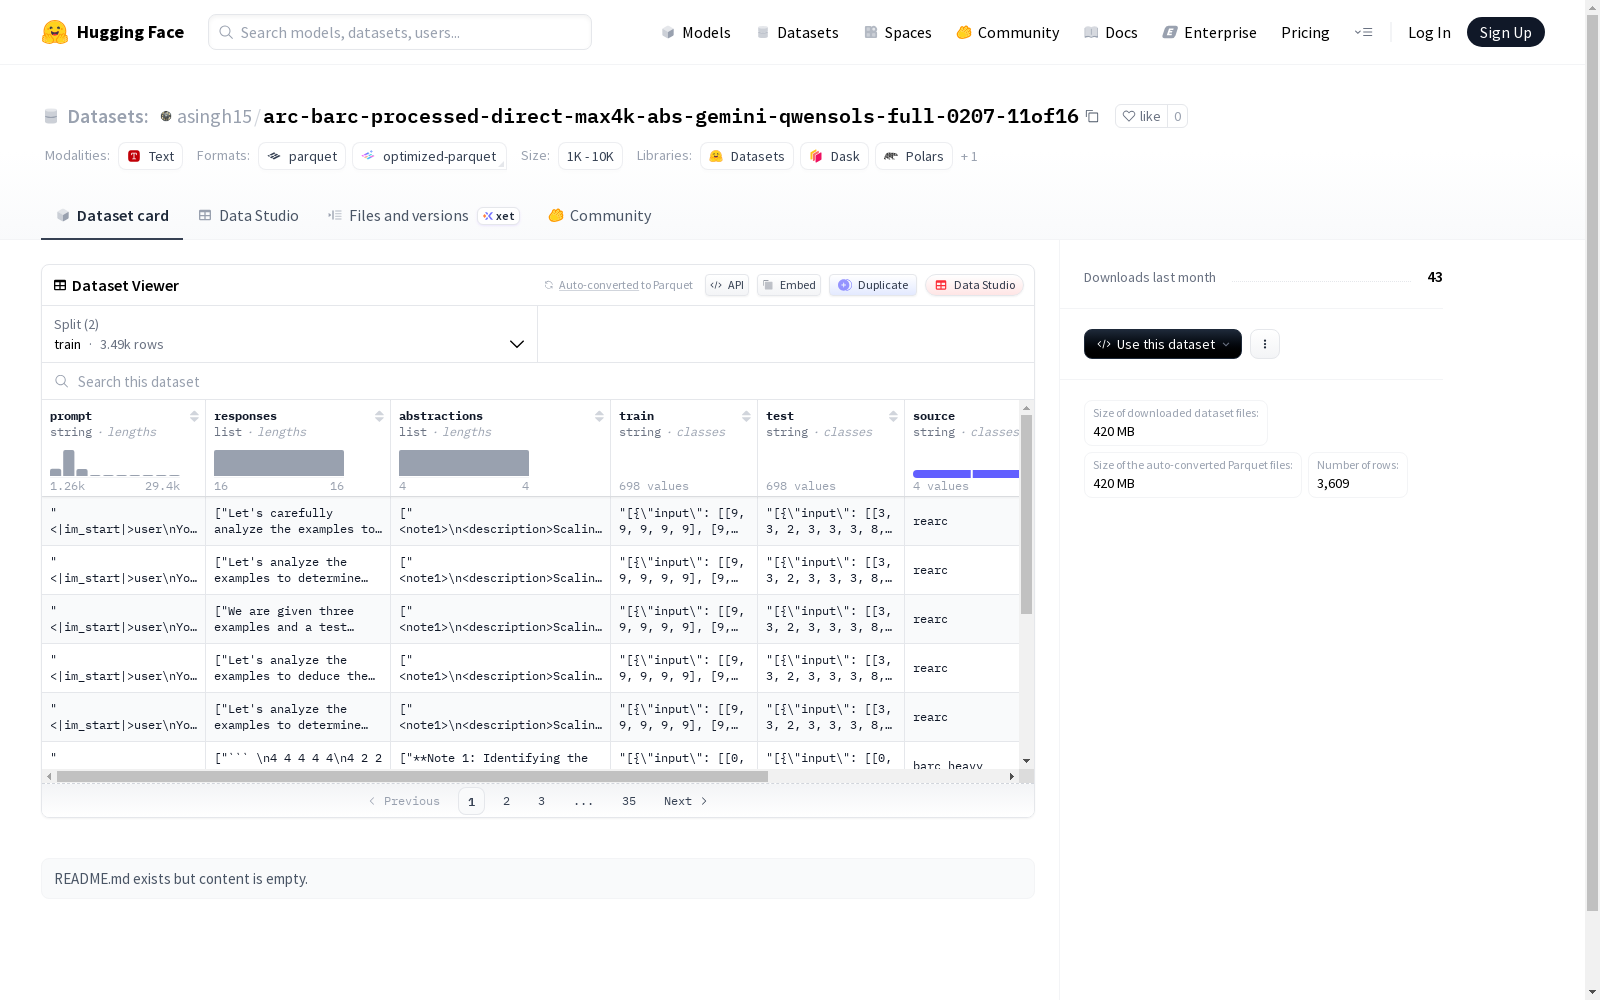
该数据集包含3000个训练样本,总大小为1.02GB。数据集包含以下字段:prompt(字符串类型)、responses(字符串列表)、abstractions(字符串列表)、train(字符串类型)、test(字符串类型)、source(字符串类型)、answer(字符串类型)以及num_tokens(int64类型)。数据仅包含训练集,未提供验证集或测试集。数据集采用默认配置,训练数据文件路径为data/train-*。
This dataset contains 3000 training samples with a total size of 1.02 GB. It comprises the following fields: prompt (string type), responses (list of strings), abstractions (list of strings), train (string type), test (string type), source (string type), answer (string type), and num_tokens (int64 type). The dataset only includes the training split, with no validation or test splits provided. The dataset uses the default configuration, and the path to the training data files is data/train-*.
创建时间:
2026-02-09
原始信息汇总
数据集概述
基本信息
- 数据集名称: arc-barc-processed-direct-max4k-abs-gemini-qwensols-full-0207-11of16
- 存储库地址: https://huggingface.co/datasets/asingh15/arc-barc-processed-direct-max4k-abs-gemini-qwensols-full-0207-11of16
数据集结构
特征(Features)
- prompt: 字符串类型。
- responses: 字符串列表类型。
- abstractions: 字符串列表类型。
- train: 字符串类型。
- test: 字符串类型。
- source: 字符串类型。
- answer: 字符串类型。
- num_tokens: 64位整数类型。
数据划分(Splits)
- 训练集(train):
- 样本数量: 3,490
- 数据大小: 1,186,841,006 字节
- 测试集(test):
- 样本数量: 119
- 数据大小: 43,081,789 字节
数据文件
- 默认配置(default):
- 训练集文件路径:
data/train-* - 测试集文件路径:
data/test-*
- 训练集文件路径:
存储信息
- 下载大小: 419,849,785 字节
- 数据集总大小: 1,229,922,795 字节
搜集汇总
数据集介绍
构建方式
在人工智能与自然语言处理领域,高质量的数据集是推动模型能力提升的关键。该数据集基于ARC(AI2 Reasoning Challenge)基准构建,通过精心的处理流程,将原始的科学问题转化为结构化格式。具体而言,它采用了直接处理方式,并利用Gemini与Qwen等先进模型生成抽象化表示与解答,确保每个样本包含提示、多轮响应、抽象概念以及标准答案。数据经过严格筛选与分块,最大长度限制在4K标记以内,最终形成包含训练集与测试集的完整语料库,为复杂推理任务提供了扎实的数据基础。
特点
该数据集在设计上展现出多维度特点,旨在支持高级语言模型的训练与评估。其核心特征在于融合了直接处理与抽象化表示,每条数据不仅包含原始问题与答案,还提供了由大模型生成的抽象概念,这有助于模型深入理解问题背后的逻辑结构。数据集规模适中,训练集包含3490个样本,测试集119个样本,覆盖了多样化的科学推理场景。此外,每个样本均标注了标记数量,便于研究者进行长度控制与资源优化,整体结构清晰,特征字段丰富,为后续的模型微调与性能分析提供了便利。
使用方法
对于研究人员而言,该数据集可直接应用于语言模型的训练与测试,特别是在科学推理与问答任务中。使用前,用户需从HuggingFace平台下载数据,并依据提供的特征字段进行加载。训练集可用于微调模型,通过提示与响应序列学习复杂的推理模式;测试集则用于评估模型性能,验证其泛化能力。在实际操作中,建议结合抽象概念字段进行多任务学习,以增强模型的解释性。数据已按标准格式分割,支持直接集成到主流机器学习框架中,简化了实验流程,加速了研究进展。
背景与挑战
背景概述
在人工智能与自然语言处理领域,高质量指令微调数据集的构建对于提升大型语言模型的推理与泛化能力至关重要。数据集'arc-barc-processed-direct-max4k-abs-gemini-qwensols-full-0207-11of16'由研究团队于2024年2月7日创建,其核心目标在于整合并优化抽象推理与问答任务的数据资源。该数据集基于ARC(AI2 Reasoning Challenge)与BARC(Bridging Analogical Reasoning Corpus)等经典基准,通过多阶段处理流程,旨在解决复杂推理场景下模型对抽象概念的理解与生成挑战。其设计不仅促进了指令跟随模型的性能评估,也为跨领域知识迁移与上下文学习提供了结构化支持,对推动认知智能的发展具有显著意义。
当前挑战
该数据集所针对的领域挑战在于抽象推理任务中模型对隐含逻辑关系的捕捉与多步推理的稳健性。传统问答系统往往局限于表面模式匹配,难以处理需要深层语义解析与类比迁移的复杂问题。在构建过程中,研究人员面临数据清洗与标准化的难题,原始ARC与BARC数据包含多样化的表述形式与噪声,需通过自动化与人工结合的方式进行对齐与去重。同时,生成高质量抽象摘要与多轮响应涉及语义保真度与一致性的平衡,确保生成内容既简洁又准确成为关键。此外,数据规模与计算资源的限制也要求对长文本进行有效截断与编码,以适配现代语言模型的输入约束。
常用场景
经典使用场景
在人工智能与自然语言处理领域,该数据集以其精心构建的提示-响应结构,为大型语言模型的指令微调提供了关键资源。其经典使用场景聚焦于模型对齐与泛化能力评估,研究者通过训练集中的多样化提示与响应配对,引导模型学习复杂推理与抽象思维,进而在测试集上验证模型对未见指令的适应性和准确性,从而推动对话系统与智能助手的性能优化。
实际应用
在实际应用层面,该数据集可广泛应用于智能客服、教育辅助与内容生成等场景。基于其丰富的指令-响应数据,企业能够训练出更精准理解用户意图、提供连贯且个性化回复的对话系统,提升服务效率与用户体验。同时,它在自动化报告撰写、代码生成等专业领域也展现出潜力,助力实现高效、可靠的人机协作。
衍生相关工作
围绕该数据集,学术界已衍生出一系列经典研究工作,主要集中在指令调优、多轮对话建模与抽象推理增强等方面。这些工作利用数据集的层次化结构,探索了模型在少样本学习、跨任务迁移中的表现,并推动了如基于人类反馈的强化学习等前沿技术的发展,为构建更安全、可控且智能的语言模型提供了重要参考与启发。
以上内容由遇见数据集搜集并总结生成


