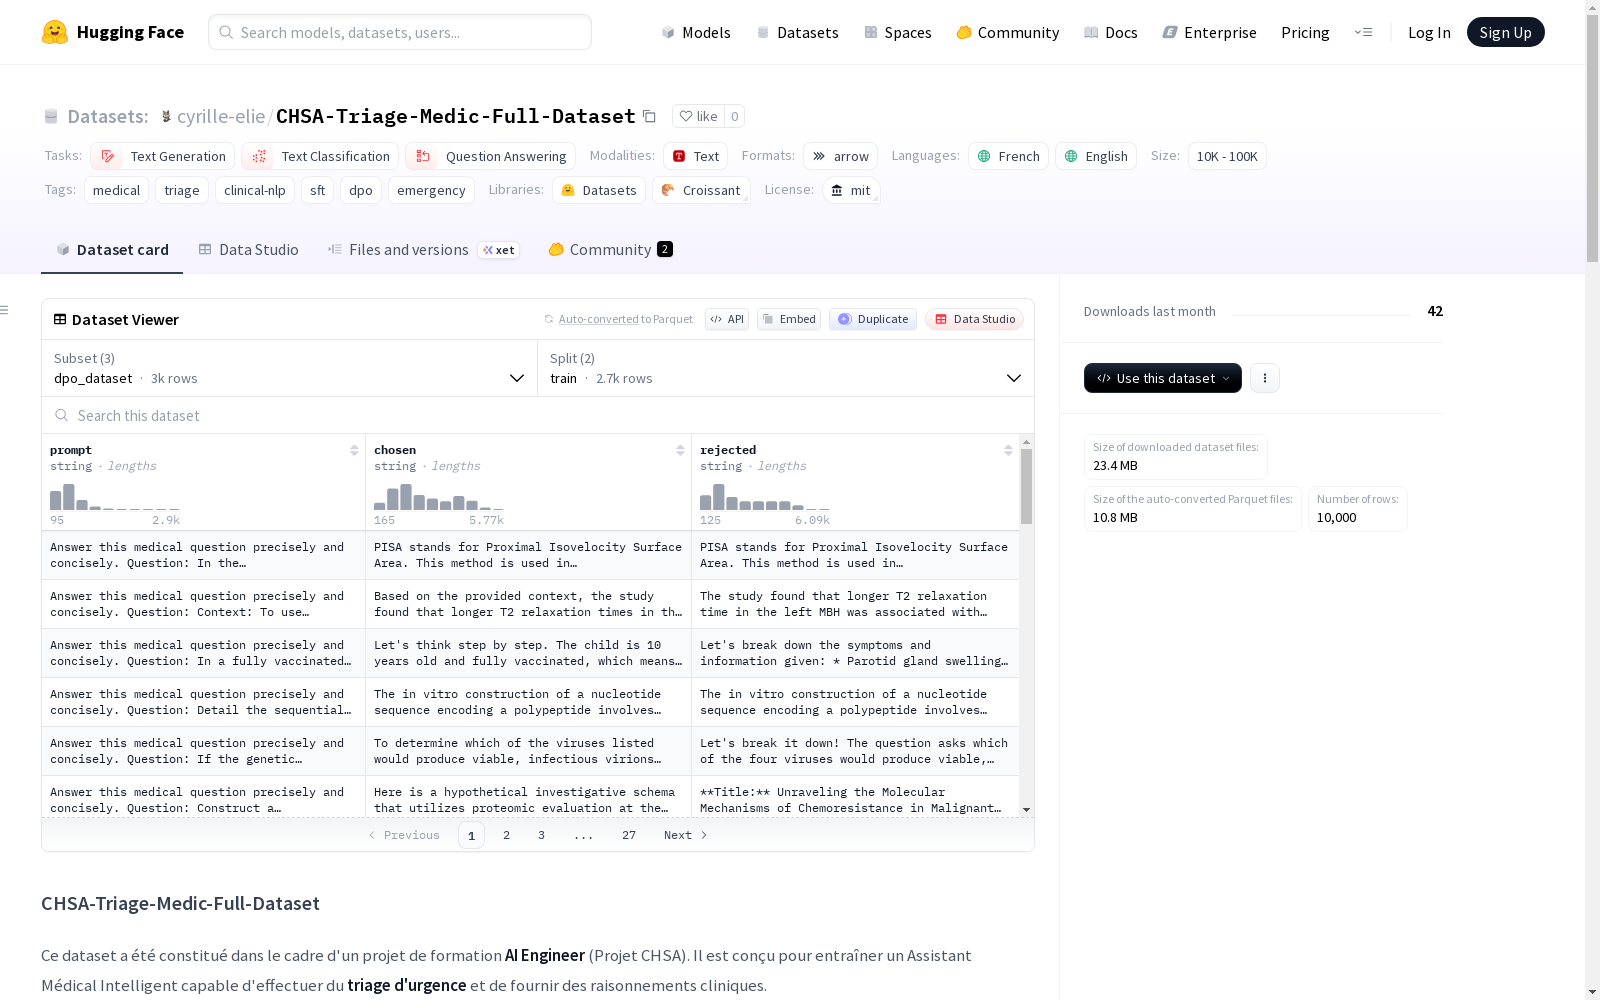
CHSA-Triage-Medic-Full-Dataset
收藏资源简介:
该数据集是为训练能够进行紧急分诊和提供临床推理的智能医疗助手而构建的。它分为三个子集,分别对应不同的训练阶段:监督微调(SFT)包含一般医学知识和临床案例,SFT专家数据集专注于紧急分诊的合成数据,以及用于直接偏好优化(DPO)的对齐数据集。数据集包含法语和英语内容,适用于文本生成、文本分类和问答任务。
This dataset is developed for training intelligent medical assistants capable of emergency triage and clinical reasoning. It is divided into three subsets corresponding to distinct training stages: the Supervised Fine-Tuning (SFT) subset containing general medical knowledge and clinical cases, the SFT expert subset focusing on synthetic data for emergency triage, and the alignment dataset for Direct Preference Optimization (DPO). The dataset covers content in both French and English, and is applicable to tasks such as text generation, text classification, and question answering.
CHSA-Triage-Medic-Full-Dataset 数据集概述
数据集基本信息
- 名称:CHSA Triage Medic Full
- 语言:法语(fr)、英语(en)
- 许可证:MIT
- 任务类别:文本生成、文本分类、问答
- 标签:医疗、分诊、临床自然语言处理、监督微调、直接偏好优化、急诊
- 规模类别:10K < n < 100K
- 配置数量:3
数据集背景与目的
该数据集是在 AI Engineer 项目(CHSA项目)框架下构建的,旨在训练一个能够进行紧急分诊并提供临床推理的智能医疗助手。数据集分为三个不同的子集,对应于训练的不同阶段(监督微调和对齐)。
数据集组织与配置
1. 配置:sft_medical_dataset
此子集包含多样化的学术和临床医疗数据(经转换的多项选择题、临床案例)。数据在法语和英语之间保持50%的平衡,并已通过 Microsoft Presidio 进行匿名化处理。
- 数据划分:
train(5000个样本),validation(500个样本) - 数据来源:FrenchMedMCQA, MediQAl, MedQuAD
数据格式
| 列名 | 类型 | 描述 |
|---|---|---|
instruction |
string | 系统提示 + 问题或临床案例。 |
response |
string | 预期的医疗回答或案例分析。 |
source_dataset |
string | 数据来源(例如:MediQAl-mcqu, MedQuAD)。 |
language |
string | fr 或 en。 |
anonymized |
bool | 如果实体(姓名、日期、电话)已被屏蔽,则为 True。 |
2. 配置:sft_expert_dataset
此子集由高质量的合成数据构成,旨在向模型传授特定的分诊逻辑(最高紧急程度、中度紧急、延迟处理)。它使用数据增强技术(医学术语同义词)来避免过拟合。
- 数据划分:
train(1500个样本) - 数据来源:通过经验证的专家模板(CHSA)进行合成生成。
数据格式
| 列名 | 类型 | 描述 |
|---|---|---|
instruction |
string | 包含系统提示(角色)+ 患者陈述(例如:“82岁女性,呼吸窘迫...”)。 |
response |
string | 强制的“思维链”结构:分析(症状 + 体征) + 判定(紧急程度级别)。 |
3. 配置:dpo_dataset
此子集用于对齐阶段(DPO - 直接偏好优化)。它使模型学会优先选择详细、结构化且临床准确的回答,而不是模糊或不正确的回答。
- 数据划分:
train(约90%),test(约10%) - 数据来源:UltraMedical-Preference(经过调整和过滤)。
数据格式
| 列名 | 类型 | 描述 |
|---|---|---|
prompt |
string | 提交给模型的医疗问题或临床案例。 |
chosen |
string | 最佳回答(被接受的回答),注重细节和临床准确性。 |
rejected |
string | 较差回答(被拒绝的回答),通常过于简短、模糊或存在幻觉。 |
数据加载示例
可以使用 datasets 库按需单独加载配置:
python
from datasets import load_dataset
1. 加载通用SFT数据集(训练 + 验证)
ds_medical = load_dataset("cyrille-elie/CHSA-Triage-Medic-Full-Dataset", "sft_medical_dataset")
2. 加载专家SFT数据集(纯分诊)
ds_expert = load_dataset("cyrille-elie/CHSA-Triage-Medic-Full-Dataset", "sft_expert_dataset")
3. 加载DPO数据集(对齐)
ds_dpo = load_dataset("cyrille-elie/CHSA-Triage-Medic-Full-Dataset", "dpo_dataset")
示例:显示数据
print(ds_expert[train][0])