OpenForesight
收藏资源简介:
OpenForesight数据集是一个用于预测问题的数据集,这些问题是从带有检索增强提示的新闻文章中生成的。该数据集旨在评估AI模型利用相关上下文对未来事件进行预测的能力。数据集包含52,692个预测问题,分为训练集(52,183个问题)、验证集(207个问题)和测试集(302个问题)。问题来源于多个新闻媒体,涵盖2025年5月至8月的事件。数据集结构包括问题标题、背景信息、解决标准、答案类型、答案、新闻文章全文、发布日期等多个字段。数据生成过程涉及新闻文章处理、问题生成、检索增强和问题验证等步骤。数据集支持多种答案类型,如地理位置、人名、日期等。
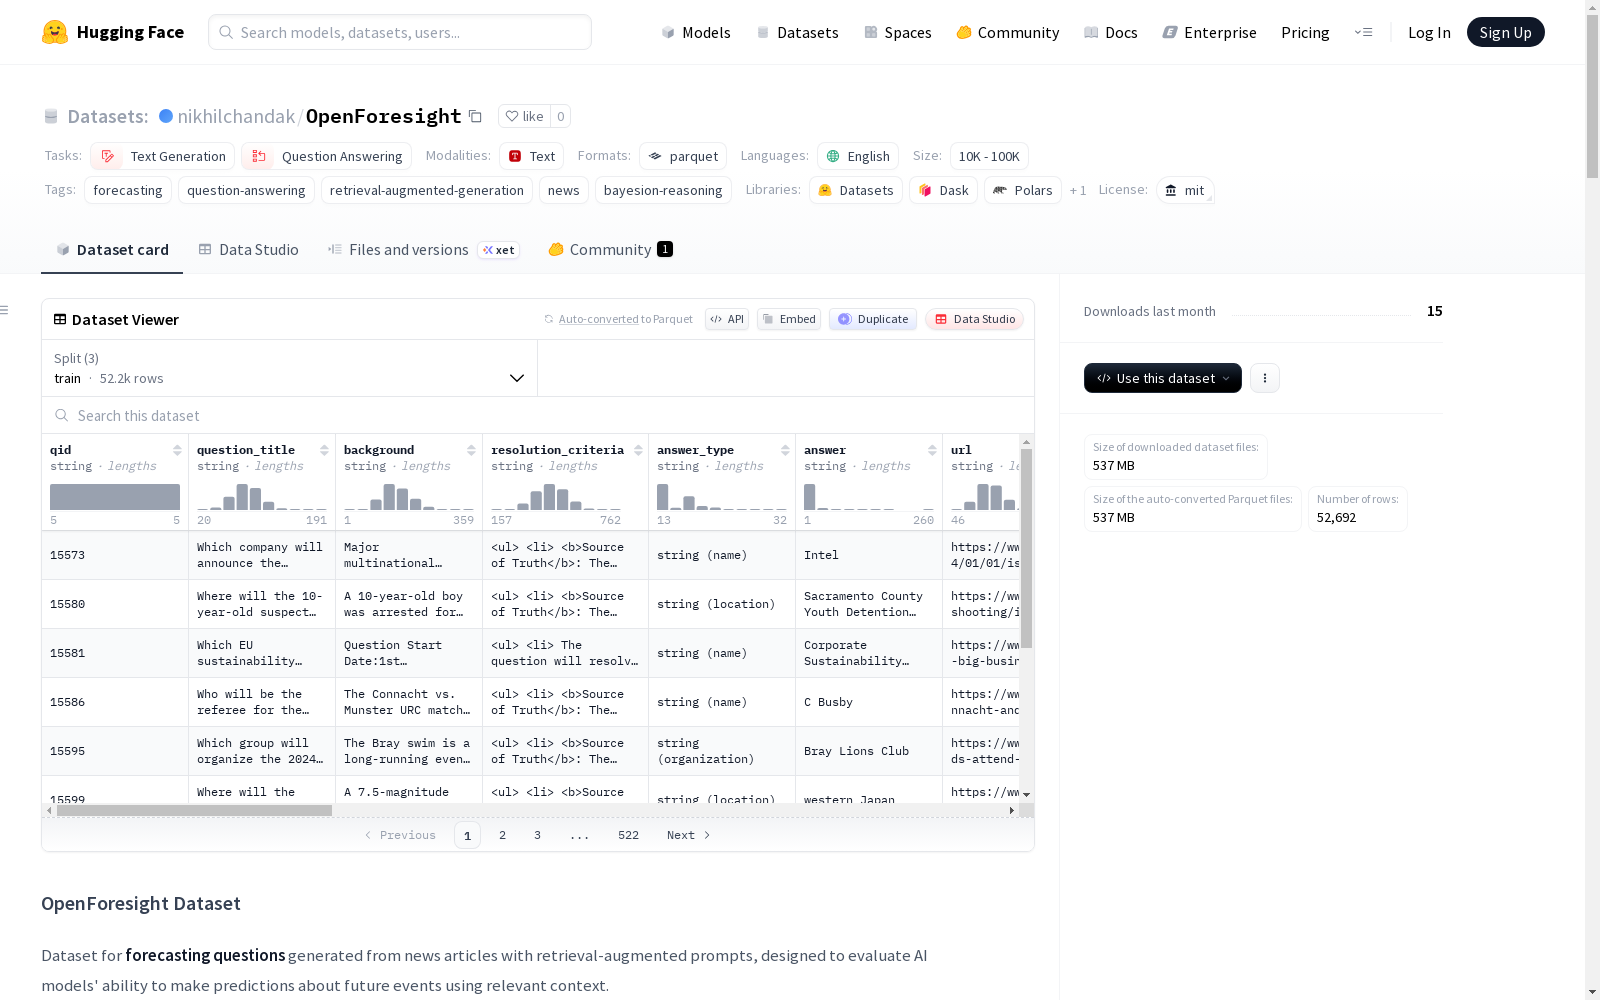
The OpenForesight Dataset is a prediction-focused dataset where the prediction questions are generated from news articles with retrieval-augmented prompting. It is designed to evaluate the capability of AI models to leverage relevant contextual information to forecast future events. The dataset comprises 52,692 prediction questions, divided into a training set (52,183 questions), a validation set (207 questions), and a test set (302 questions). The questions are sourced from multiple news media outlets and cover events taking place between May and August 2025. The dataset structure includes multiple fields such as question title, background information, resolution criteria, answer type, answer, full text of the news article, publication date, and more. The data generation workflow involves several steps including news article preprocessing, question generation, retrieval augmentation, and question validation. The dataset supports a diverse range of answer types, such as geographic locations, personal names, dates, and others.
OpenForesight 数据集概述
数据集基本信息
- 名称: OpenForesight
- 许可证: MIT
- 主要任务类别: 文本生成、问答
- 语言: 英语
- 核心标签: 预测、问答、检索增强生成、新闻、贝叶斯推理
- 数据规模: 10K<n<100K
数据集内容与规模
- 总问题数: 52,692 个预测性问题
- 训练集: 52,183 个问题
- 验证集: 207 个问题
- 测试集: 302 个问题
- 时间覆盖范围: 2025年5月至8月的事件
数据结构与字段
数据集包含以下字段:
qid: 唯一问题标识符question_title: 主要预测问题background: 问题的背景信息resolution_criteria: 问题解决标准的HTML格式描述answer: 问题的真实答案answer_type: 答案类型(例如:"string (location)"、"string (name)"、"string (date)")url: 源新闻文章的URLarticle_maintext: 新闻文章的全文内容article_publish_date: 文章发布日期(YYYY-MM-DD格式)article_modify_date: 文章最后修改日期(YYYY-MM-DD格式)article_download_date: 文章下载日期(YYYY-MM-DD格式)article_title: 新闻文章标题article_description: 新闻文章描述/摘要data_source: 数据生成过程的源标识符news_source: 发布文章的新闻媒体question_start_date: 预测问题的开始日期(YYYY-MM-DD格式)resolution_date: 问题解决日期(YYYY-MM-DD格式)prompt: 包含检索到的新闻文章的完整预测提示prompt_without_retrieval: 用于基线比较的无检索文章提示
数据来源与划分
训练集来源
- Hindustan Times
- Irish Times
- Forbes
- CNN
- DW
验证集来源
- The Guardian
测试集来源
- Al Jazeera
- The Guardian
- Time
- NDTV
- Fox News
答案类型
- 字符串(位置): 地理位置、地点、场所
- 字符串(名称): 人名、公司名、产品名
- 字符串(日期): 具体日期或时间段
- 字符串: 一般文本答案
数据生成过程
- 文章处理: 收集和处理新闻文章以提取相关信息
- 问题生成: 语言模型根据文章内容生成预测性问题
- 检索增强: 检索相关新闻文章并将其纳入提示中
- 问题验证: 验证生成的问题是否确实由源文章解决(按日期)以及问题是否具体且正确
- 质量控制: 根据相关性和质量过滤问题
预期用途与评估
- 主要用途: 评估AI模型,特别是检索增强生成模型的预测能力
- 关键评估指标:
- 准确性
- 置信度校准
- 时序推理能力
- 检索影响(有/无检索上下文的性能比较)
- 领域知识理解
使用方式
可通过Hugging Face datasets 库加载使用:
python
from datasets import load_dataset
dataset = load_dataset("nikhilchandak/OpenForesight")