
wildchat-5k-writing-1k-pref
收藏官方服务:
资源简介:
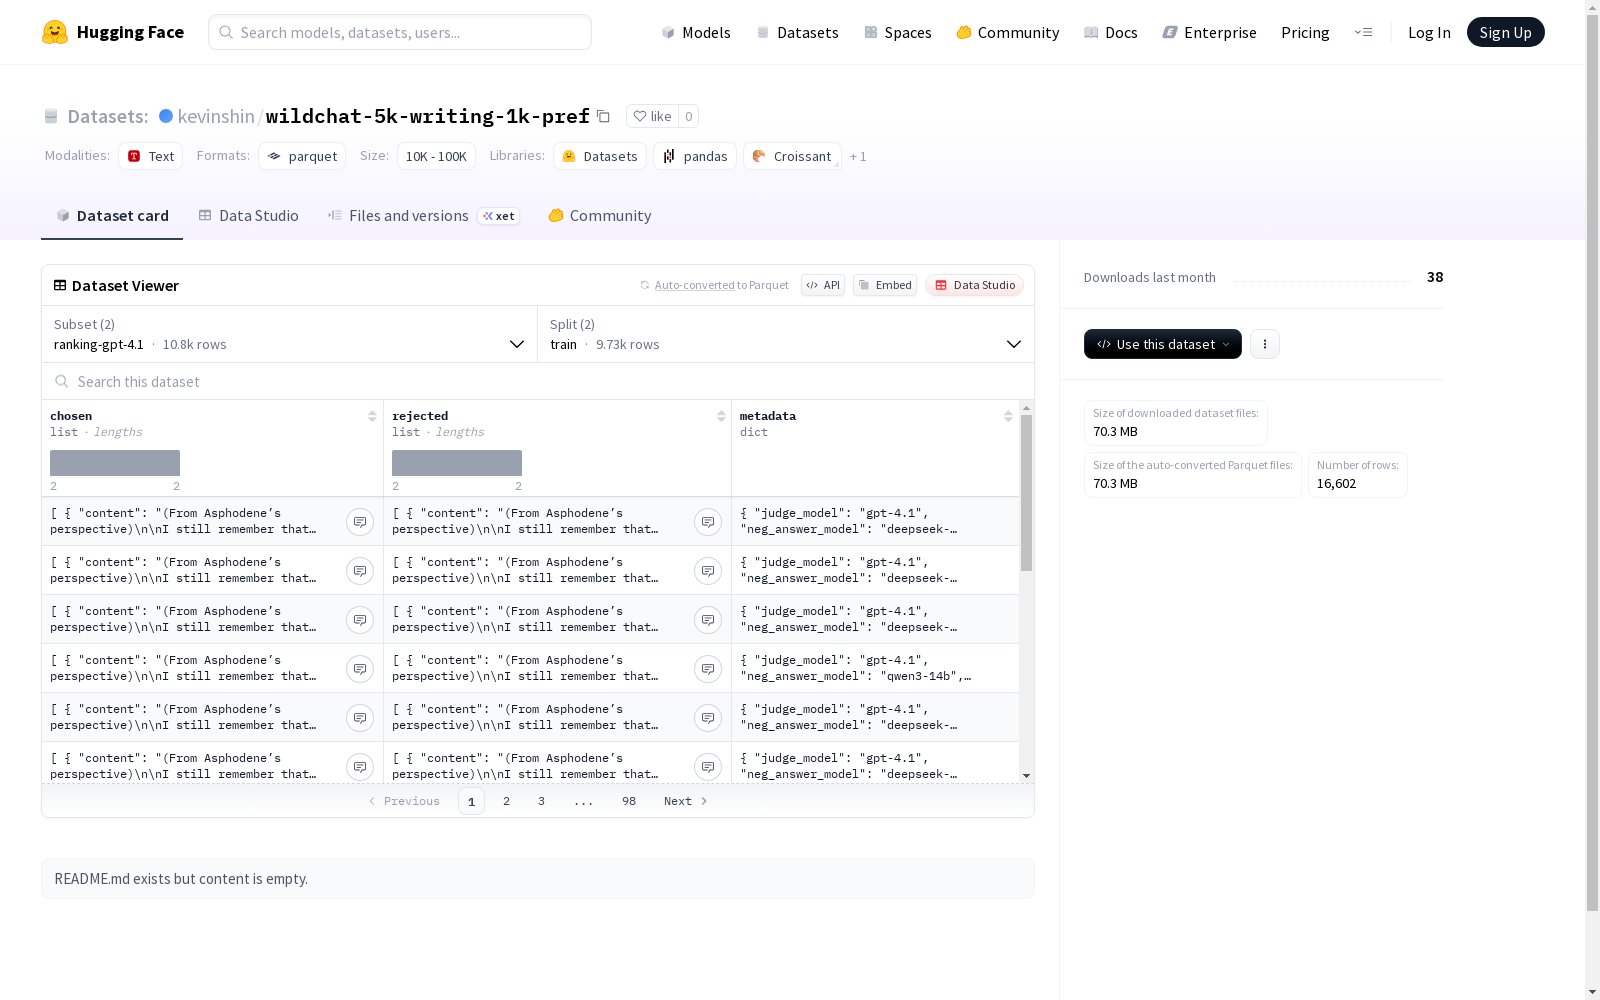
这是一个包含两个配置的数据集,每个配置都包括选中和拒绝的内容及其角色,以及评判、否定和肯定回答的元数据信息。数据集分为训练集和验证集,用于训练和评估模型。
This is a dataset consisting of two configurations. Each configuration includes selected and rejected content along with their respective roles, as well as metadata related to judgments, negative and positive responses. The dataset is split into training and validation subsets for model training and evaluation.
创建时间:
2025-08-05
原始信息汇总
数据集概述
基本信息
- 数据集名称: wildchat-5k-writing-1k-pref
- 数据集地址: https://huggingface.co/datasets/kevinshin/wildchat-5k-writing-1k-pref
- 下载大小:
- ranking-gpt-4.1: 93,563,078 bytes
- ranking-qwen3-4b: 59,647,073 bytes
- 数据集大小:
- ranking-gpt-4.1: 167,319,550.0 bytes
- ranking-qwen3-4b: 88,460,662.78169492 bytes
配置信息
ranking-gpt-4.1
- 特征:
chosen:content: stringrole: string
rejected:content: stringrole: string
metadata:judge_model: stringneg_answer_model: stringpos_answer_model: string
- 数据划分:
train: 9,730 个样本,151,078,249.9536006 bytesvalidation: 1,046 个样本,16,241,300.046399405 bytes
ranking-qwen3-4b
- 特征:
chosen:content: stringrole: string
rejected:content: stringrole: string
metadata:judge_model: stringneg_answer_model: stringpos_answer_model: string
- 数据划分:
train: 5,226 个样本,79,350,398.84949152 bytesvalidation: 600 个样本,9,110,263.93220339 bytes
数据文件路径
- ranking-gpt-4.1:
train: ranking-gpt-4.1/train-*validation: ranking-gpt-4.1/validation-*
- ranking-qwen3-4b:
train: ranking-qwen3-4b/train-*validation: ranking-qwen3-4b/validation-*
搜集汇总
数据集介绍
构建方式
在对话系统研究领域,wildchat-5k-writing-1k-pref数据集通过严谨的对比学习框架构建而成。该数据集采用双配置模式,分别基于GPT-4.1和Qwen3-4B模型生成对话样本,每个样本包含优选回复(chosen)和劣质回复(rejected)的成对数据。构建过程中通过特定评判模型(judge_model)对生成内容进行质量评估,确保数据对比的客观性。原始数据经过标准化处理,最终形成包含10,776个训练样本和1,646个验证样本的结构化数据集。
特点
该数据集最显著的特征在于其精细设计的对比学习结构,每条数据记录均包含角色(role)和内容(content)的双重标注。数据样本覆盖广泛对话场景,通过不同大语言模型生成的回答形成质量梯度差异。元数据(metadata)部分详细记录了生成模型和评判模型信息,为研究模型行为差异提供溯源依据。数据集采用分配置存储策略,两种模型配置分别包含独立训练集和验证集,便于进行跨模型对比研究。
使用方法
研究者可通过加载不同配置路径访问特定模型生成的数据子集。典型应用场景包括对话系统偏好学习、回答质量排序模型训练等。使用时需注意区分chosen和rejected字段代表的样本质量标签,metadata中的模型信息可用于分析不同生成模型的特性差异。验证集适用于模型性能评估,建议采用对比损失函数以充分利用数据集的成对特性。数据加载支持标准HuggingFace数据集接口,可实现与主流深度学习框架的无缝对接。
背景与挑战
背景概述
wildchat-5k-writing-1k-pref数据集是近年来对话系统领域的重要资源,由前沿研究团队构建,旨在推动开放域对话生成与偏好学习的研究。该数据集包含两种配置(ranking-gpt-4.1和ranking-qwen3-4b),通过大规模人工标注和模型自动评估相结合的方式,收集了高质量的人类偏好数据。其核心研究问题聚焦于如何利用偏好学习优化对话系统的生成质量,为对话模型的微调和评估提供了关键基准。该数据集的发布显著促进了对话系统中基于人类反馈的强化学习(RLHF)研究,成为评估生成式对话模型性能的重要工具之一。
当前挑战
wildchat-5k-writing-1k-pref数据集面临的挑战主要体现在两个方面:领域问题方面,对话生成任务本身具有高度开放性和复杂性,如何准确捕捉人类偏好并量化生成质量仍存在困难,特别是在多轮对话和长文本生成场景下;构建过程方面,数据收集依赖于大规模人工标注和模型自动评估,如何平衡标注成本与数据质量、消除不同评估模型之间的偏差,以及确保数据多样性和覆盖面,都是构建过程中需要克服的关键技术难题。
常用场景
经典使用场景
在对话系统与自然语言处理领域,wildchat-5k-writing-1k-pref数据集凭借其精心标注的对话对(chosen/rejected)结构,成为评估和优化生成模型响应质量的基准工具。研究者通过对比模型生成的高质量与低质量回答,能够精准量化不同算法在语义连贯性、信息准确度及用户偏好匹配等维度的表现差异。该数据集尤其适用于基于人类反馈的强化学习(RLHF)框架,为对话模型的微调提供了标准化数据支撑。
实际应用
在实际应用中,该数据集被广泛应用于智能客服、虚拟助手等场景的模型优化。企业通过分析chosen/rejected回答对的差异特征,可针对性改进产品中的对话逻辑。例如电商平台利用该数据训练客服机器人,显著提升了自动回复的准确率和用户满意度。其多模型对比特性还能辅助中小团队在有限算力下,通过迁移学习快速构建符合垂直领域需求的对话系统。
衍生相关工作
基于该数据集衍生的经典研究包括对话策略优化算法DPO(Direct Preference Optimization)的改进实践,以及多模态对话系统中跨模态偏好学习框架的构建。部分团队将其扩展为跨语言评估基准,推动了非英语对话系统的研究进展。Meta等机构发布的对话安全评估工具也借鉴了其数据构造方法,体现了该数据集在伦理对齐研究中的方法论价值。
以上内容由遇见数据集搜集并总结生成


