
SeacowX/OpenToM
收藏官方服务:
资源简介:
OpenToM是一个用于评估大语言模型(LLMs)神经心智理论(N-ToM)能力的新基准,包含696个叙事故事和16008个问题。数据集的问题设计为二元或三元分类任务,建议使用宏平均F1分数来评估LLMs的性能。数据集的结构包括两个主要文件:`opentom.json`和`opentom_long.json`,分别包含正常长度和长叙事的问答数据。数据集的生成过程涉及LLMs生成故事,部分故事经过人工修订。数据集的使用仅限于基准测试,不应用于训练或微调。
OpenToM是一个用于评估大语言模型(LLMs)神经心智理论(N-ToM)能力的新基准,包含696个叙事故事和16008个问题。数据集的问题设计为二元或三元分类任务,建议使用宏平均F1分数来评估LLMs的性能。数据集的结构包括两个主要文件:`opentom.json`和`opentom_long.json`,分别包含正常长度和长叙事的问答数据。数据集的生成过程涉及LLMs生成故事,部分故事经过人工修订。数据集的使用仅限于基准测试,不应用于训练或微调。
提供机构:
SeacowX原始信息汇总
数据集概述
基本信息
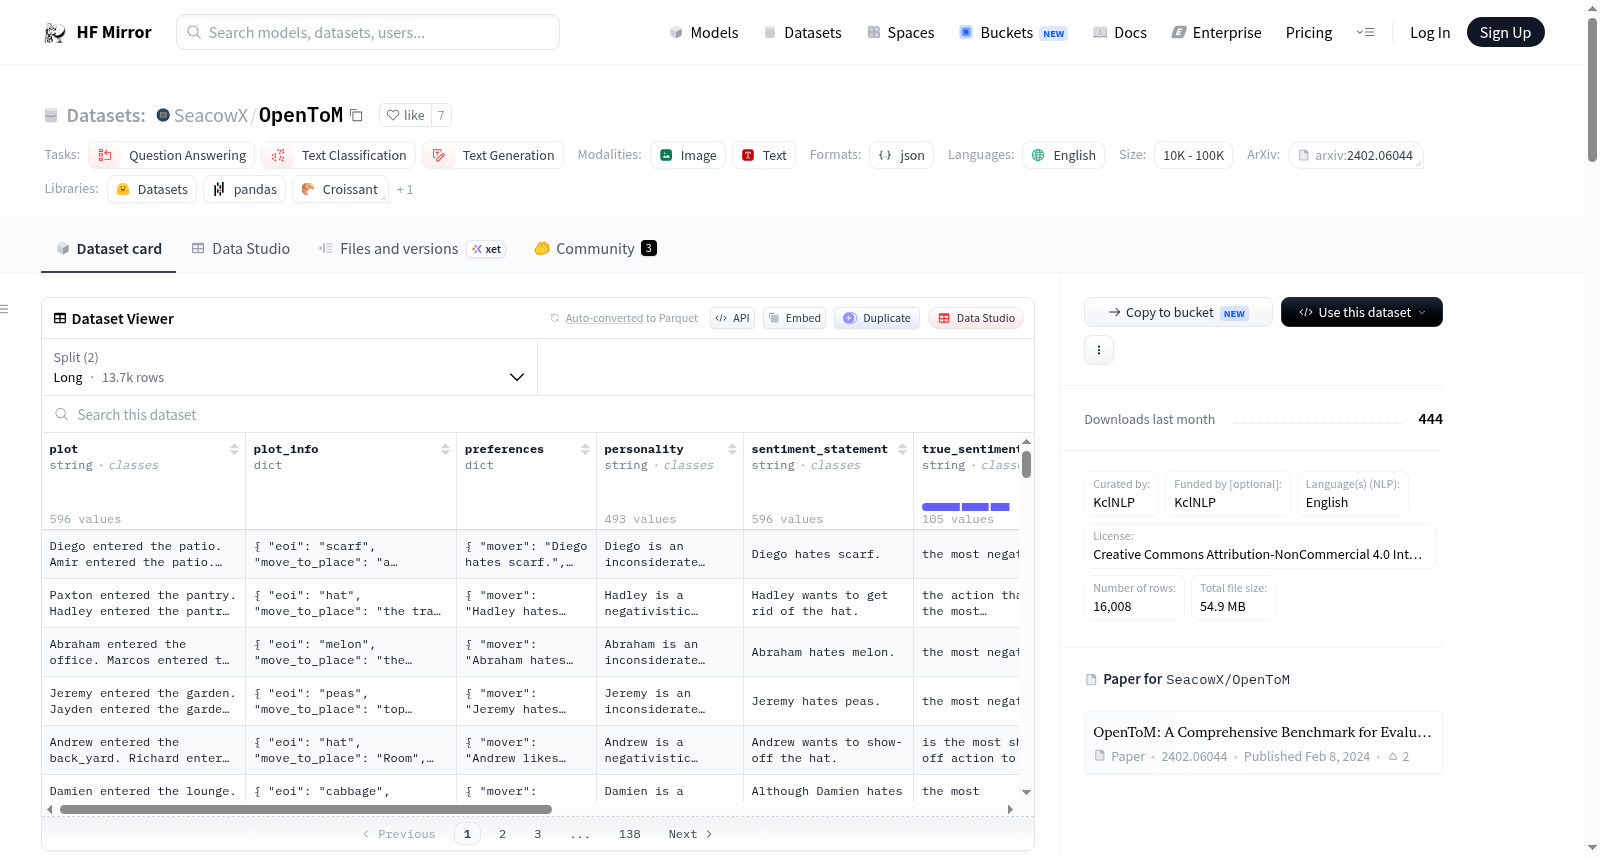
- 任务类别: 问答、文本分类、文本生成
- 语言: 英语
- 名称: OpenToM
- 数据量: 10K<n<100K
- 配置:
- 默认配置:
- 文件:
opentom.json(Long 分割)opentom_long.json(ExtraLong 分割)
- 文件:
- 默认配置:
数据集详情
- 包含: 696个叙事,其中596个为正常长度(平均词数:194.3),100个为长叙事(平均词数:491.6)
- 问题数量: 每个叙事跟随23个ToM问题,总计16008个问题
- 问题类型:
- Location: 分为粗粒度和细粒度,询问实体位置
- Multihop: 基于Location问题的多跳推理,涉及社会常识
- Attitude: 测试对角色心理状态的理解
数据集描述
- 策划: KclNLP
- 语言: 英语
- 许可证: Creative Commons Attribution-NonCommercial 4.0 International Public License
数据集结构
- 文件:
opentom.json: 包含596个正常长度叙事的13,708个问题opentom_long.json: 包含100个长叙事的2,300个问题
- 问题类型文件:
location_cg_fo: 粗粒度位置问题(一阶)location_cg_so: 粗粒度位置问题(二阶)location_fg_fo: 细粒度位置问题(一阶)location_fg_so: 细粒度位置问题(二阶)multihop_fo: 多跳推理问题(一阶)multihop_so: 多跳推理问题(二阶)attitude: 态度问题
数据集创建
- 故事生成: 部分内容源自ToMi数据集
引用
-
BibTeX:
@article{xu2024opentom, title={OpenToM: A Comprehensive Benchmark for Evaluating Theory-of-Mind Reasoning Capabilities of Large Language Models}, author={Xu, Hainiu and Zhao, Runcong and Zhu, Lixing and Du, Jinhua and He, Yulan}, journal={arXiv preprint arXiv:2402.06044}, year={2024} }
搜集汇总
数据集介绍
背景与挑战
背景概述
OpenToM是一个用于评估大型语言模型心智理论推理能力的基准数据集,包含696个叙事故事和16008个问题,涵盖位置、多跳推理和态度等多种问题类型。该数据集强调不应用于模型训练,以避免数据泄露,并采用JSON格式存储,支持对模型心理状态理解能力的细粒度测试。
以上内容由遇见数据集搜集并总结生成


