遇见数据集

adalib/litex-data

收藏
Hugging Face2024-01-29 更新2024-03-04 收录
官方服务:

资源简介:

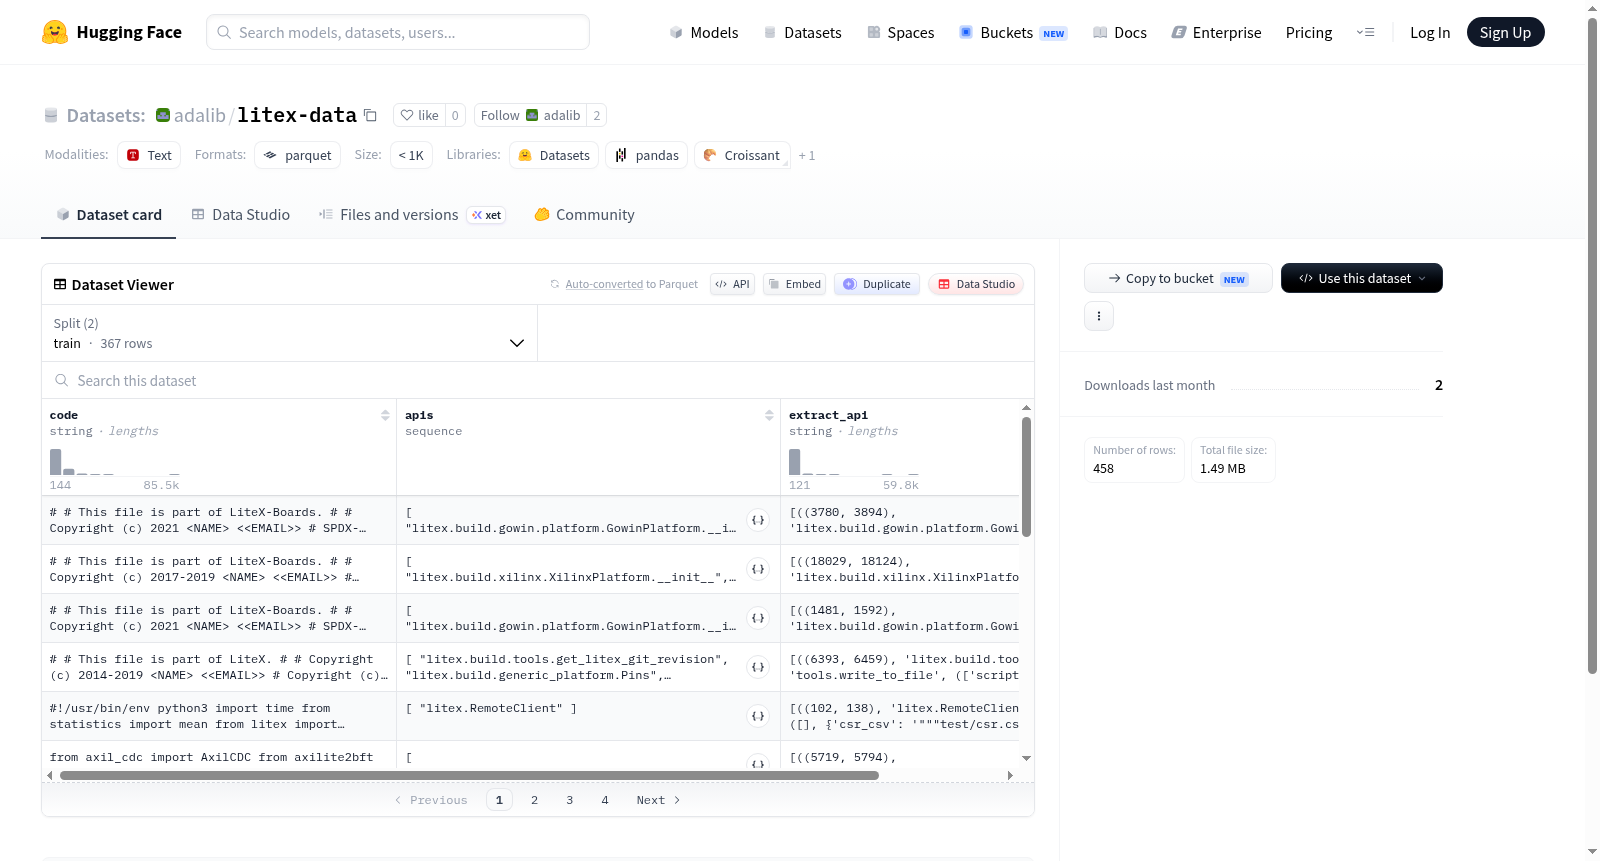
--- dataset_info: features: - name: code dtype: string - name: apis sequence: string - name: extract_api dtype: string splits: - name: train num_bytes: 3386835 num_examples: 367 - name: test num_bytes: 916271 num_examples: 91 download_size: 1488117 dataset_size: 4303106 configs: - config_name: default data_files: - split: train path: data/train-* - split: test path: data/test-* ---

数据集信息(dataset_info): 特征字段(features): - 字段名称:代码(code),数据类型:字符串(string) - 字段名称:API序列(apis),数据类型:字符串序列(sequence of string) - 字段名称:提取API(extract_api),数据类型:字符串(string) 数据集划分(splits): - 划分名称:训练集(train),字节大小:3386835,样本数量:367 - 划分名称:测试集(test),字节大小:916271,样本数量:91 下载大小:1488117,数据集总大小:4303106 配置项(configs): - 配置名称:默认配置(default),数据文件配置: - 数据集划分:训练集(train),数据路径:data/train-* - 数据集划分:测试集(test),数据路径:data/test-*

提供机构:
adalib
原始信息汇总

数据集概述

数据集特征

  • 名称: code
    • 数据类型: string
  • 名称: apis
    • 序列类型: string
  • 名称: extract_api
    • 数据类型: string

数据集分割

  • 训练集
    • 字节数: 3386835
    • 样本数: 367
  • 测试集
    • 字节数: 916271
    • 样本数: 91

数据集大小

  • 下载大小: 1488117 字节
  • 数据集大小: 4303106 字节

配置信息

  • 配置名称: default
    • 数据文件
      • 训练集路径: data/train-*
      • 测试集路径: data/test-*
搜集汇总
数据集介绍
adalib/litex-data 数据集图片
构建方式
在嵌入式系统与硬件描述语言的研究领域中,高质量的数据集对于推动代码生成与接口理解任务至关重要。adalib/litex-data数据集基于LiteX硬件设计框架构建,专注于收集与处理硬件描述代码及其对应的应用程序接口(API)信息。该数据集从实际项目中提取代码片段,并标注了相关API序列,形成一个结构化的三元组:原始代码、API序列集合及抽取出的单一API。数据被划分为训练集与测试集,其中训练集包含367个样本,测试集包含91个样本,确保了模型评估的可靠性。
特点
该数据集具有显著的领域专一性与结构清晰性。其核心特点在于每一条数据均包含三个字段:code字段存储原始的硬件描述代码,apis字段以序列形式记录代码中调用的多个API,extract_api字段则精准抽取其中一个关键API,便于进行细粒度的API识别与分析。数据总量约为4.3MB,样本规模适中,适合用于小样本学习与迁移学习场景。这种设计不仅支持代码-API映射关系的建模,还可用于API推荐与代码理解等下游任务。
使用方法
使用adalib/litex-data数据集时,可通过HuggingFace Datasets库直接加载,指定配置名为default即可自动获取训练与测试分片。加载后,每条数据以字典形式呈现,包含code、apis和extract_api三个键值对。研究人员可将code字段作为输入序列,apis作为多标签目标,或利用extract_api进行单API预测任务。该数据集适用于序列标注、文本分类及生成式模型的微调,尤其适合探索硬件描述语言中的API调用模式。
背景与挑战
背景概述
在自然语言处理与代码理解的交叉领域,如何精准捕捉编程语言中的应用程序接口(API)调用模式,已成为提升代码自动补全、智能检索及软件工程效率的核心课题。adalib/litex-data数据集应运而生,其构建时间虽未明确标注,但反映了近年来学术界与工业界对轻量化、领域特化数据资源的迫切需求。该数据集由adalib团队维护,聚焦于从代码片段中提取API序列,旨在为序列预测与代码理解模型提供高质量的训练与评估基准。其核心研究问题在于,如何通过有限的、精炼的代码示例,迫使模型学习到API调用的内在逻辑与上下文依赖性。尽管数据集规模较小(训练集367例,测试集91例),但其对后续轻量级模型在资源受限场景下的部署具有潜在影响力,尤其适用于嵌入式系统或实时代码辅助工具的研究。
当前挑战
该数据集所面临的挑战首先体现在领域问题的复杂性上:代码中的API调用并非孤立存在,而是受编程范式、库版本及开发者习惯等多重因素影响,模型需具备捕捉长距离依赖与语义歧义的能力,这对样本量有限的数据集构成严峻考验。其次,在构建过程中,从原始代码中自动提取API序列的准确性难以保障,注释、字符串字面量及非标准库引用可能引入噪声,导致标注质量参差不齐。此外,数据集的规模限制(总样本仅458例)使其难以覆盖多样化的API使用场景,易导致模型过拟合于特定模式,泛化至真实世界复杂代码库时性能显著下降。最后,缺乏跨语言或多框架的扩展性设计,进一步制约了其在异构开发环境中的适用性。
常用场景
经典使用场景
在硬件描述语言与电子设计自动化领域,adalib/litex-data数据集为研究人员提供了宝贵的资源,其核心应用场景在于训练和评估基于深度学习的代码到应用程序编程接口(API)映射模型。该数据集包含367条训练样本和91条测试样本,每条样本由原始硬件代码、对应的API序列以及提取出的单一API调用组成,这使其成为构建从硬件描述到软件API调用转换系统的理想基准。研究者可以借此探索序列到序列的生成任务,例如将LiteX框架下的硬件描述代码自动翻译为相应的API调用序列,从而推动硬件设计自动化的前沿发展。
实际应用
在实际应用中,adalib/litex-data数据集驱动的模型可部署于电子设计自动化工具链中,实现硬件代码的智能辅助生成。例如,工程师在编写基于LiteX的片上系统设计时,系统可自动推荐或生成对应的API调用,大幅缩短开发周期并降低新手入门门槛。此外,该技术还可应用于硬件代码审查与错误检测,通过自动比对预期API与实际调用来发现潜在的不匹配问题。在物联网与边缘计算设备快速迭代的背景下,此类自动化工具能有效加速定制化硬件方案的落地,推动从概念验证到产品部署的转化效率。
衍生相关工作
基于adalib/litex-data数据集,学界已衍生出多项开创性研究工作。最典型的是将Transformer或长短期记忆网络应用于代码序列建模,以捕获硬件代码中嵌套的API调用模式。同时,该数据集也催生了针对小样本学习的元学习算法探索,因为其有限的样本量恰好考验模型在稀缺数据场景下的泛化能力。此外,研究者还将其与预训练语言模型(如CodeBERT)结合,通过领域微调实现从通用代码理解到硬件专用API预测的迁移学习。这些工作不仅丰富了代码智能的研究范式,也为硬件-软件协同设计提供了新的方法论支撑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务