遇见数据集

dev_set_v2_a1_synatra_20260815_025225

收藏
Hugging Face2026-08-16 更新2026-08-17 收录
官方服务:

资源简介:

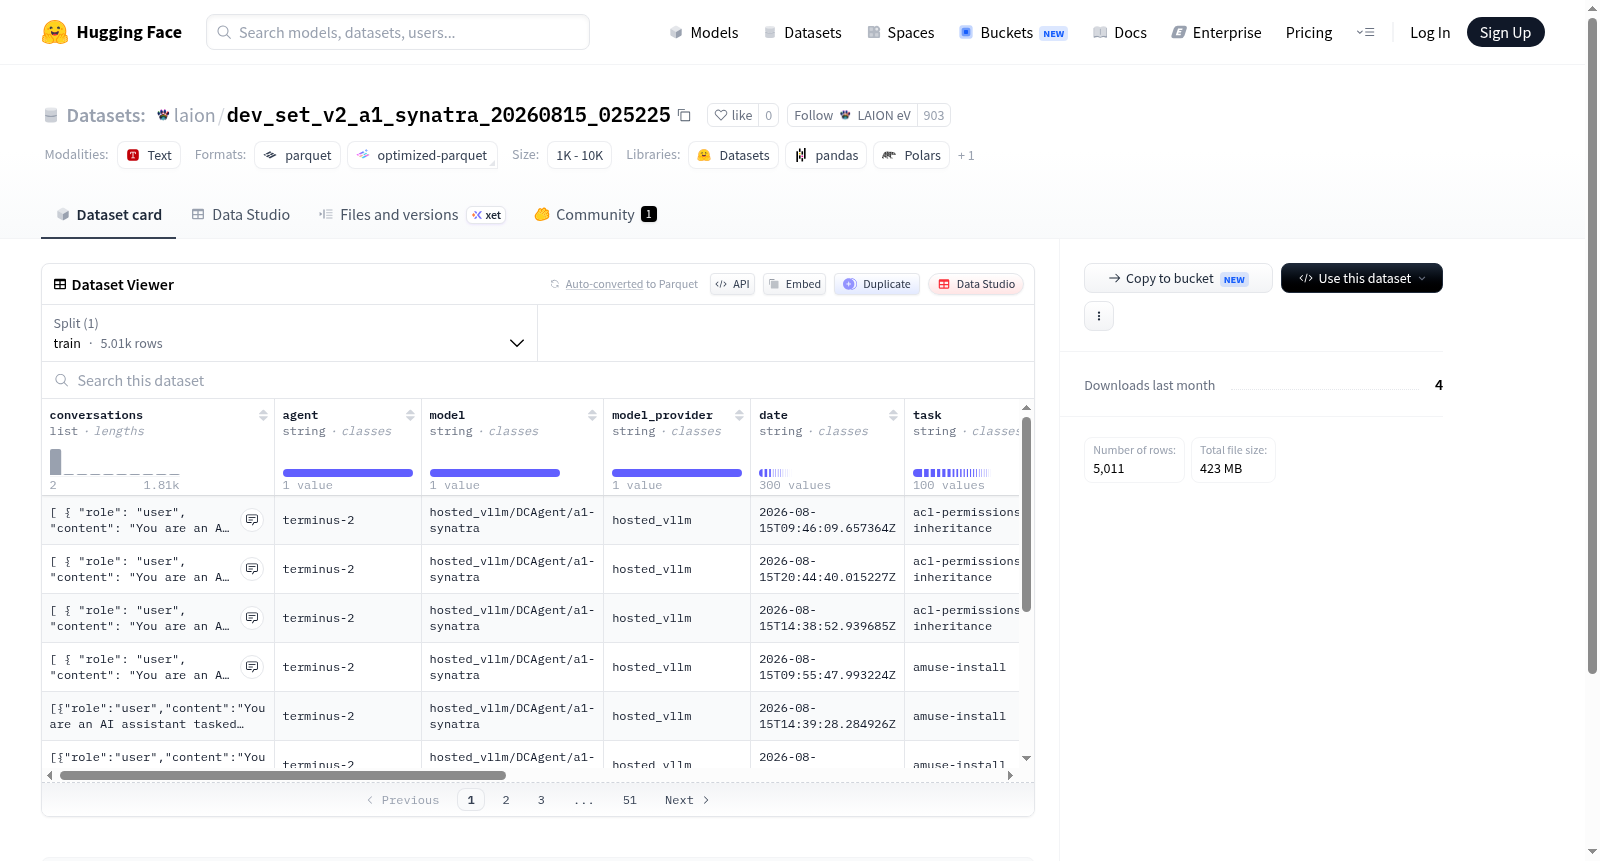
该数据集包含多轮对话记录,每条对话由角色和内容组成。此外,每条记录还关联了智能体名称、模型名称、模型提供商、日期、任务描述、对话轮次、运行ID、实验名称、结果、验证器输出以及追踪来源。数据集共有5011条训练样本,总大小约488MB。该数据集适用于智能体对话系统、任务型对话、模型评估或结果分析等场景。

The dataset contains multi-turn conversation records, each conversation consists of role and content. Additionally, each record is associated with agent name, model name, model provider, date, task description, conversation turns, run ID, experiment name, result, validator output, and trace source. The dataset has a total of 5011 training samples, with a total size of about 488MB. It is suitable for scenarios such as agent dialogue systems, task-oriented dialogues, model evaluation, or result analysis.

提供机构:
LAION eV
创建时间:
2026-08-16
原始信息汇总

数据集详情总结

基本信息

  • 数据集名称laion/dev_set_v2_a1_synatra_20260815_025225
  • 数据集来源:Hugging Face
  • 下载大小:约 422.69 MB
  • 数据集总大小:约 488.26 MB
  • 数据分割:仅包含 train 分割,共 5,011 条数据样本

数据字段说明

该数据集包含以下 12 个字段:

字段名 类型 描述
conversations 列表(含 rolecontent 两个子字段) 对话记录,包含角色(如用户/助手)和内容
agent 字符串 使用的智能体名称或标识
model 字符串 使用的模型名称
model_provider 字符串 模型提供方
date 字符串 数据生成日期
task 字符串 任务类型或名称
episode 字符串 会话/回合编号
run_id 字符串 运行标识
trial_name 字符串 试验名称
result 字符串 任务结果
verifier_output 字符串 验证器输出
trace_source 字符串 数据来源追踪信息

数据用途

该数据集由 LAION 组织提供,版本标识为 dev_set_v2_a1_synatra,属于开发集(dev set),主要用于模型训练或评估场景,尤其适用于多轮对话、智能体交互或任务结果验证相关的机器学习任务。数据集包含完整的对话轨迹、模型信息、任务执行结果及验证信息,适合用于训练或评估具有任务型对话能力的AI系统。

数据文件

  • 配置名称default
  • 文件路径data/train-*(通配符表示多个分片文件)
搜集汇总
数据集介绍
dev_set_v2_a1_synatra_20260815_025225 数据集图片
构建方式
该数据集源自对智能体交互过程的系统化采集与整理,其构建遵循严格的流程规范。数据以对话序列为核心,每条记录包含多轮角色与内容的交替,并辅以agent、model、model_provider等元数据标识,确保来源可溯。此外,数据集详尽记录了任务类型、实验批次、运行标识及验证器输出等关键参数,为后续分析与评估提供了完备的上下文信息。整体架构彰显了科学性与严谨性,旨在支撑复杂场景下的智能体行为研究。
特点
此数据集的核心特色在于其丰富的结构化信息与高度的可追溯性。每条样本不仅囊括了完整的多轮对话,还精准关联了生成模型、任务属性及运行细节,使得研究能够深入剖析智能体的决策逻辑。尤为突出的是,数据集中包含了任务执行结果与验证器反馈,使得其不仅适用于训练,更可服务于模型的性能评估与策略优化,在不同领域均展现出卓越的适用性与研究价值。
使用方法
该数据集的使用方法灵活多样,研究可将其直接用于智能体对话模型的监督微调,借助其清晰的对话结构提升模型在多轮交互中的表现。其元数据字段支持细粒度的数据筛选,便于构建特定任务的子集进行针对性训练。此外,验证器输出与结果字段可用于评估模型生成内容的质量,驱动强化学习或偏好对齐等进阶应用,同时便于复现实验,确保研究的可重复性。
背景与挑战
背景概述
随着大语言模型(LLM)在复杂推理任务中的广泛应用,如何构建高质量、多轮交互的评估数据集成为研究热点。该数据集(dev_set_v2_a1_synatra_20260815_025225)由Synatra团队于2026年8月创建,旨在模拟真实世界中的多轮对话场景,用于评估和微调LLM的推理能力、指令遵循及交互稳定性。数据集包含5011条训练样本,每条样本记录了完整的会话历史、代理信息、模型输出及验证器结果,为研究者提供了丰富的元数据以分析模型行为。其发布填补了现有数据集在动态交互和细粒度结果验证方面的空白,对促进LLM的鲁棒性评估和迭代优化具有重要意义,尤其在智能体系统开发领域展现出潜在影响力。
当前挑战
该数据集面临的挑战主要体现在两方面。领域问题层面,现有评估基准多侧重于单轮问答,难以捕捉多轮交互中的上下文依赖、错误累积和策略调整,削弱了对模型实际应用能力的刻画,本数据集虽聚焦于此,但多轮推理的评价指标设计仍是一个开放性难题。构建过程中,数据集需确保对话场景的多样性和真实性,同时避免数据泄露和偏见引入;高保真录音的采集与标注成本高昂,且需协调多代理交互的时序一致性,验证器输出的自动化评估也可能引入噪声,这些因素对数据集的规模扩展和持续更新构成制约。
常用场景
经典使用场景
该数据集作为大规模多轮对话语料库,在对话系统与自然语言处理领域具有广泛的应用前景。其核心结构由角色与内容组成的对话对构成,辅以智能体标识、模型来源及任务类型等元数据,为研究者提供了丰富的实验素材。经典的使用场景包括训练和评估基于Transformer架构的对话生成模型,如GPT系列或LLaMA衍生模型,用于优化上下文理解、响应连贯性及角色一致性。此外,数据集的多任务标注特性使其适用于多任务学习框架,以提升模型在指令跟随、知识问答和任务导向型对话中的泛化能力。
解决学术问题
该数据集针对现有对话数据集规模有限、场景单一及标注不一致等痛点,提供了包含5011个样本的大规模多轮交互记录,有效缓解了数据稀缺问题。它支持研究者在模型泛化性、鲁棒性和少样本学习等方向上开展深入探索,特别是通过对比不同模型生成结果与验证器输出,能够系统评估对话系统的性能边界。其精细的任务与片段划分,促进了对对话策略和错误传播机制的量化分析,从而推动对话理解与生成领域的理论进展。
衍生相关工作
该数据集的发布促进了多项衍生研究,包括对话预训练模型的微调基准构建、上下文压缩与检索增强生成技术的评估,以及基于强化学习的对话策略优化。其丰富的元数据也催生了关于数据去偏和隐私保护的研究,以应对真实对话数据中的敏感信息。此外,数据集的轨迹来源与结果字段为可解释对话系统和错误分析提供了基础,激发了对模型自我纠正和验证机制的研究,进而推动多智能体协作框架的建立。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务