
遇见数据集

gplsi/alia_tourism

收藏
Hugging Face2026-06-02 更新2026-02-07 收录
官方服务:

资源简介:

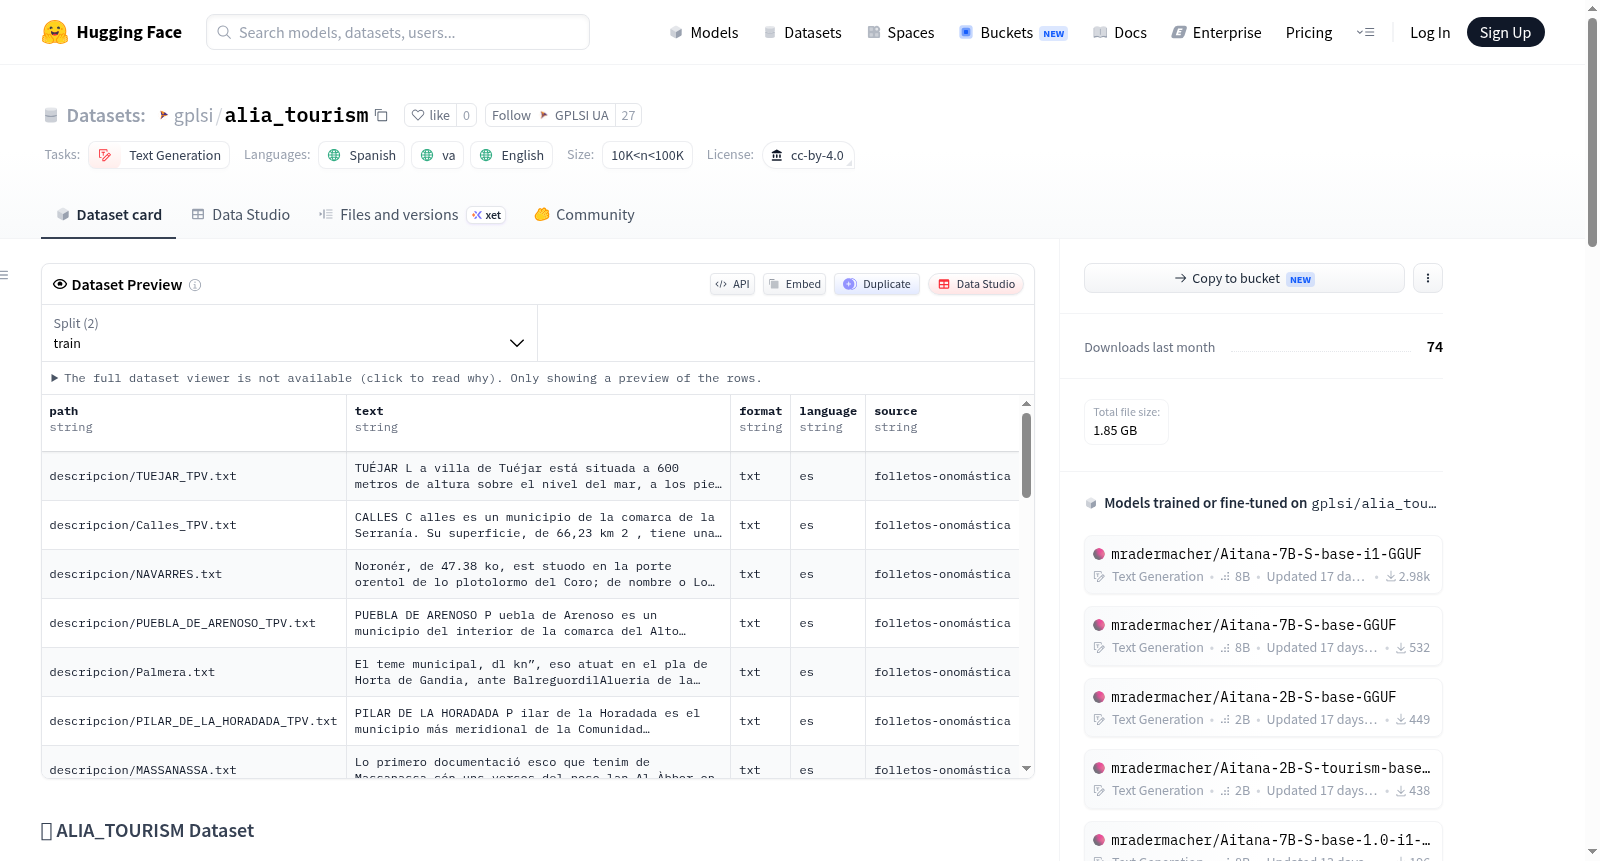
ALIA_TOURISM数据集是一个多语言资源,专为旅游领域的文本生成而设计。数据集包含以Markdown格式(`.md`)提供的文本文档,每个文档以结构化的JSONL条目形式呈现。每个条目包括文本的源、语言、格式、文本内容和元数据等信息。数据集涵盖西班牙语(es)、瓦伦西亚语(va)和英语(en)三种语言,领域为旅游,格式为JSON Lines(`.jsonl`)。每个条目代表一个独立的旅游相关文本。数据集由旅游资源自动整理而成,元数据覆盖范围可能因条目而异,内容可能包含用于结构的Markdown格式(如标题、列表、强调等)。

The **ALIA_TOURISM** dataset is a multilingual resource designed for **text generation** within the **tourism domain**. The dataset consists of textual documents formatted in **Markdown (`.md`)**, each provided as structured JSONL entries. Each entry includes information about the texts **source**, **language**, **format**, **text**, and **metadata**. The dataset covers Spanish (es), Valencian (va), and English (en) languages, with the domain being tourism, and the format being JSON Lines (`.jsonl`). Each item represents a standalone tourism-related text. The dataset is automatically curated from tourism sources, and metadata coverage may vary by entry. Content may include Markdown formatting for structure (e.g., headers, lists, emphasis).
提供机构:
gplsi
搜集汇总
数据集介绍
gplsi/alia_tourism 数据集图片
构建方式
ALIA_TOURISM数据集是一个面向旅游领域的多语种文本生成资源,由ALIA项目精心构建。该数据集以JSON Lines格式存储,每一条目均包含格式(format)、来源(source)、语言(language)、文本(text)及元数据(metadata)等字段,文本内容统一采用Markdown标记语言呈现。其训练集部分严格筛选自具有LLM许可协议或获得明确捐赠授权的来源,而测试集则不受此限制,从而在保证合规性的同时扩展了数据覆盖面。
特点
该数据集的核心特色在于其多语种覆盖与领域专精性,囊括西班牙语(es)、瓦伦西亚语(va)和英语(en)三种语言,全部聚焦于旅游相关文本。条目规模介于10K至100K之间,适合中等规模模型训练与微调。数据集自动从旅游来源收集,尽管元数据覆盖率因条目而异,但内容保留了Markdown的结构化特征(如标题、列表、强调),便于下游处理。此外,其开源许可(CC BY 4.0)与严格的版权甄别机制,凸显了对知识产权的高度尊重。
使用方法
用户可通过HuggingFace平台直接加载该数据集,利用其JSON Lines格式便捷地解析每条文本。在模型训练或微调时,建议将文本字段作为输入,结合来源与语言字段进行多语种或领域自适应学习。需特别注意,基于该数据集衍生的语料库或训练模型在公开文档中必须明确致谢数据提供方UNDEF与Federación de Moros y Cristianos de San Blas。此外,由于数据可能包含偏差,用户应自行评估并规避潜在风险,确保符合AI使用规范。
背景与挑战
背景概述
ALIA_TOURISM数据集由西班牙阿利坎特大学语言与信息系统研究组(GPLSI)与数字智能中心(CENID)于2025年创建,核心研究问题聚焦于多语言、多源旅游领域文本的自动生成。该数据集整合了西班牙语、巴伦西亚语和英语三种语言的旅游文档,以Markdown格式存储,来源于具有LLM许可或明确捐赠协议的旅游机构,旨在为低资源语言(如巴伦西亚语)的自然语言生成任务提供高质量训练语料。其发布受到西班牙数字化转型与公共职能部及欧盟NextGenerationEU项目的资助,对促进多语言旅游智能系统的发展具有重要影响力。
当前挑战
该数据集所解决的领域问题在于,旅游领域文本生成面临语言多样性、数据来源合规性及内容结构复杂性等挑战。具体而言,巴伦西亚语作为区域语言语料稀缺,需依赖严格授权的多源数据整合,同时需确保Markdown格式的结构化信息(如标题、列表)在生成任务中的语义保真度。构建过程中,团队需自动筛选来自不同机构(如UNEF、圣布拉斯摩尔与基督教徒联合会)的文档,处理元数据覆盖不完整、内容潜在偏见以及跨语言一致性等难题,并需遵守CC BY 4.0许可下的衍生作品署名要求。
常用场景
经典使用场景
在旅游领域,多语言文本生成是提升跨文化信息传播效率的关键。ALIA_TOURISM数据集汇聚了来自西班牙语、瓦伦西亚语和英语的旅游文本,为研究者提供了丰富的语料资源。其最经典的使用场景是训练和微调面向旅游领域的多语言文本生成模型,例如自动生成旅游景点介绍、酒店描述或旅行指南。数据以Markdown格式结构化呈现,便于模型学习标题、列表等排版元素,从而生成格式规范、内容翔实的旅游文案。
实际应用
在实际应用中,ALIA_TOURISM数据集成为智慧旅游系统开发的基石。基于该数据集训练的模型可部署于旅游官方网站、移动导游应用或多语言客服机器人,自动生成景点解说、行程推荐及多语种回复。例如,面向地中海沿岸的旅游目的地,模型能够输出带有当地历史背景的瓦伦西亚语介绍文本,提升国际游客的体验。此外,数据集中明确的来源授权信息保障了商业使用的合规性,企业和机构可借此快速构建个性化旅游内容生成服务,降低人工编写成本。
衍生相关工作
围绕ALIA_TOURISM数据集,衍生了一系列创新研究工作。其中,基于该数据集的跨语言旅游文本摘要模型被提出,能够从多语长文档中提取关键信息并生成简洁的摘要;此外,研究者利用其多语言特性开发了旅游领域的零样本翻译增强生成系统,实现了在未见过的语言对上的高效文本生成。值得注意的是,该数据集的合规性与来源追溯机制激发了关于数据版权与生成模型伦理的讨论,衍生出结合知识图谱的旅游领域可控文本生成方法,在确保信息准确性的同时,兼顾了对数据提供方(如UNDEF)的致谢与署名要求。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

