
遇见数据集

biohub/ESMC-SAE-Features

收藏
Hugging Face2026-05-29 更新2026-06-14 收录
官方服务:

资源简介:

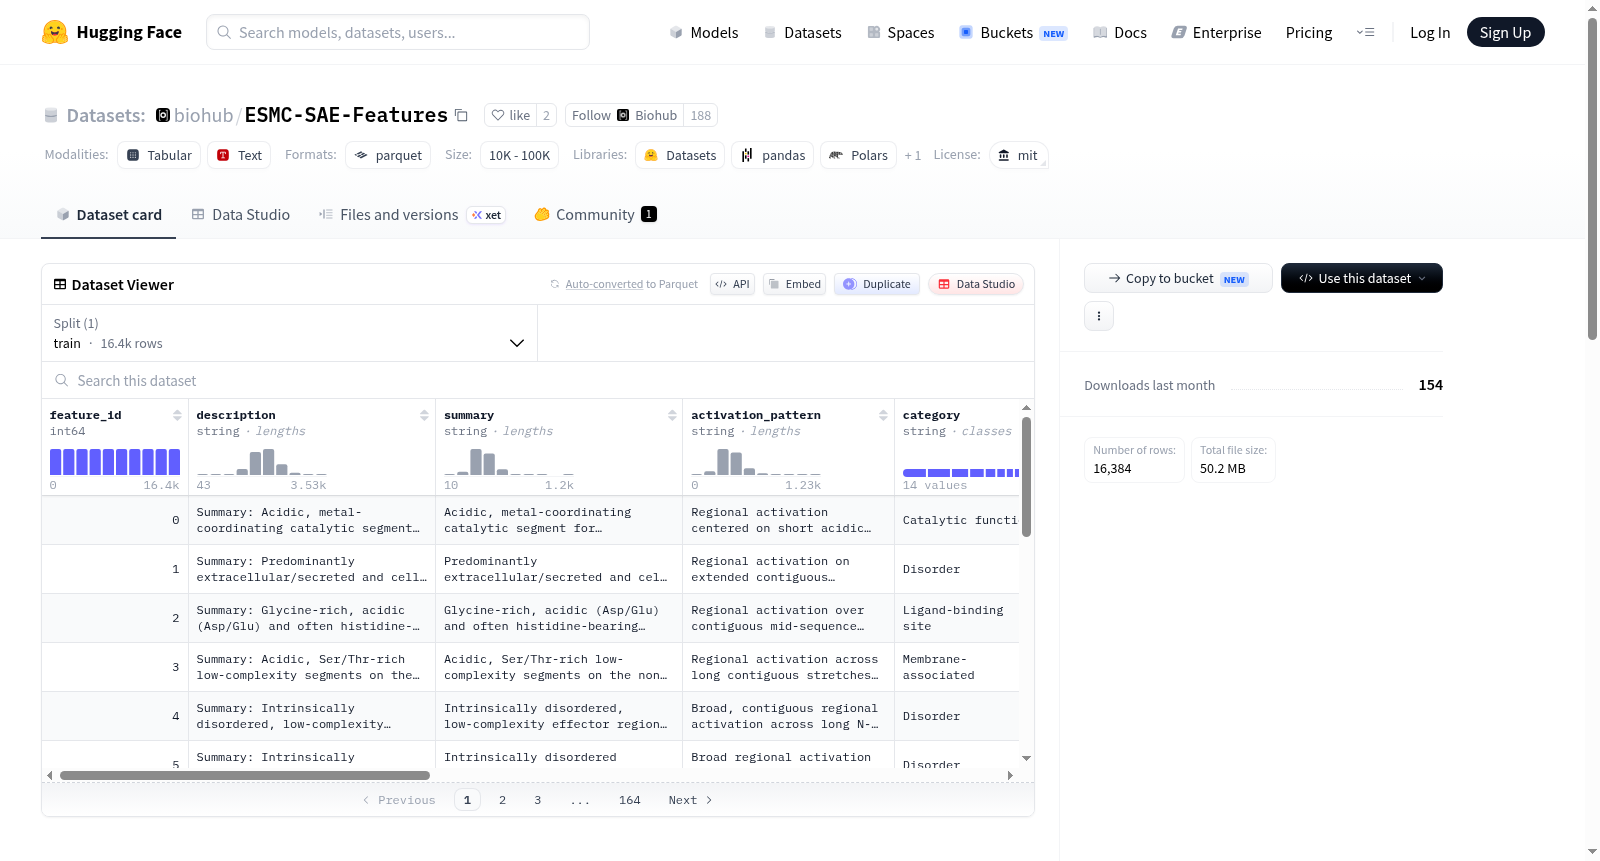
该数据集包含一个Parquet表格,其中包含来自ESMC-6B-sae-layer60-k64-codebook16384的16,384个特征,这些特征用于ESMC论文分析和构建ESM Atlas。该表格提供了预计算特征的描述,帮助用户对ESMC揭示的见解进行下游解释。表格内容包括特征索引、生物概念描述摘要、激活模式、示例蛋白质家族、激活阈值、类别分类、在Uniref90中的频率和IDF值、最大激活值、前100个Uniref ID、前100个Swissprot激活以及解码器最近邻特征等列。

This dataset contains a Parquet table with 16,384 features sourced from ESMC-6B-sae-layer60-k64-codebook16384, which are utilized for the analysis in the ESMC paper and the construction of ESM Atlas. This table provides descriptions of pre-computed features to enable downstream interpretation of the insights revealed by ESMC. The table includes columns such as feature index, summary of biological concept descriptions, activation patterns, exemplary protein families, activation thresholds, category classification, frequency and IDF values in Uniref90, maximum activation values, top 100 Uniref IDs, top 100 Swissprot activations, and decoder nearest neighbor features.
提供机构:
biohub
搜集汇总
数据集介绍
biohub/ESMC-SAE-Features 数据集图片
构建方式
ESMC-SAE-Features数据集源自ESMC-6B-sae-layer60-k64-codebook16384稀疏自编码器模型,旨在剖析蛋白质语言模型ESMC的内部表征机制。数据集通过提取模型中第60层稀疏自编码器的16,384个潜在特征,并基于这些特征在Swissprot蛋白质数据库中的激活模式,利用多智能体系统自动生成每条特征的生物学语义描述。构建过程融合了深度学习的特征解耦与自动化注释技术,将高维潜空间中的抽象概念转化为人类可读的生物学知识,为探索蛋白质序列与功能之间的隐式关联提供了结构化分析基础。
特点
该数据集的核心特性在于其对蛋白质模型潜在特征的全面注释与多维度量化。每条特征均包含人工可理解的摘要描述、残基级别的激活模式定位(如全局扩散或局部聚集)、所属蛋白质家族类别以及自动归类的12种功能类型(如催化功能、组成偏好、结构基序等)。同时提供了UniRef90数据库中2.08亿条序列上的激活频率、逆文档频率及最大激活值等统计指标,并收录了每个特征激活最强的100条UniRef90序列和100条Swissprot高注释蛋白,以及解码器潜空间中语义最邻近的10个特征索引,支持后续的跨特征关联分析。
使用方法
用户可直接从指定链接下载Parquet格式的表格文件,通过数据框操作工具(如Pandas)加载特征描述和统计字段进行下游分析。具体应用包括:结合激活阈值筛选高置信度特征以解释ESMC模型对特定蛋白质家族的识别机制;利用uniref90_idf与uniref90_max_activation对特征激活值进行归一化,实现跨蛋白的语义强度比较;通过decoder_nearest_neighbors字段探索语义相邻特征,构建特征关系图谱以揭示隐藏的蛋白质功能模块。该数据集尤其适合用于蛋白质功能预测、序列-功能映射归因分析及模型可解释性研究等场景。
背景与挑战
背景概述
在蛋白质语言模型领域,如何从深层网络表示中提取可解释的生物学概念是当前研究的关键瓶颈。ESMC-SAE-Features数据集由Evolutionary Scale Modeling(ESM)团队于2024年创建,依托ESMC-6B模型第60层的稀疏自编码器(SAE),系统性地解析了16,384个潜在特征。该数据集标志着从黑箱预测向透明生物学理解的范式转变,作为ESM Atlas交互式图谱的基石,它不仅揭示了蛋白质序列中催化功能、结构基序、组成偏好等12类生物学模式,更通过对比UniRef90与SwissProt数据库激活模式,量化了特征在208M蛋白质中的分布频率与语义正交性。这一结构化知识库首次实现了对蛋白质大模型表征的语义级解读,为功能注释、突变效应预测等下游任务提供了可溯源的解释性基础。
当前挑战
该数据集面临的核心挑战在于特征语义解析的完备性与跨域泛化性。首先,当前描述依赖多智能体系统基于SwissProt激活模式生成,但有限蛋白质空间可能导致复杂或稀有特征(如动态调控位点)表述不完整,存在信息遗漏风险。其次,特征激活阈值仅针对单一数据库校验,当应用于非冗余或低注释蛋白时,阈值泛化性有待验证;同时,解码器潜空间中最近邻特征需依赖模型语义连续性,错误关联可能误导下游分析。此外,构建过程中面临UniRef90超200M序列的激活计算存储挑战,以及人机协同标注中类别边界模糊(如“催化功能”与“结构基序”的交叉案例)导致的分类歧义。
常用场景
经典使用场景
在蛋白质功能与结构的探索中,ESMC-SAE-Features数据集为解释大型蛋白质语言模型(如ESMC-6B)的潜在语义表征提供了关键桥梁。该数据集通过稀疏自编码器(SAE)提取了16,384个可解释特征,每个特征对应一个生物学概念,如催化功能、组成偏好或结构模体。研究者利用该数据集可系统性地剖析模型在残基级别上的激活模式,将模型的黑箱推理转化为可理解的生物学语言。其经典使用场景包括:基于特征描述进行蛋白质家族的功能注释、通过阈值化激活定位关键残基,以及利用特征频率和IDF值进行跨蛋白质组的语义归一化分析。此过程使得模型学到的分子表征能够被人类直观解读,从而赋能于需要透明性和可解释性的蛋白质生物信息学研究。
实际应用
在实际应用中,ESMC-SAE-Features数据集加速了从结构生物学到药物设计的多个下游任务。工程师和生物学家可借助特征描述快速定位与新蛋白质序列相关的功能模体,例如利用‘催化功能’类特征筛选具有酶活性的候选蛋白,或通过‘结构模体’类特征辅助三维结构预测。在抗体工程中,特征层面的激活模式可用于识别抗原结合域的残基偏好,从而优化亲和力成熟策略。此外,该数据集支撑了ESM Atlas蛋白质图谱的构建,使得用户能交互式探索数千种特征在Swissprot和UniRef90中的分布,以无监督方式发现罕见功能集群。这些应用显著降低了计算生物学中‘模型-实验’转换的门槛,使非AI专家也能从大规模预训练模型中获取可操作的生物学洞见。
衍生相关工作
基于ESMC-SAE-Features数据集,研究社区已演化出多项开创性工作。最直接的衍生物是ESM Atlas蛋白质图谱,它利用这些特征构建了跨蛋白质空间的语义导航系统,使研究人员能通过特征相似性发现功能相关的蛋白质家族。另一项经典工作聚焦于利用特征频率和IDF值对蛋白质表征进行归一化,从而消除序列冗余带来的统计偏差,提升下游比对和聚类任务的鲁棒性。研究者还借鉴其多智能体描述生成框架,开发了自动化的蛋白功能注释工具,能够从模型激活中生成媲美专家的人工叙述。在方法论层面,该数据集的成功催生了将稀疏自编码器应用于其他分子模态(如RNA或代谢物)的研究趋势,推动了解释性AI在计算生物学领域的系统化发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

