
遇见数据集

income/trec-news-top-20-gen-queries

收藏
Hugging Face2023-01-24 更新2024-03-04 收录
官方服务:

资源简介:

BEIR基准数据集是一个异构基准,由18个不同的数据集组成,代表了9个信息检索任务,包括事实核查、问答、生物医学信息检索、新闻检索、论点检索、重复问题检索、引文预测、推文检索和实体检索。该数据集是单语(英语)的,采用CC-BY-SA-4.0许可证。数据集结构包括语料库、查询和相关判断文件,每个文件都有特定的格式和字段。

The BEIR benchmark dataset is a heterogeneous benchmark composed of 18 distinct datasets, representing 9 information retrieval tasks including fact checking, question answering, biomedical information retrieval, news retrieval, argument retrieval, duplicate question retrieval, citation prediction, tweet retrieval and entity retrieval. This dataset is monolingual (English) and uses the CC-BY-SA-4.0 license. Its structure includes corpus, query and relevance judgment files, each with specific formats and fields.

提供机构:
income
原始信息汇总

数据集概述

名称: BEIR Benchmark

描述: BEIR是一个异构基准,由18个不同数据集组成,涵盖9种信息检索任务。

语言: 英语 (en)

许可证: CC-BY-SA-4.0

多语言性: 单语

数据集大小:

  • msmarco: 1M<n<10M
  • trec-covid: 100k<n<1M
  • nfcorpus: 1K<n<10K
  • nq: 1M<n<10M
  • hotpotqa: 1M<n<10M
  • fiqa: 10K<n<100K
  • arguana: 1K<n<10K
  • touche-2020: 100K<n<1M
  • cqadupstack: 100K<n<1M
  • quora: 100K<n<1M
  • dbpedia: 1M<n<10M
  • scidocs: 10K<n<100K
  • fever: 1M<n<10M
  • climate-fever: 1M<n<10M
  • scifact: 1K<n<10K

数据集结构

数据格式:

  • corpus: .jsonl 文件,包含文档ID、标题和文本。
  • queries: .jsonl 文件,包含查询ID和文本。
  • qrels: .tsv 文件,包含查询ID、文档ID和相关性评分。

数据实例:

  • corpus: 文档ID、标题和文本。
  • queries: 查询ID和文本。
  • qrels: 查询ID、文档ID和相关性评分。

数据集创建

源数据:

  • 包含多个子数据集,如MSMARCO、TREC-COVID等。

许可证信息:

  • 引用信息: 使用时需引用相关论文。

使用注意事项

社会影响: 数据集用于评估信息检索模型,可能影响相关技术的发展。

偏见讨论: 数据集可能存在语言和文化偏见,使用时需注意。

其他已知限制: 数据集可能不包含所有可能的查询和文档组合,可能影响评估结果。
搜集汇总
数据集介绍
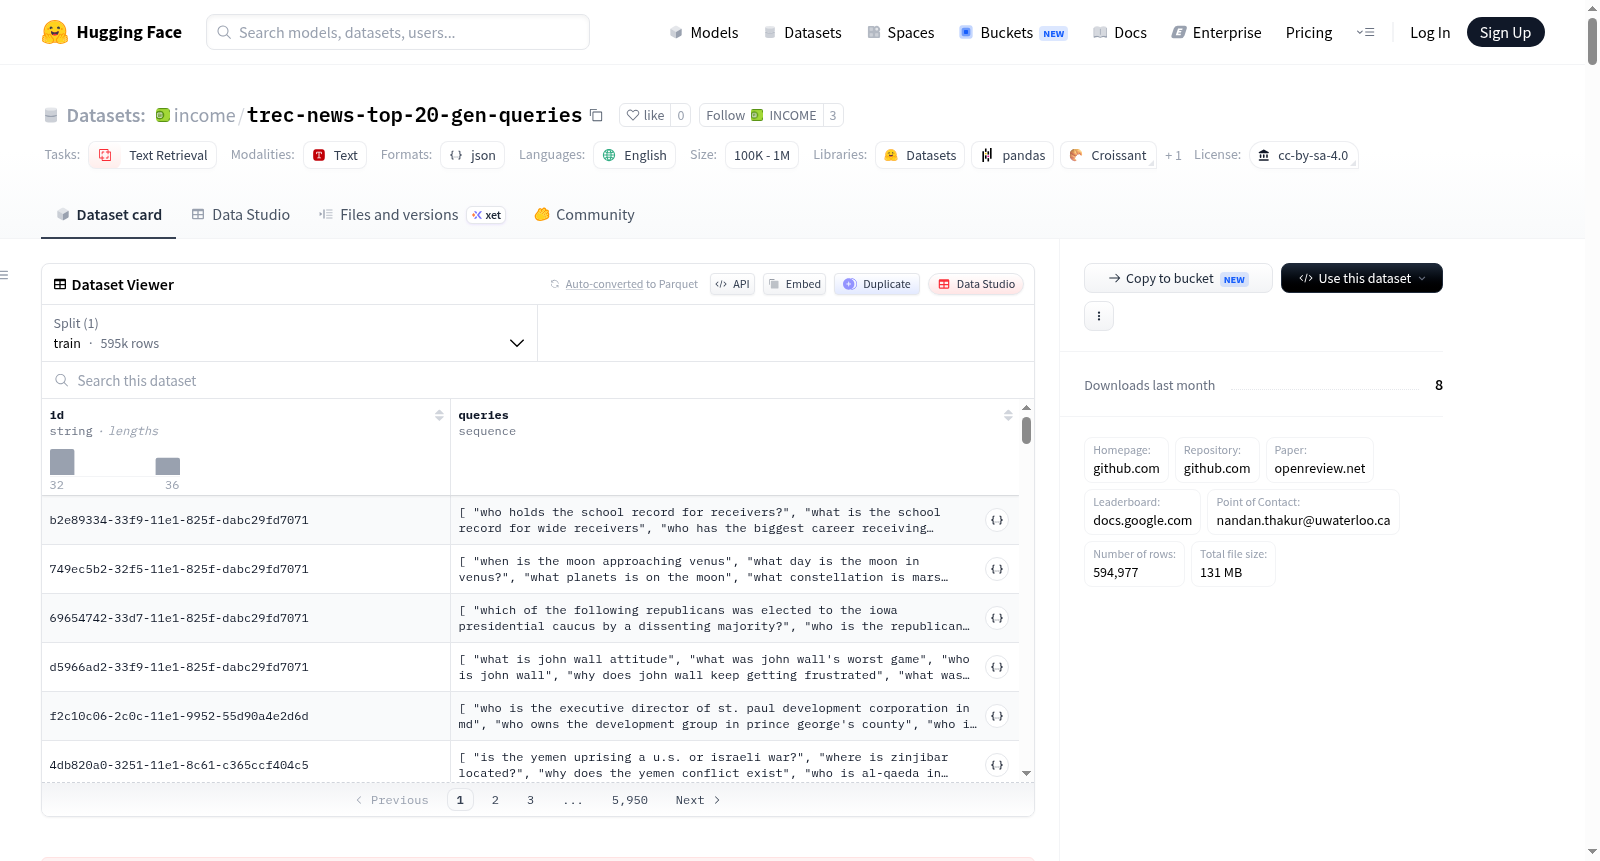
income/trec-news-top-20-gen-queries 数据集图片
构建方式
在信息检索领域,合成查询生成技术已成为增强文档表示与检索性能的重要手段。该数据集以BEIR基准中的NFCorpus语料库为基础,采用DocT5query模型(BeIR/query-gen-msmarco-t5-base-v1)为每个文档段落生成20条合成查询。生成过程依托于evaluate_anserini_docT5query_parallel.py脚本实现并行化处理,确保高效产出。每条数据记录包含唯一的文档标识符(id)及其对应的20个机器生成问题,从而构建起一个丰富的文档-查询映射集合。
特点
该数据集的核心特色在于其大规模、高质量的合成查询覆盖。每个文档配备20条语义相关的生成问题,远超传统人工标注的规模,显著扩充了查询空间的多样性。这些查询由经过MS MARCO语料库微调的T5模型生成,具备良好的语言流畅性与语义相关性,可有效模拟真实用户查询行为。作为BEIR基准的一部分,该数据集继承了NFCorpus在生物医学信息检索领域的专业背景,为领域自适应与零样本评估提供了独特资源。
使用方法
该数据集主要服务于信息检索模型的训练与评估环节。研究人员可将其作为文档扩展(document expansion)的监督信号,通过将生成的查询与原始文档拼接,增强检索系统的语义理解能力。在具体应用中,数据集以HuggingFace格式提供,用户可通过加载id与对应查询列表,直接用于训练文本到文本或稠密检索模型。此外,其与BEIR基准的无缝兼容性,使得模型性能可在标准检索任务上得到便捷验证。
背景与挑战
背景概述
信息检索领域长期面临零样本迁移评估的严峻挑战,即模型在未见过的任务与领域上的泛化能力难以有效度量。为此,来自滑铁卢大学与达姆施塔特工业大学的研究人员Nandan Thakur、Nils Reimers等人于2021年构建了BEIR基准(Benchmark for Zero-shot Evaluation of Information Retrieval),该基准整合了18个涵盖9类检索任务的数据集,包括事实核查、问答、生物医学检索等。其核心研究问题在于评估检索模型在零样本场景下的鲁棒性与适应性,为领域内模型比较提供了统一且严谨的评测框架,对后续研究产生了深远影响。
当前挑战
该数据集所解决的领域挑战在于,传统信息检索评测多聚焦单一任务,难以反映模型在真实世界中的泛化表现,而BEIR通过多任务异构数据集合,全面检验模型的零样本能力。构建过程中的挑战同样显著:需从18个来源各异的数据集中统一格式,确保语料、查询及相关性标注的兼容性;同时,部分数据集规模庞大(如MS MARCO包含近千万文档),预处理与标准化工作繁重;此外,生成合成查询(如本数据集使用DocT5query模型为每篇文档生成20个查询)需平衡质量与多样性,避免引入噪声而影响评测的公正性。
常用场景
经典使用场景
在信息检索领域,该数据集作为BEIR基准测试的重要组成部分,其核心用途在于评估零样本场景下检索模型的泛化能力。通过提供NFCorpus中每个段落对应的20条由DocT5query模型生成的合成查询,研究者能够模拟真实世界中查询与文档之间的语义匹配关系,从而衡量模型在未见过的任务上的表现。这一设计特别适用于对比不同检索架构(如稀疏检索、密集检索或混合方法)在跨领域迁移时的鲁棒性,为模型在医学文献等专业语料中的检索效果提供标准化测试平台。
实际应用
在实际应用中,该数据集为构建可迁移的搜索引擎和知识检索系统提供了关键支撑。例如,在医疗健康领域,模型可借助该数据集在NFCorpus上的合成查询训练,提升对罕见疾病文献的检索准确度;在法律或学术场景中,它可用于优化跨语料库的信息发现工具,减少人工标注依赖。此外,电子商务中的产品匹配、社交媒体中的内容推荐等场景,也能通过借鉴该数据集的零样本评估范式,加速模型从通用语料到垂直领域的适配过程,从而降低部署成本并提升用户体验。
衍生相关工作
基于该数据集,学术界涌现出一系列经典工作。例如,Contriever和SPLADE等模型在BEIR基准上的表现推动了无监督和稀疏检索范式的革新;ColBERT-v2通过后期交互机制在该数据集上取得了突破性成果,验证了细粒度匹配的有效性。此外,DocT5query方法本身作为查询生成技术的代表,启发了后续如GPL(生成式伪标签)等数据增强策略的研究。这些工作共同奠定了现代零样本检索的理论基础,并持续影响着检索增强生成(RAG)等前沿领域的发展方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

