GLOBE_V3
收藏资源简介:
GLOBE是一个高质量的世界英语口音语料库,旨在解决当前零样本说话人自适应文本到语音(TTS)系统在适应带有口音的说话人时存在的泛化能力不足的问题。与常用的英语语料库LibriTTS和VCTK相比,GLOBE语料库独特之处在于包含了来自23519位说话人的发音,覆盖了全球164种口音,并且为这些说话人提供了详细的元数据。GLOBE通过严格的过滤和增强过程显著提高了语音数据的质量,并补充了所有缺失的说话人元数据。最终的GLOBE语料库包含了535小时的24kHz采样率的语音数据。
GLOBE is a high-quality corpus of world English accents, designed to address the insufficient generalization capability of current zero-shot speaker-adaptive text-to-speech (TTS) systems when adapting to accented speakers. Compared with commonly used English corpora such as LibriTTS and VCTK, the GLOBE corpus is unique in that it includes speech data from 23,519 speakers, covering 164 distinct accents across the globe, and provides detailed metadata for these speakers. GLOBE significantly improves the quality of the speech data through a rigorous filtering and enhancement process, and supplements all missing speaker metadata. The final GLOBE corpus contains 535 hours of speech data sampled at 24 kHz.
数据集概述:GLOBE_V3
基本信息
- 语言:英语 (en)
- 许可证:CC0 1.0 (cc0-1.0)
- 源数据集:mozilla-foundation/common_voice_14_0
任务类别
- 文本到音频 (text-to-audio)
- 自动语音识别 (automatic-speech-recognition)
- 音频到音频 (audio-to-audio)
- 音频分类 (audio-classification)
数据集配置
- 默认配置:
- 测试集 (test):
data/test-* - 开发集 (dev):
data/dev-* - 训练集 (train):
data/train-*
- 测试集 (test):
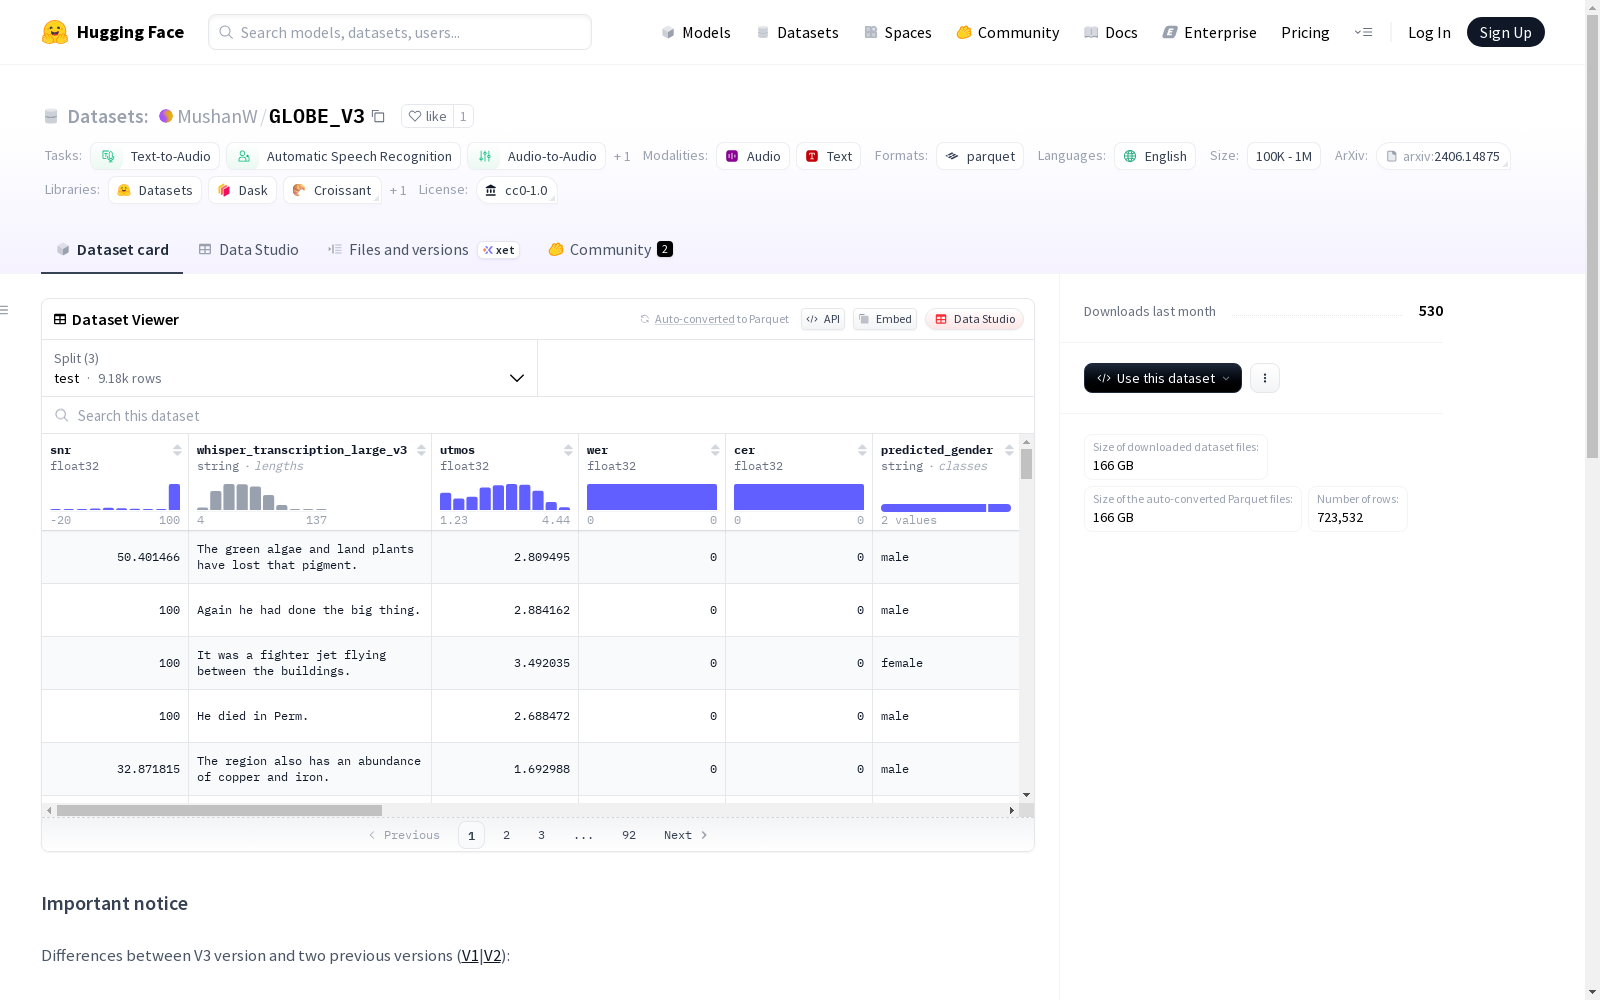
数据集特征
- 音频 (audio): 采样率 24kHz
- 信噪比 (snr): float32
- Whisper转录 (whisper_transcription_large_v3): string
- UTMOS评分 (utmos): float32
- 词错误率 (wer): float32
- 字错误率 (cer): float32
- 预测性别 (predicted_gender): string
- 预测口音 (predicted_accent): string
- 预测年龄 (predicted_age): string
- Common Voice路径 (common_voice_path): string
- Common Voice句子ID (common_voice_sentence_id): string
- Common Voice句子 (common_voice_sentence): string
- Common Voice年龄 (common_voice_age): string
- Common Voice性别 (common_voice_gender): string
- Common Voice口音 (common_voice_accents): string
数据集统计
- 测试集:
- 字节数: 2,259,911,844.426
- 样本数: 9,179
- 开发集:
- 字节数: 2,419,283,219.841
- 样本数: 9,603
- 训练集:
- 字节数: 178,256,158,429.5
- 样本数: 704,750
- 下载大小: 178,190,886,825
- 数据集大小: 182,935,353,493.767
重要通知
- 音频数据仍在上传中,由于网络不稳定,可能需要一周时间完成。
版本差异 (V3与V1/V2)
- 基于 Common Voice 21.0 英语子集构建。
- 仅包含与 Whisper V3 LARGE 转录完全匹配的语音 (CER == 0)。
- 包含原始 Common Voice 元数据 (年龄、性别、口音和ID)。
- 所有音频文件采样率为 24kHz。
- 所有音频文件未经增强。
数据集简介 (GLOBE)
- 目的:解决零样本说话人自适应文本到语音 (TTS) 系统在适应带口音说话人时的泛化能力差的问题。
- 特点:
- 包含来自 23,519 名说话人的语音。
- 覆盖全球 164 种口音。
- 提供详细的说话人元数据。
- 数据质量:通过严格筛选和增强过程显著提高语音质量,并补充所有缺失的说话人元数据。
- 最终数据:535 小时 24 kHz 采样率的语音数据。
引用
bibtex @misc{wang2024globe, title={GLOBE: A High-quality English Corpus with Global Accents for Zero-shot Speaker Adaptive Text-to-Speech}, author={Wenbin Wang and Yang Song and Sanjay Jha}, year={2024}, eprint={2406.14875}, archivePrefix={arXiv}, }