
unlearning-cleanslate/eval-18-debug-llama-3_1-8b-simnpo-gentle-bm25-10b-target-100-localtrain-checkpoint-1
收藏数据链接:
官方服务:
资源简介:
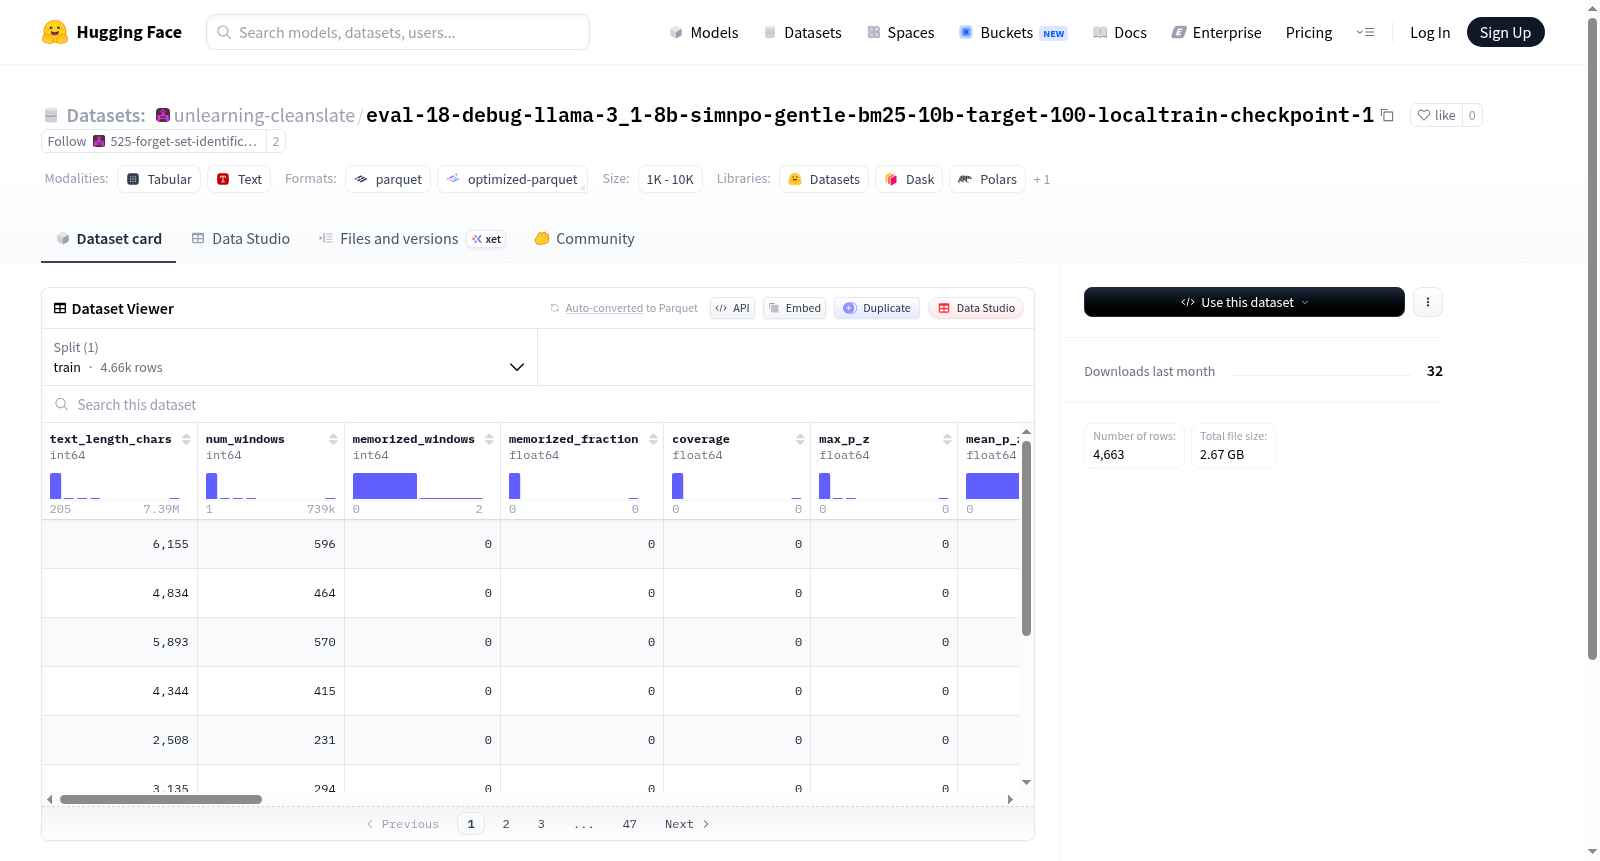
该数据集用于评估语言模型对文本的记忆程度,包含文本长度、滑动窗口、记忆分数、覆盖率等统计信息,以及每个窗口的详细记忆评估结果。
This dataset is used to evaluate the memorization of language models on text, including statistics such as text length, sliding windows, memorization fraction, coverage, and detailed memorization evaluation results for each window.
搜集汇总
数据集介绍
构建方式
该数据集是为评估大语言模型记忆能力而构建的专用评测集,基于LLaMA-3.1-8B模型在SimNPO算法与BM25检索策略联合微调后的中间检查点生成。通过滑动窗口方式将文本切分为片段,并为每个窗口计算模型对数概率及p值统计量,进而判定窗口是否被模型记忆。数据集记录了文本长度、窗口数、记忆窗口比例、覆盖度等宏观统计量,同时详细存储每个窗口的起始位置、目标文本、种子信息以及对应的概率分布特征,形成对模型记忆行为的多维刻画。
特点
该数据集具有精细的窗口级记忆分析能力,提供了从全局覆盖度到单个窗口目标概率分布的完整指标体系。每个样本包含记忆分数、p值统计量(均值、中位数、标准差、最值)以及最佳记忆窗口的详细属性,可全面评估模型在不同文本片段上的记忆强度。此外,数据集还集成了内容元数据(标题、创作者、年份),为探究模型记忆与文本属性之间的关系提供了结构化视角,兼具评测粒度细与信息维度广的双重优势。
使用方法
本数据集以HuggingFace Datasets格式存储,支持通过load_dataset函数直接加载。用户可根据记忆分数或p值阈值筛选特定记忆强度的样本,利用窗口级属性进行模型记忆行为的微观分析。数据集提供的内容元数据字段便于按文本来源进行分组统计,而窗口列表中的概率和排序信息可用于可视化记忆分布或校准评测标准,适用于语言模型记忆机制研究、隐私风险评估及反遗忘训练效果验证等场景。
背景与挑战
背景概述
该数据集名为eval-18-debug-llama-3_1-8b-simnpo-gentle-bm25-10b-target-100-localtrain-checkpoint-1,由研究机构在2024年构建,旨在评估大型语言模型在文本生成过程中的记忆化现象。随着LLaMA-3.1-8B等模型的广泛应用,模型对于训练数据的过度记忆(即“记忆化”)成为影响泛化能力和隐私安全的关键问题。该数据集通过细粒度的窗口分析,量化模型在不同文本片段上的记忆程度,为理解模型行为提供了标准化评估工具。其核心研究问题聚焦于模型何时以及为何会精确复现训练数据中的内容,对推动模型可解释性和隐私保护研究具有重要价值,已成为该领域的重要基准之一。
当前挑战
数据集面临的挑战主要体现在两个方面。在领域问题层面,大型语言模型的记忆化现象直接威胁到数据隐私和模型泛化能力,过高的记忆化可能导致模型在未见数据上表现不佳,甚至泄露敏感信息。在构建过程中,精确界定“记忆化”标准极为困难,需要设计合理的滑动窗口和概率阈值来区分偶然重复与系统性记忆。此外,数据集依赖于特定模型(LLaMA-3.1-8B)和采样策略,其评估结果可能受模型架构、训练数据分布等变量影响,如何保证跨模型评估的通用性和可重复性仍是重要挑战。
常用场景
经典使用场景
在大规模语言模型的隐私审计与安全性评估中,eval-18-debug-llama-3_1-8b-simnpo-gentle-bm25-10b-target-100-localtrain-checkpoint-1数据集扮演着不可或缺的角色。该数据集通过精细化的窗口划分与记忆化指标(如memorized_fraction、coverage、p_z统计量等),为研究者提供了一套评估模型对训练数据记忆程度的标准化工具。最经典的用法是将其作为基准,定量分析不同训练策略(如SimNPO、BM25检索增强)下模型对特定文本片段的记忆倾向,从而揭示模型在生成任务中潜在的隐私泄露风险。研究者通过该数据集能够系统性地比较不同检查点、不同训练目标对模型记忆行为的影响,进而推动更为安全的模型对齐与去记忆化技术的发展。
解决学术问题
该数据集精准回应了自然语言处理领域中关于‘模型记忆与泛化边界’这一核心学术疑难。长期以来,学界难以准确量化大模型究竟在何种程度上‘死记硬背’了训练文本,而非真正理解语义并实现泛化。eval-18-debug-llama-3_1-8b-simnpo-gentle-bm25-10b-target-100-localtrain-checkpoint-1通过定义多维记忆度量(如max_p_z、mean_p_z、best_window_p_z等),为‘记忆’这一模糊概念建立了可复现、可量化的评估框架。它有效解决了如何从概率生成视角区分‘合理复用’与‘病态记忆’的难题,为设计更鲁棒的隐私保护机制提供了理论立足点。此项工作的重要意义在于,它将隐私审计从经验观察提升至统计严谨的层面,深刻推动了模型透明度与可信赖性的研究进程。
衍生相关工作
该数据集的诞生催生了一系列富有启发性的后续研究,尤其在‘可控记忆移除’与‘选择性遗忘’领域凝聚了众多经典工作。例如,部分学者基于其提供的窗口级p_z统计和target_log_probs序列,开发出迭代式的‘反记忆训练’算法,通过动态调整目标窗口的生成概率来消除特定文本片段的记忆痕迹。另一些工作则利用数据集中的content_id与content_creators字段,构建了细粒度的创作者级隐私评估管线,从而在版权争议场景中快速定位高危记忆片段。此外,该数据集还推动了‘记忆归因分析’方向的发展,研究者借助其丰富的窗口元数据(如best_window_idx、window_size、stride),成功追溯了模型记忆行为的源头训练样本,为设计具有明确隐私承诺的模型训练框架奠定了坚实的方法论基础。
以上内容由遇见数据集搜集并总结生成


