
遇见数据集

BCCard/gemma-4-31b-korean-on-policy-150k

收藏
Hugging Face2026-06-20 更新2026-06-21 收录
官方服务:

资源简介:

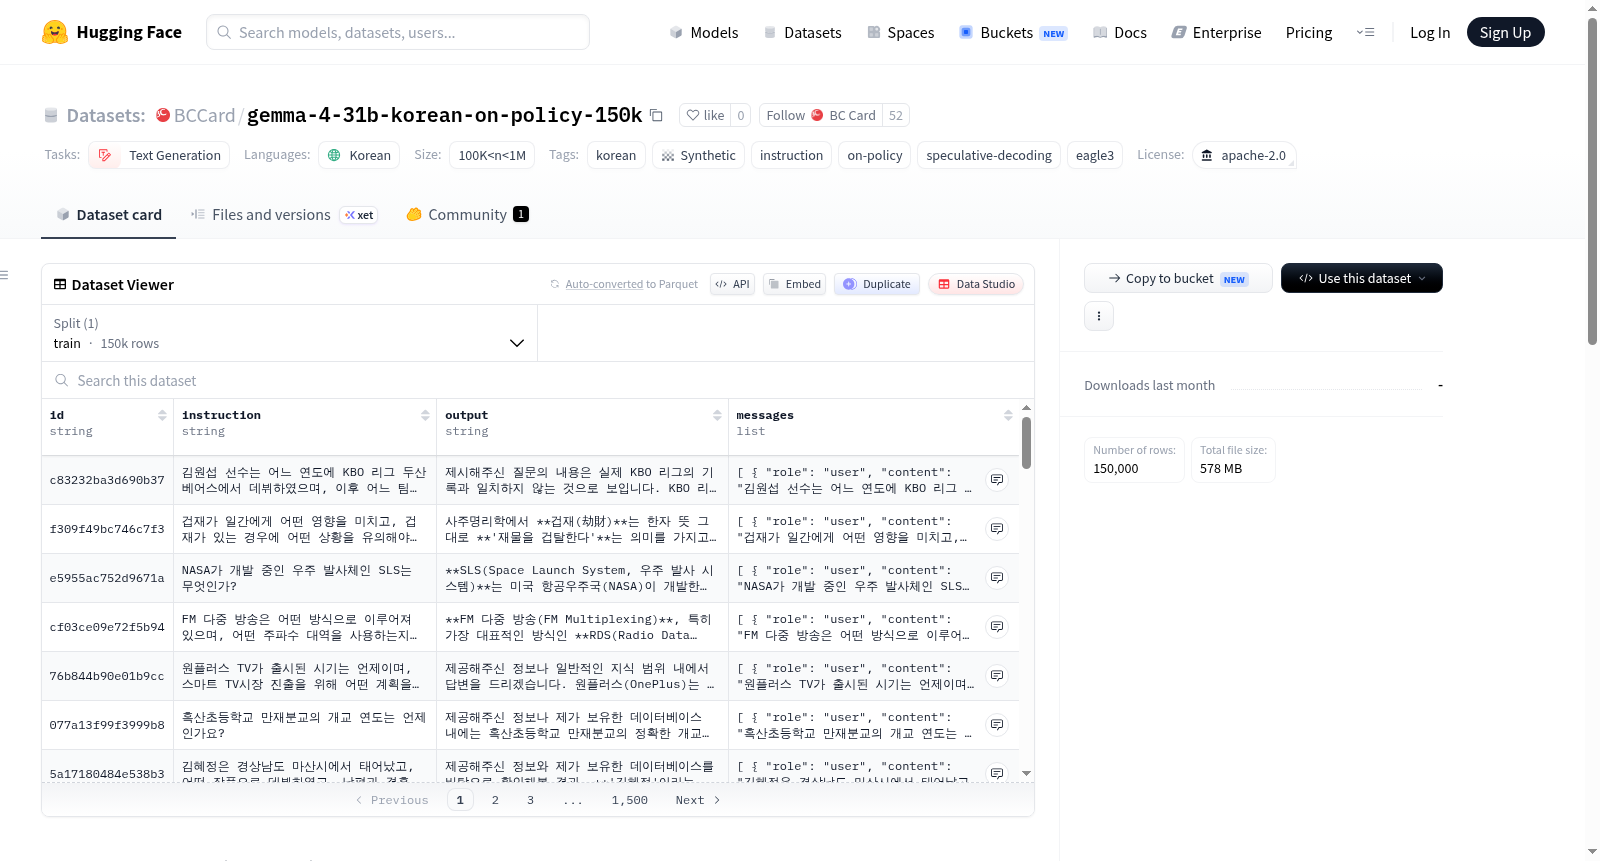
该数据集名为韩语On-Policy问答(Gemma 4)— EAGLE-3训练数据,是一个韩语指令/响应对数据集,其中响应由Gemma 4验证器通过on-policy方式重新生成。最初用于重新训练韩语的EAGLE-3推测器,但也适用于通用的韩语指令调优和蒸馏。数据集包含约150,000行数据,语言为韩语,列包括:instruction(字符串,表示问题/指令)、output(字符串,表示验证器生成的响应)和messages(列表,聊天格式)。数据来源于sh2orc/bccard-maywell-jojo0217-markai-lcw99-kendamarron-microsoft数据集(约171万行韩语问答),仅采样了instruction列(约15万行),原始答案被丢弃。响应由Gemma 4模型(如RedHatAI/gemma-4-26B-A4B-it-FP8-Dynamic或BCCard/gemma-4-31B-it-FP8-Dynamic)生成,生成时关闭思考模式,使用温度1.0、top-p 0.95和top-k 64参数。数据集采用Apache 2.0许可证,提示源数据集和生成响应的Gemma 4模型均为Apache 2.0,响应是Gemma 4生成的合成数据,保留了源数据集的原始归属。

This dataset is named Korean On-Policy QA (Gemma 4) — EAGLE-3 Training Data. It is a Korean instruction-response pair dataset where responses are regenerated via on-policy methods by Gemma 4 validators. Originally developed for retraining the Korean EAGLE-3 speculator, it is also suitable for general Korean instruction tuning and distillation. The dataset contains approximately 150,000 rows of Korean-language data, with three columns: instruction (string, representing questions or instructions), output (string, representing responses generated by validators), and messages (list in chat format). The data is sourced from the sh2orc/bccard-maywell-jojo0217-markai-lcw99-kendamarron-microsoft dataset, which has approximately 1.71 million Korean QA pairs. Only the instruction column was sampled (resulting in ~150,000 rows), and the original answers from the source dataset were discarded. Responses are generated by Gemma 4 models, such as RedHatAI/gemma-4-26B-A4B-it-FP8-Dynamic or BCCard/gemma-4-31B-it-FP8-Dynamic, with thinking mode disabled during generation, using parameters temperature=1.0, top-p=0.95, and top-k=64. The dataset is licensed under Apache 2.0. Both the source prompt dataset and the Gemma 4 models used for response generation are licensed under Apache 2.0. The responses are synthetic data generated by Gemma 4, and the original attribution of the source dataset is retained.
提供机构:
BCCard
搜集汇总
数据集介绍
BCCard/gemma-4-31b-korean-on-policy-150k 数据集图片
构建方式
本数据集专为韩语场景下的语言模型训练而构建,其核心构建方式基于对大规模韩语问答语料库的改造与优化。具体而言,从sh2orc等人收集的包含171万条韩语问答对的数据集中,精选出约15万条指令样本,并完全舍弃原始答案。随后,利用Gemma 4验证器模型(例如RedHatAI/gemma-4-26B-A4B-it-FP8-Dynamic或BCCard/gemma-4-31B-it-FP8-Dynamic)对这些指令进行基于策略的响应重新生成,生成过程中关闭思考模式,并采用温度1.0、top-p 0.95、top-k 64的采样参数,以对齐实际服务时的分布。
特点
该数据集最显著的特点在于其“基于策略”的响应生成机制,即响应由Gemma 4验证器模型在模拟真实服务环境的采样条件下生成,而非简单地从原始数据集中复制。这使得数据集的响应质量更高,且与目标模型的推理分布更为一致。此外,数据集完全以韩语构建,包含约15万条指令-响应对,并同时提供原始文本格式和对话格式(messages字段),方便用户根据不同的微调框架灵活选用。数据遵循Apache 2.0许可协议,来源清晰,便于合规使用。
使用方法
使用该数据集极为便捷,用户可通过HuggingFace的datasets库直接加载。推荐采用如下代码:from datasets import load_dataset; ds = load_dataset("<数据集ID>", split="train")。加载后,可通过ds[0]["instruction"]与ds[0]["output"]分别访问指令和响应。该数据集不仅适用于EAGLE-3投机解码推理器的重新训练,还可广泛用于韩语指令微调、模型蒸馏等任务。用户可根据自身需求,从对话格式或文本格式中选取最合适的列进行训练。
背景与挑战
背景概述
在自然语言处理领域,针对特定语言的高质量指令微调数据稀缺,尤其是朝鲜语(Korean)数据集的构建面临挑战。Gemma-4-31b-korean-on-policy-150k数据集由研究团队基于Apache 2.0许可创建,旨在解决朝鲜语大语言模型的指令遵循与推理能力提升问题。该数据集包含约15万条朝鲜语指令-响应对,由Gemma 4验证器通过on-policy策略重新生成响应,专门用于EAGLE-3推测解码器的再训练,亦可服务于通用朝鲜语指令微调与知识蒸馏任务。其创新之处在于摒弃原始答案,采用与部署分布一致的采样参数(温度1.0、top-p 0.95、top-k 64),确保了数据与目标模型行为的高度对齐,对朝鲜语自然语言处理及推测解码技术发展具有重要推动作用。
当前挑战
该数据集所解决的领域问题核心在于提升朝鲜语大语言模型的生成效率与质量。传统推测解码方法在朝鲜语场景下常因语言特性(如形态丰富性、词序灵活性)导致预测精度不足,而EAGLE-3训练需要严格符合on-policy分布的高质量正反馈数据,这要求响应必须由当前策略下的验证器生成,以保持模型与推测器的一致性。构建过程中面临两大挑战:一是原始数据集包含170万条杂音答案,需精准筛选约15万条高质量指令并彻底丢弃原有响应,以避免引入分布偏移;二是响应再生需在固定随机种子下精确控制采样参数,确保与部署环境一致,同时验证器模型的选取(如Gemma 4-26B或31B版本)直接影响数据保真度,增加了工业化复现的复杂度。
常用场景
经典使用场景
在自然语言处理领域,gemma-4-31b-korean-on-policy-150k数据集最经典的使用场景是对韩语大语言模型进行指令微调与知识蒸馏。该数据集包含约15万条高质量的韩语指令与回应配对,其回应由Gemma 4验证器基于on-policy策略重新生成,从而确保了回应与模型部署时的推理分布高度一致。研究者可将此数据集用于训练EAGLE-3推测解码模块,或在通用韩语指令调优任务中作为监督信号,显著提升模型在韩语问答场景下的响应质量与推理效率。
实际应用
在实际应用场景中,该数据集可被广泛部署于面向韩语用户的高效对话系统与智能客服平台。例如,基于此数据集训练的模型能够在保持低延迟的前提下,流畅地处理韩语复杂指令,适用于韩语搜索引擎的问答模块、虚拟助手以及在线教育平台的智能答疑系统。通过结合EAGLE-3推测解码技术,企业可在不牺牲生成质量的前提下大幅降低推理计算成本,从而在资源受限的边缘设备上也能获得流畅的韩语交互体验,显著提升用户满意度。
衍生相关工作
该数据集的发布催生了一系列在韩语大模型加速与对齐方面的衍生工作。后续研究者可基于其on-policy数据格式,开发更高效的推测解码算法,如改进的EAGLE-3训练策略或自适应草稿模型。同时,数据集中Gemma 4验证器的使用模式也启发了基于奖励模型进行回应重写的流水线,衍生出如迭代式自我提升训练、偏好对齐等技术路径。此外,该数据集与sh2orc等源数据集的结合,为构建更大规模、更高质量的韩语指令数据集提供了可复现的范例,推动了韩语自然语言处理社区的协作发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

