遇见数据集

rebase_vgs_gpt-oss-20b_lcb_v6_ns8_md4_bt0_1_seed42_lcb_v6_vgs_2gpu

收藏
Hugging Face2026-05-07 更新2026-05-08 收录
官方服务:

资源简介:

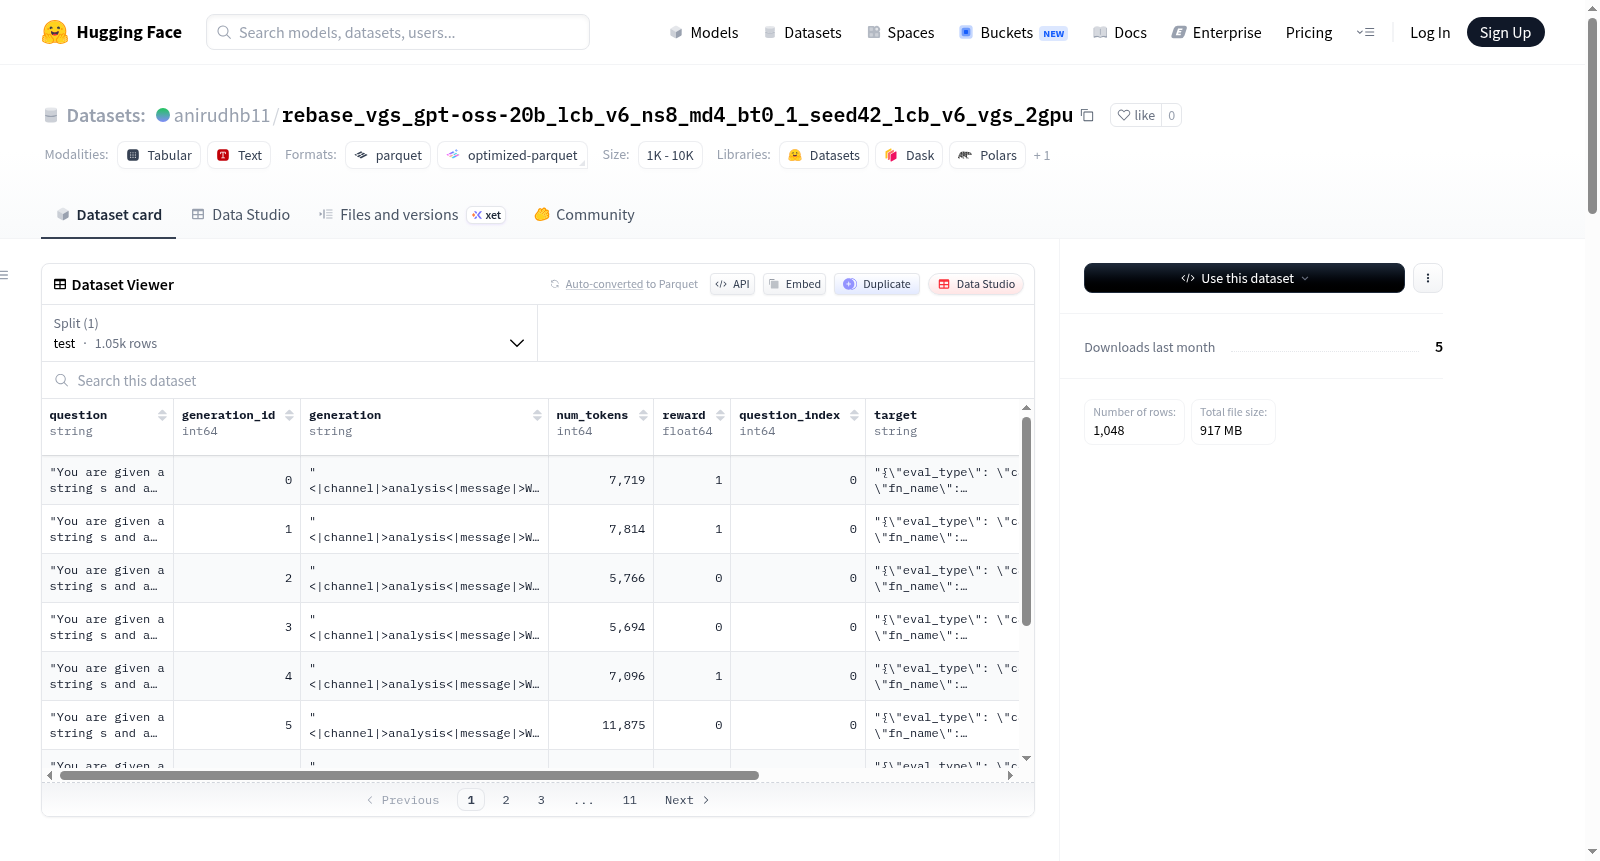
该数据集包含1,048个测试样本,每个样本包含问题、生成ID、生成内容、令牌数量、奖励值、问题索引、目标、任务、vf预测值和级别等多个特征。数据集主要用于评估生成模型的性能,包含丰富的评估指标如pass@1、pass@2等通过率指标,以及各种令牌统计信息。数据集中还记录了不同级别(1-4级)的策略输出令牌数和时间指标,可用于深入分析模型在不同难度级别下的表现。

This dataset contains 1,048 test samples, each of which includes multiple features such as question, generation ID, generated content, token count, reward value, question index, target, task, vf prediction value and level. It is mainly used to evaluate the performance of generative models, and includes rich evaluation metrics such as pass@1, pass@2 and other pass-rate indicators, as well as various token statistics. The dataset also records the number of policy output tokens and time metrics for different levels (levels 1-4), which can be used to conduct in-depth analysis of model performance across varying difficulty levels.

创建时间:
2026-05-07
原始信息汇总

根据您提供的数据集详情页面内容,以下是对该数据集的总结:

数据集概述

该数据集名为 rebase_vgs_gpt-oss-20b_lcb_v6_ns8_md4_bt0_1_seed42_lcb_v6_vgs_2gpu,由用户 anirudhb11 上传至 Hugging Face。

数据特征

数据集包含以下 10 个字段:

  • question:字符串类型,存储问题文本。
  • generation_id:整数类型,生成结果的唯一标识。
  • generation:字符串类型,模型生成的内容。
  • num_tokens:整数类型,生成的 token 数量。
  • reward:浮点数类型,奖励值。
  • question_index:整数类型,问题索引。
  • target:字符串类型,目标答案或参考。
  • task:字符串类型,任务名称。
  • vf_prediction:浮点数类型,价值函数预测值。
  • level:整数类型,级别或难度等级。

数据划分

  • 唯一数据划分test
  • 测试集规模:共包含 1048 个样本
  • 数据集大小:压缩后约 916.95 MB,解压后约 1.57 GB

聚合指标

该数据集来源于某次生成实验,聚合了来自 16 个分片(shard) 的指标。关键性能指标如下:

  • 生成质量指标
    • pass@1:0.6355
    • pass@2:0.6897
    • pass@4:0.7156
    • pass@8:0.7252
    • maj@1maj@8:均为 0
  • Token 统计
    • avg_response_tokens:5915.43
    • median_response_tokens:4201.36
    • total_generated_output_tokens:385,598
  • 时间消耗
    • generation_phase_time_s:390.93 秒
    • total_time_s:666.75 秒
  • 加权最佳指标
    • w_best@1:0.6305
    • w_best@2:0.6611
    • w_best@4:0.6534
    • w_best@8:0.6641

配置信息

  • 配置名称default
  • 数据文件路径data/test-*(匹配多个分片文件)
搜集汇总
数据集介绍
rebase_vgs_gpt-oss-20b_lcb_v6_ns8_md4_bt0_1_seed42_lcb_v6_vgs_2gpu 数据集图片
构建方式
该数据集基于GPT系列开源模型(gpt-oss-20b)在代码生成任务上的推理结果构建而成。研究者采用自洽性采样策略,对每个查询生成8个候选答案,并结合价值引导搜索(VGS)技术进行多轮迭代优化。数据生成过程涵盖搜索树的多个层级,最终筛选出1048个高质量样本构成测试集。每个样本包含原始问题、生成的代码片段、奖励信号以及价值函数预测值等关键信息,确保了数据的多维性和完整性。
特点
数据集的核心特色在于其丰富的评估维度和高质量的标注信息。每个样本不仅记录了代码生成的完整过程,还提供了基于价值函数的预测分数和奖励值,使得模型的选择与排序过程透明可追溯。聚合指标显示,该数据集在pass@1指标上达到63.5%,且随着候选数量增加,性能稳定提升至pass@8的72.5%,验证了自洽性采样的有效性。此外,数据集中包含的搜索时间记录和token统计信息,为分析模型推理效率提供了宝贵依据。
使用方法
该数据集主要适用于代码生成模型的评估与训练场景。用户可直接加载测试集,利用其中的question和target字段进行监督学习或微调。同时,reward和vf_prediction字段可用于强化学习中的奖励打分或价值函数训练。在评估方面,研究者可借助多层次的pass@k和maj@k指标对比不同模型的代码生成能力。由于其已经预先完成采样和评分,亦可作为基准测试集,用于验证新型采样策略或奖励模型的性能。
背景与挑战
背景概述
该数据集由Open Source Society(OSS)研究团队于近期构建,专注于提升大型语言模型在代码生成任务中的监督微调效果。其核心研究问题围绕如何利用价值引导搜索(Value-Guided Search, VGS)技术,通过多轮树搜索与奖励模型反馈,优化代码生成的准确性与多样性。数据集的规模虽小(1048个样本),但每个样本均包含基于价值函数预测的生成结果、奖励评分及多层级搜索信息,为探索强化学习与语言模型对齐提供了高保真度的实验平台。尽管数据集尚处早期阶段,其在代码生成领域的创新方法论——如结合搜索阶段与价值引导策略——已为后续研究奠定了重要基础,尤其在提升Pass@1指标上展现了显著潜力。
当前挑战
该数据集所面临的挑战首先体现在领域问题层面:代码生成任务要求模型不仅理解自然语言问题,还需生成逻辑正确且风格一致的代码,这对模型的语义理解与结构化推理能力构成严峻考验。尤其当问题复杂度上升时,现有模型在单次生成中难以保证不出错,亟需多轮搜索与验证机制。在构建过程中,数据集引入了价值引导的多阶段树搜索,然而搜索策略的效率与奖励模型的准确性仍存在瓶颈——聚合指标显示Pass@1仅为0.635,且多数投票(Maj@K)指标为0,说明简单投票策略失效,而加权最佳(W_best@K)指标虽略优但波动较大,暴露出搜索路径的鲁棒性与泛化性不足。此外,16个分片间的汇总统计显示,生成耗时与复杂度呈高度非线性增长,如何在有限计算资源下权衡生成质量与效率,仍是亟待攻克的关键难题。
常用场景
经典使用场景
该数据集聚焦于代码生成任务的强化学习与自回归语言模型微调,其经典使用场景是作为评估和训练代码生成式大语言模型的基准。通过提供的1048个测试样本,每个样本包含问题描述、模型生成代码、生成token数、奖励值、任务类型及难度等级等字段,研究者可借此测试模型在不同复杂度(level 1-4)下的代码生成能力。数据集中丰富的pass@k指标反映了模型多次采样后至少一次正确生成的概率,这使得该数据集特别适用于衡量模型在编程问题上的鲁棒性与多样性生成能力。此外,其中的vf_prediction和reward评分能够助力探索基于价值函数的强化学习训练策略,从而优化模型的代码生成质量。
实际应用
在工业界,该数据集可被直接用于提升自动化编程助手的代码生成质量。例如,在集成开发环境(IDE)中,基于该数据集微调后的模型能够在用户输入需求描述后,自动生成多份候选代码,并通过投票或奖励值排序机制选出最优解。数据集中的难度分级(level)有助于开发针对初级开发者或高级工程师的定制化代码推荐系统。此外,该数据集还能辅助构建代码审查自动评分系统,通过模型中生成的reward值对候选代码的完整性和正确性进行量化评估,从而在持续集成流水线中实现更精准的自动化测试与质量监控。
衍生相关工作
该数据集的构建理念和技术指标与多项经典工作相关。其采用的VGS(Value-Guided Search)策略源自强化学习领域的状态价值引导搜索思想,相关研究包括使用蒙特卡洛树搜索优化代码生成的AlphaCode类工作。数据集中的pass@k指标评估体系借鉴了OpenAI的Codex论文中所提出的采样评估方法,并扩展到多轮搜索过程。此外,加权投票机制w_maj@k与最佳采样w_best@k的设计参考了语言模型集成与自洽性解码策略,类似于Self-Consistency方法。这些衍生工作共同构成了一个从基础采样到复杂搜索策略的完整技术谱系,持续推动代码生成模型向更可靠、更高效的方向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务