
omlab/Cross_DIOR-RSVG
收藏官方服务:
资源简介:
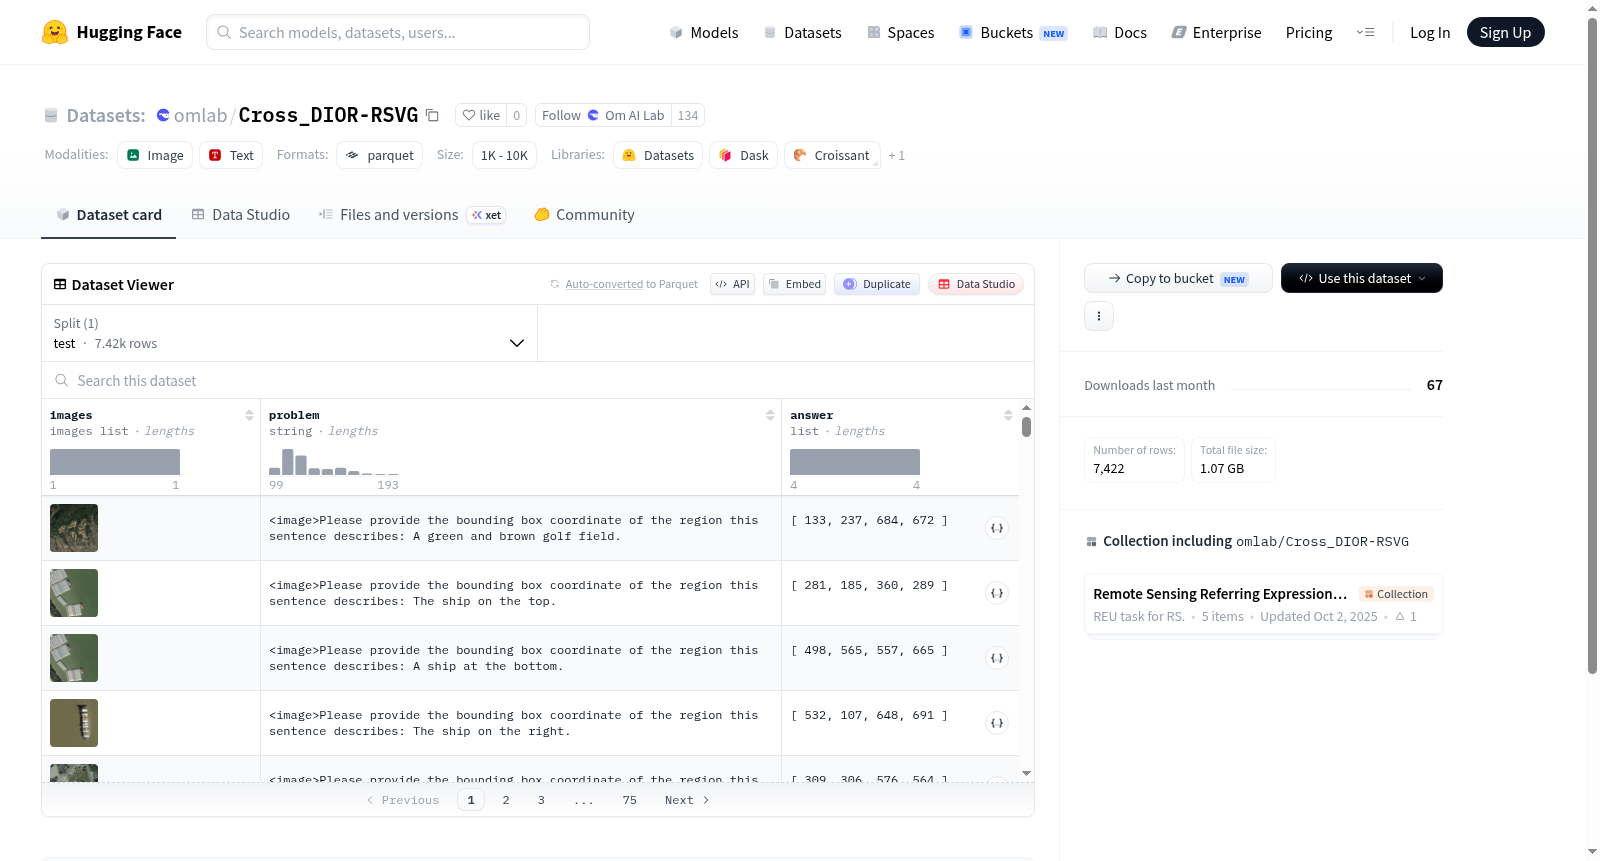
这个数据集包含图片、问题和答案。图片以列表形式存在,问题是一个字符串,答案是一个整型列表。数据集分为测试集,测试集的文件路径模式为data/test-*。
The dataset includes images, problems, and answers. Images are in the form of a list, the problem is a string, and the answer is a list of integers. The dataset is split into a test set, with the file path pattern for the test set being data/test-*.
提供机构:
omlab搜集汇总
数据集介绍
构建方式
在遥感图像理解领域,视觉定位与语义解析的协同发展至关重要。omlab/Cross_DIOR-RSVG数据集以DIOR-RSVG基准为基础构建,通过整合多源遥感图像与自然语言描述,形成了跨模态的视觉-语言对齐资源。数据集包含图像、问题文本及对应答案三个核心字段,其中图像以列表形式存储,问题为字符串类型,答案则采用整数列表形式记录。构建过程中,数据被统一划分为测试集,并以分片格式(test-*)组织存储,便于分布式加载与高效处理。
使用方法
使用该数据集时,可通过HuggingFace的datasets库直接加载,指定配置名称为'default'并选择'test'分片即可获取数据。加载后,数据集以字典形式返回,包含'images'、'problem'和'answer'三个键。'images'为图像对象列表,可配合torchvision等库进行预处理;'problem'为自然语言问题字符串,需通过分词器转换为模型输入;'answer'为整数列表,可直接作为分类或回归任务的目标标签。建议采用批处理方式迭代数据,并利用datasets库的map函数实现高效的图像增强与文本编码流水线。
背景与挑战
背景概述
在遥感图像理解领域,视觉定位与推理任务长期面临跨模态语义对齐的挑战。omlab/Cross_DIOR-RSVG数据集由omlab团队创建,旨在推动遥感场景下基于自然语言描述的视觉定位研究。该数据集以DIOR遥感图像库为基础,通过引入复杂的空间关系与属性描述,构建了包含图像、问题与答案三元组的细粒度评估基准。其核心研究问题在于如何使模型在遥感图像的多尺度、多方向特性中,准确理解语言指令并定位目标区域。自发布以来,该数据集已成为评估跨模态遥感智能系统的重要标准,显著推动了地理空间信息处理与视觉语言融合领域的发展。
当前挑战
当前数据集面临的核心挑战在于遥感图像特有的领域复杂性。首先,遥感图像中目标尺度差异巨大、方向多变,且存在大量背景干扰,这使得模型难以从全局场景中精准分离出与语言描述对应的语义区域。其次,数据集的构建过程需人工标注大量包含空间关系与属性约束的问答对,标注一致性难以保证,且不同标注者对“附近”“内部”等模糊空间术语的理解差异会引入噪声。此外,现有模型往往依赖预训练视觉特征,但这些特征在遥感域与自然图像域之间存在显著分布偏移,导致跨域泛化能力不足。
常用场景
经典使用场景
在视觉与语言交叉领域,Cross_DIOR-RSVG数据集为跨模态语义理解提供了关键支撑。该数据集聚焦于遥感图像中的视觉定位与场景图生成任务,通过将自然语言查询与高分辨率遥感影像对齐,构建了具有挑战性的多模态推理基准。研究者可借助该数据集训练模型,使其能够根据文本描述精准定位图像中的目标对象,并理解目标间的空间关系与属性特征,从而推动跨模态对齐、视觉推理以及遥感智能解译技术的发展。
解决学术问题
该数据集有效解决了遥感领域视觉与语言跨模态对齐的学术难题。传统方法多依赖单一模态特征,难以应对遥感图像中目标尺度多变、背景复杂、语义模糊等挑战。Cross_DIOR-RSVG通过提供精细化的图文对标注,使模型能够学习从自然语言到空间位置的映射关系,显著提升了零样本与少样本场景下的视觉定位精度。这一突破为多模态学习、视觉问答及场景图生成等研究方向提供了高质量的数据基础,推动了遥感智能分析从感知向认知的跃迁。
实际应用
在实际应用中,Cross_DIOR-RSVG可赋能遥感图像智能解译系统。基于该数据集训练的模型能够自动响应自然语言查询,快速定位地理空间中的关键目标,如建筑物、道路或植被区域,广泛应用于城市规划、灾害监测、军事侦察等领域。例如,用户可通过语音或文本指令检索卫星图像中的特定地物,极大提升了非专业用户访问遥感数据的效率,为人机协作的智能地理信息服务奠定了基础。
数据集最近研究
最新研究方向
在遥感图像理解领域,跨模态视觉定位与视觉问答的融合正成为前沿热点。omlab/Cross_DIOR-RSVG数据集聚焦于遥感场景下的指代表达理解(Referring Expression Comprehension)任务,要求模型根据自然语言描述在遥感图像中精准定位目标。该数据集结合了DIOR遥感图像分类基准与RSVG视觉定位任务,构建了包含多样化地理空间对象与复杂语义关系的评测基准。当前研究趋势集中于利用多模态大语言模型(如CLIP、BLIP-2)进行遥感图像的零样本或少样本跨模态对齐,探索在卫星图像中实现高精度、细粒度的目标指代定位。这一方向对提升灾害监测、城市规划等应用中的自动化地理信息提取能力具有重要推动意义,尤其在高分辨率遥感数据日益丰富的背景下,推动了视觉语言模型在垂直领域的落地与泛化能力验证。
以上内容由遇见数据集搜集并总结生成


