
遇见数据集

GaloisInc/fvspec-pbt

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

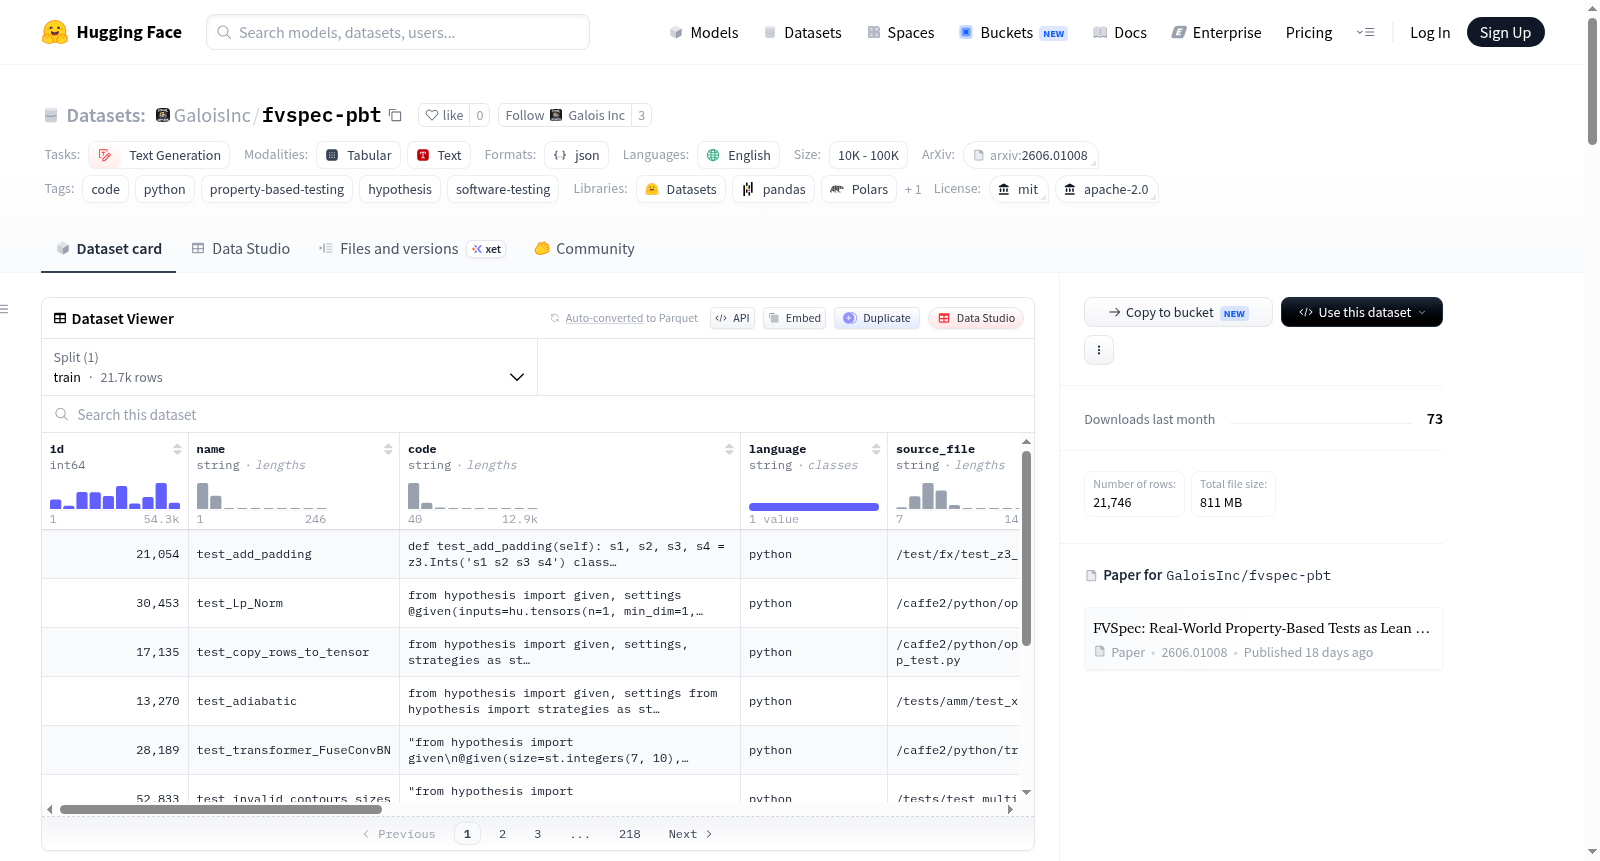
RealPBT是一个包含21,746个真实世界Python属性测试的语料库,这些测试从645个开源仓库中挖掘而来。每一行数据代表一个单独的测试,并配有其解析后的依赖闭包、复杂度配置以及(对于有评分子集)被测试属性的自然语言摘要。该数据集是FVSpec的源数据集:每个FVSpec Lean 4形式化都源自这些属性测试之一。用户可以直接使用RealPBT来研究真实世界的测试实践,或作为自己形式化或测试生成流程的输入。

RealPBT is a corpus consisting of 21,746 real-world Python property tests, mined from 645 open-source repositories. Each entry in the dataset represents a standalone test, paired with its parsed dependency closure, complexity configuration, and (for the scored subset) a natural language summary of the property under test. This dataset serves as the source corpus for FVSpec: every FVSpec Lean 4 formalization is derived from one of these property tests. Users can directly utilize RealPBT to study real-world testing practices, or use it as input for their own formalization or test generation workflows.
提供机构:
GaloisInc
搜集汇总
数据集介绍
GaloisInc/fvspec-pbt 数据集图片
构建方式
fvspec-pbt数据集通过从645个开源Python仓库中系统性地挖掘真实世界的属性基测试(Property-Based Testing, PBT)构建而成。研究团队首先筛选出采用Hypothesis等框架的测试文件,然后逐一解析每个测试函数及其依赖关系,构建出包含21,746条测试样本的语料库。每个样本不仅保留测试代码本身,还通过静态分析提取其复杂性轮廓,并为其中7,627个测试附上自然语言描述,从而形成了结构丰富、层次清晰的数据基础。
使用方法
用户可通过HuggingFace的datasets库便捷加载该数据集,并利用内置的筛选功能进行精细化操作。例如,可过滤出包含自然语言描述的子集以研究测试意图,或选择无外部依赖的独立测试以简化分析流程。该数据集还可作为上游输入,结合形式化验证流水线生成面向Lean 4的规范(fvspec-fv),适用于软件测试实践研究、代码理解评估及自动形式化验证等场景。
背景与挑战
背景概述
fvspec-pbt数据集由Galois Inc.团队于2026年创建,核心研究人员包括Quinn Dougherty、Hazel Shackleton、Max von Hippel和Mike Dodds,相关研究发表于arXiv(2606.01008)。该数据集从645个开源Python仓库中提取了21,746个真实世界的属性基测试(PBT),旨在为程序理解与规范生成提供抗污染的数据基础。每个测试实例不仅包含完整的源代码,还附带解析后的依赖闭包、静态复杂度画像以及部分样本的自然语言属性描述。该数据集作为fvspec-fv形式化管道的上游输入,支撑从Python属性到Lean 4形式化规约的自动映射,对软件测试与形式化验证交叉领域具有重要推动作用。
当前挑战
fvspec-pbt所解决的核心挑战在于,现有代码数据集多依赖合成编程问题,易与模型训练数据泄露,而真实世界的生产级测试用例(如Hypothesis策略、pytest装置和断言式不变量)的收集与结构化极为困难,涉及复杂依赖解析、跨文件引用追踪及许可证兼容性评估。在构建过程中,团队面临从645个仓库中挖掘21,746个测试时,需处理约100K函数、52K赋值、25K类和15K方法组成的依赖图谱,并计算包括圈复杂度、可维护性指数及Halstead复杂度在内的静态指标,同时确保96%的测试能解析出至少一个依赖项,这些技术挑战对数据质量和可用性提出了严苛要求。
常用场景
经典使用场景
在软件测试与程序语言研究的交叉领域中,fvspec-pbt数据集为基于属性的测试(Property-Based Testing, PBT)提供了宝贵的真实世界语料。其经典使用场景在于作为评估程序理解与规约生成能力的基准——研究者可借助该数据集中超过两万条来自真实开源项目的Python测试函数,结合其静态复杂度画像与依赖闭包,训练或评测模型对测试意图的解析能力。例如,利用带自然语言摘要的子集,可以构建从测试代码到属性描述的跨模态映射,进而推动自动化测试生成技术迈向更贴近工程实践的范式。
解决学术问题
该数据集的核心学术贡献在于弥合了合成测试样例与现实工程测试之间的鸿沟。传统研究多依赖人工构造或竞赛题目衍生的测试数据,难以避免数据泄露与生态效度不足的问题。fvspec-pbt通过系统性地采集GitHub上645个仓库中工程师手写的Hypothesis和pytest测试,为探究真实世界测试模式的统计规律、依赖关系结构以及复杂性与可维护性的分布特征提供了可信基础。研究者可据此验证代码理解模型在未见过的、带有工程噪音的测试样本上的泛化能力,从而推动软件工程与机器学习交叉领域的实验方法论革新。
实际应用
在实际应用层面,fvspec-pbt可直接服务于工业级测试基础设施的智能化升级。结合其包含的依赖解析信息,开发者可以构建定制化的规约形式化流水线——例如将Python属性测试自动转化为Lean 4形式化规约,正如该数据集作为fvspec-fv上游输入的预设场景。此外,该数据集的静态度量字段(如圈复杂度、Halstead难度)可用于训练质量预测模型,辅助团队在持续集成流程中筛选高风险测试用例。对于采用MIT、Apache等宽松许可的测试样本,企业还可将其纳入内部测试生成模型的微调数据,以提升自动化测试工具对真实编码模式的适应性。
数据集最近研究
最新研究方向
fvspec-pbt作为首个大规模真实世界Python属性化测试语料库,正推动软件工程领域对基于性质的测试(PBT)实践的系统性研究。该数据集从645个开源仓库中提取21,746个真实测试用例,每个测试均附带完整的依赖闭包、静态复杂度指标及属性自然语言描述子集,为研究工业级PBT模式、测试可维护性及形式化验证提供了无污染基准。当前前沿方向聚焦于利用该数据集训练代码智能体实现测试用例自动形式化(如转化为Lean 4规范),以及通过依赖解析与复杂度分析揭示PBT在大型软件系统中的分布规律与演化特征,相关成果已发表于《Real-World PBTs as Lean Specs》(arXiv:2606.01008),为提升软件可靠性与可验证性开辟了新路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

