
rw_amazon-ratings_standard_1_public
收藏官方服务:
资源简介:
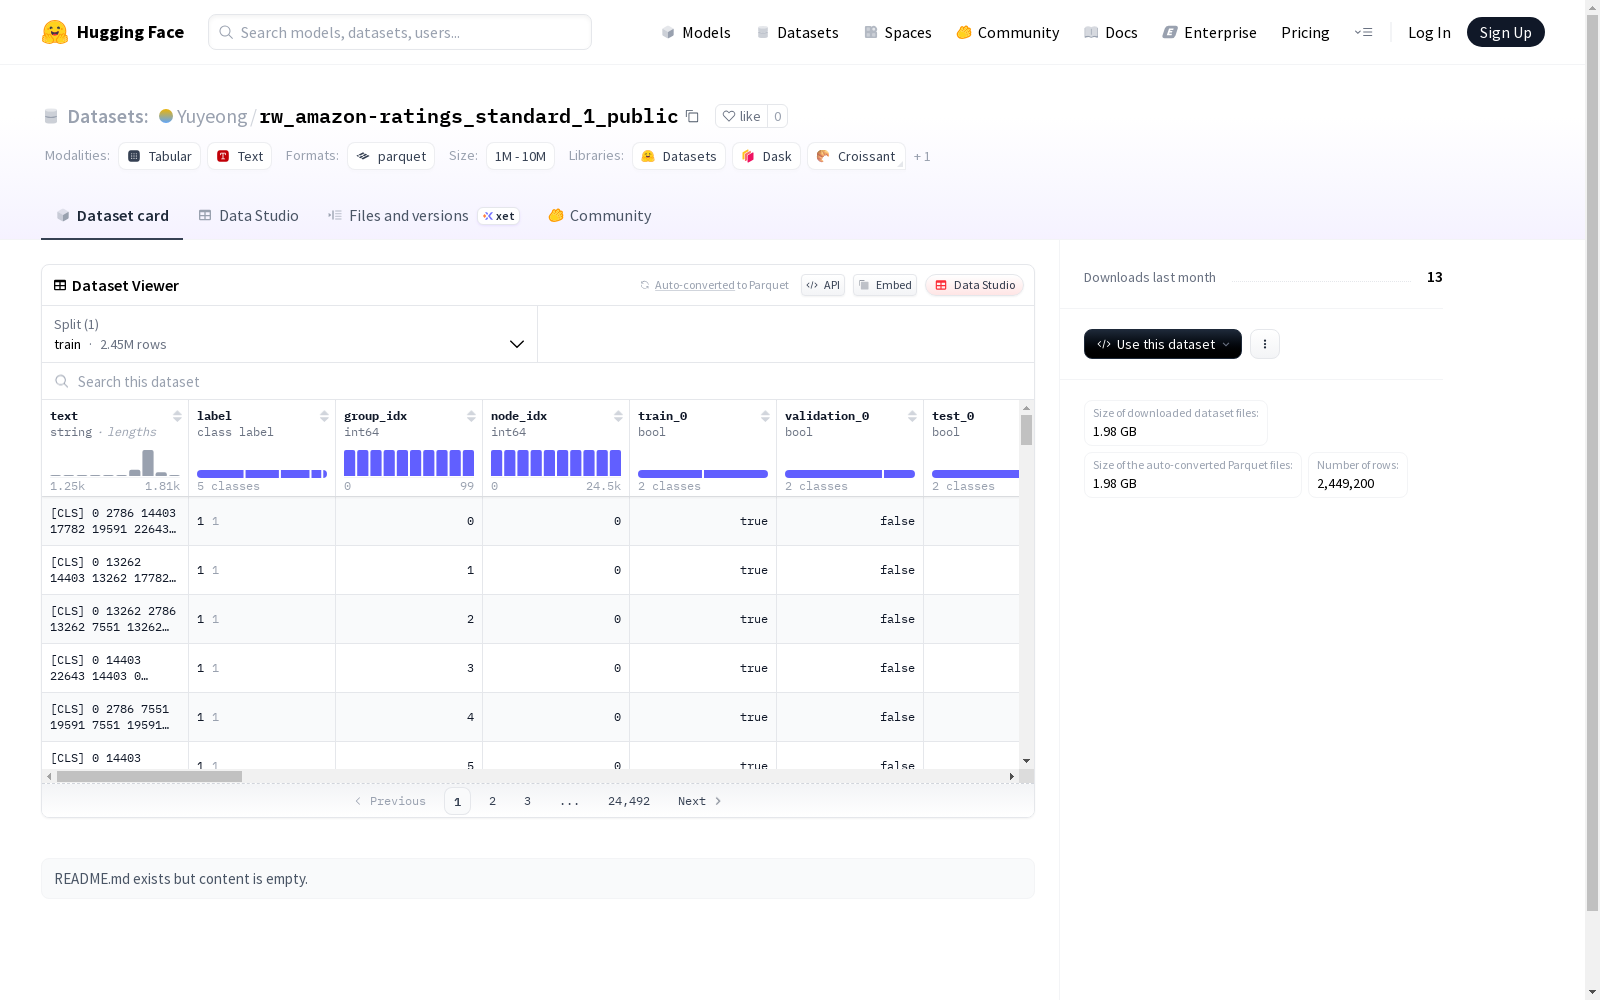
该数据集包含文本数据和对应的标签,共有五个标签类别。数据集还包含了组索引和节点索引信息,以及针对不同类别的训练、验证和测试集的布尔标记。数据集的总大小为4162885583字节,包含2449200个训练样本。
This dataset contains textual data and their corresponding labels, with a total of five label categories. It also includes group index and node index information, as well as boolean flags for training, validation, and test sets corresponding to each label category. The total size of the dataset is 4162885583 bytes, and it contains 2449200 training samples.
创建时间:
2025-05-24
搜集汇总
数据集介绍
构建方式
在电子商务文本分析领域,该数据集源自亚马逊平台用户评价的标准化处理。构建过程采用分层抽样策略,从原始评论中提取文本内容与对应的星级评分标签,通过结构化编码将每个样本标记为文本、标签及索引特征。数据划分涵盖多个训练、验证和测试子集,每个子集通过布尔值字段明确标识,确保数据分割的严谨性和可追溯性。
特点
该数据集的核心特征体现在其多维度的标注体系,不仅包含用户评论文本和0至4分的五级评分标签,还引入了组索引与节点索引以支持复杂的数据关联分析。独特的结构设计提供了多达十组并行划分方案,每组均具备独立的训练、验证和测试标识,为模型鲁棒性验证和交叉验证研究创造了优越条件。数据规模的宏大性进一步保障了统计分析的可靠性。
使用方法
针对情感分析与评分预测任务,使用者可通过加载标准数据分割字段快速构建实验环境。利用train_X、validation_X和test_X系列布尔标志可直接提取对应子集,文本字段用于特征工程,标签字段作为监督信号。多组划分方案支持算法在异构数据分布下的性能评估,节点索引则为图神经网络等进阶模型提供拓扑结构基础。
背景与挑战
背景概述
随着电子商务平台的蓬勃发展,用户生成内容如产品评论成为情感分析和推荐系统研究的重要数据源。rw_amazon-ratings_standard_1_public数据集由学术研究机构在近年构建,旨在支持多类别评分预测任务,其核心研究问题聚焦于从文本评论中精准推断用户对产品的满意度等级,该数据集通过大规模真实评论数据推动了自然语言处理领域的情感分类模型优化。
当前挑战
该数据集致力于解决情感分析中多级评分预测的复杂性,包括处理文本表达的模糊性和评分主观性等挑战。构建过程中,研究人员面临数据清洗的艰巨任务,需从原始评论中去除噪声并确保标签一致性,同时平衡不同评分等级的样本分布以提升模型泛化能力。
常用场景
经典使用场景
在电子商务和自然语言处理领域,rw_amazon-ratings_standard_1_public数据集被广泛用于文本分类任务,特别是情感分析和评分预测。该数据集包含大量亚马逊商品评论,每条评论对应一个从0到4的评分标签,为研究者提供了丰富的文本数据和对应的情感极性标签。通过这一数据集,可以训练机器学习模型自动识别用户评论中的情感倾向,从而评估商品满意度。
解决学术问题
该数据集有效解决了情感分析中的细粒度分类问题,支持多类别情感标签的预测,提升了模型在真实场景下的泛化能力。其大规模和高多样性的评论数据有助于克服过拟合问题,推动自然语言处理领域在语义理解方面的进展。通过该数据集,研究者能够探索文本特征与评分之间的关系,为情感计算提供可靠的数据基础。
衍生相关工作
基于该数据集,衍生出多项经典研究,如基于深度学习的文本分类模型优化、跨领域情感迁移学习等。这些工作不仅提升了情感分析的准确率,还推动了预训练语言模型在电商场景的应用,为后续研究提供了重要参考。
以上内容由遇见数据集搜集并总结生成


