遇见数据集

telemlebench-releases

收藏
Hugging Face2026-08-04 更新2026-08-05 收录
官方服务:

资源简介:

TeleMLEBench是一个电信机器学习数据集版本发布仓库,托管不可变的、版本化的数据集。每个发布版本包含源清单、校验和、出处信息、明确的任务和数据集划分元数据以及数据卡片。数据集仅在合法重新分发时发布字节;对于仅提供链接的记录,保留经过验证的检索指令。当前处于第一波发布准备阶段。该数据集面向电信领域的机器学习研究和应用,支持可重现、泄露感知的评测流程。

TeleMLEBench is a versioned repository for telecommunication machine learning datasets, hosting immutable and versioned datasets. Each released version includes a source manifest, checksums, provenance information, clear task definitions, dataset split metadata and data cards. The dataset releases its data bytes only when legally redistributed; for records that only provide links, verified retrieval instructions are retained. Currently, it is in the preparation phase for its first wave of releases. This dataset is targeted at machine learning research and applications in the telecommunications domain, supporting reproducible and leakage-aware evaluation workflows.

创建时间:
2026-07-31
原始信息汇总

TeleMLEBench Releases 数据集概述

基本信息

  • 数据集名称:TeleMLEBench Releases
  • 发布方:TeleMLEBench 项目
  • 数据集地址:https://huggingface.co/datasets/NextGLab/telemlebench-releases
  • 数据集性质:不可变的、带版本号的电信机器学习数据集发布集合

数据集内容

  • 每个发布版本包含以下核心组件:
    • 源清单:记录数据来源
    • 校验和:确保数据完整性
    • 来源信息:追踪数据溯源
    • 明确的任务与划分元数据:标注任务类型和数据划分方式
    • 数据卡片:提供数据集的详细说明
  • 数据集字节仅在合法再分发的情况下发布;仅含链接的记录会保留经过验证的检索指令

当前状态

  • 首批发布版本正在准备中

方法论与特性

  • 方法原则:源头优先、防泄漏、可复现
  • 许可政策:每个发布版本附带其上游许可证和再分发决定

相关资源

  • 目录网站:https://telemlebench.org
搜集汇总
数据集介绍
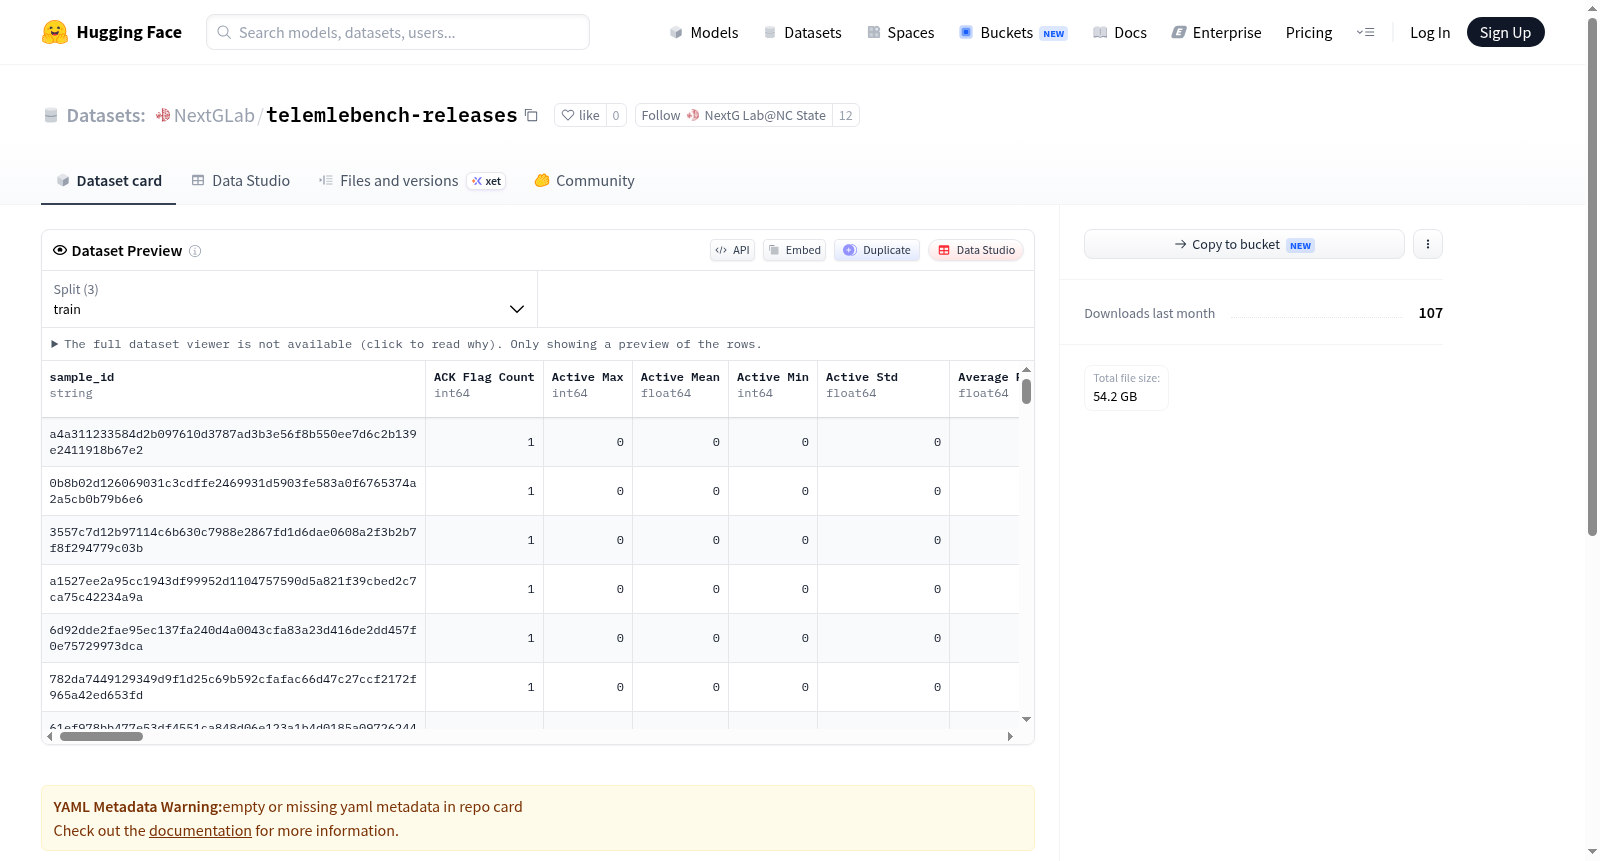
telemlebench-releases 数据集图片
构建方式
TeleMLEBench Releases数据集由TeleMLEBench平台精心编纂,旨在提供电信机器学习领域不可变且版本化的数据发布。其构建遵循源头优先、防泄漏、可复现的严谨方法论。每次发布均包含一份详尽的源清单、校验和、溯源信息、明确的任务与划分元数据,以及配套的数据卡片。数据集字节仅在法律允许转发的条件下公开,对于仅含链接的记录,则保留了经过验证的获取说明,从而确保数据来源的合法性与可靠性。
使用方法
使用TeleMLEBench Releases时,研究者需首先访问其官方目录(telemlebench.org)以获取最新发布信息。随后,依据数据卡片选择合适的任务与数据划分。对于开放字节的数据集,可直接下载并按需使用;对于链接记录,则需遵循其提供的验证指令完成获取。在实验过程中,应严格遵循每份发布所附带的上游许可与再分发决策,确保合法合规地利用数据开展机器学习模型训练与评估。
背景与挑战
背景概述
TeleMLEBench Releases是TeleMLEBench项目于近期发布的版本化电信机器学习数据集存储库,由该项目的核心研究团队创建,旨在解决电信领域机器学习研究中数据碎片化、不可复现与分布漂移等根本性问题。该数据集集合以源优先、防泄漏与可复现为方法论,为电信网络优化、故障预测、资源管理等任务提供标准化的评测基准。通过引入不可变版本、来源清单、校验和与数据卡片,TeleMLEBench填补了电信领域缺乏权威、可追溯数据集的空白,其影响力在于推动电信AI研究的实证严谨性,成为连接学术研究与工业应用的桥梁。
当前挑战
该数据集面临的挑战一方面源于电信领域固有的复杂性:网络数据呈现高度时空异质性、噪声混杂与标签稀疏,且涉及用户隐私与运营安全,导致数据获取与合法共享极为困难,限制了数据集的规模与代表性。另一方面,构建过程中需克服版本漂移与跨域泛化问题,确保数据集在时间演进下仍保持任务一致性与泄漏防护;同时,异源数据的整合需严格校验来源与授权,平衡可复现性与法律合规性,使得发布流程在数据清洗、标注与元数据标准化方面面临多重技术和管理难题。
常用场景
经典使用场景
TeleMLEBench Releases 作为电信机器学习领域的基准数据集集合,其经典使用场景在于为研究人员提供一个标准化、可复现的评估平台。该数据集通过不可变版本管理、源清单及校验和机制,确保实验的透明性与可追溯性,广泛应用于电信网络优化、故障预测、资源调度等模型的性能基准测试。研究者可依托其明确的任务与分割元数据,进行跨模型的公平比较,从而推动电信领域人工智能方法的稳健发展。
解决学术问题
该数据集直面电信机器学习研究中数据来源不透明、版本混乱及数据泄漏等核心挑战。通过提供源优先、泄漏感知的方法论和完整的数据卡,它解决了学术研究中普遍存在的可复现性危机,使得实验得以在可控且可信的数据环境下进行。其严谨的许可与再分发决策机制,亦缓解了法律合规性争议,为学界树立了数据共享的新范式,显著提升了研究成果的可靠性与可比性。
实际应用
在实际应用中,TeleMLEBench Releases 为电信运营商和AI解决方案提供商提供了高质量的基准数据,用于开发和验证面向网络智能运维的算法。例如,在无线网络的信道建模、流量预测、异常检测以及能耗管理等领域,该数据集可助力企业模型从实验室走向生产环境,通过精确的元数据与数据卡,加速模型迭代与部署,最终提升网络服务质量和用户体验,降低运营成本。
数据集最近研究
最新研究方向
TeleMLEBench Releases作为电信领域机器学习数据集的权威发布平台,其最新研究方向聚焦于数据集的不可变版本化与可复现性保障。通过引入源清单、校验和、来源追踪及显式任务与分割元数据,该平台旨在解决电信ML研究中数据泄漏与可重复性危机。当前前沿趋势强调数据溯源与许可合规,推动跨机构数据共享的标准化,以支持大模型在无线网络优化、频谱管理等场景的稳健训练。此举对提升电信AI模型的泛化能力、降低偏见风险具有重要意义,为行业基准测试树立了新范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务