
ganglii/math_n10_s2
收藏官方服务:
资源简介:
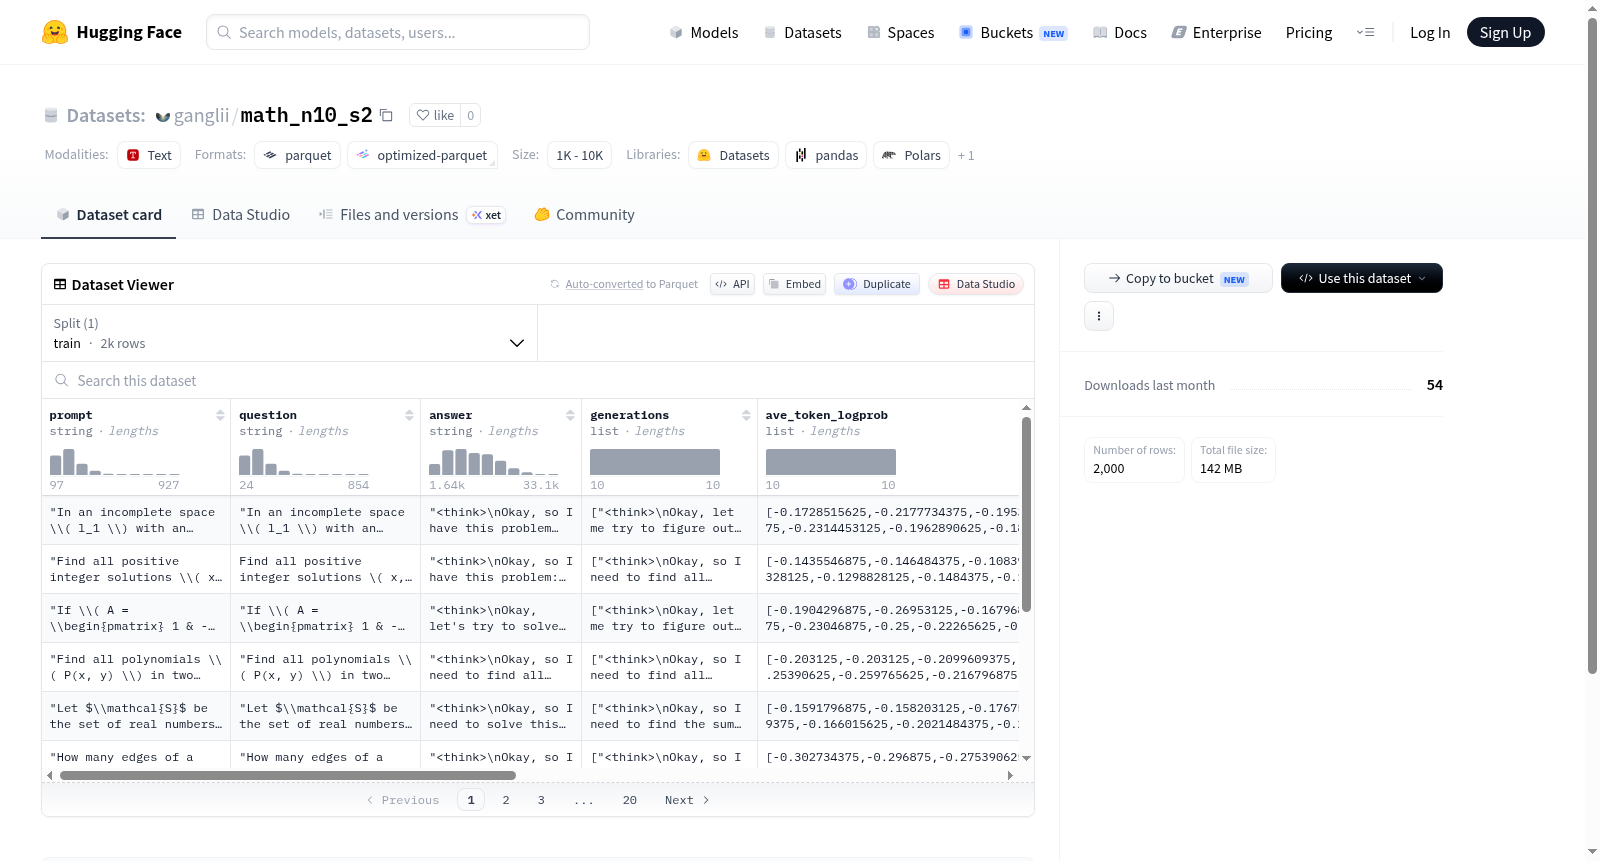
该数据集包含提示(prompt)、问题(question)、答案(answer)以及模型生成的多个回答(generations)及其对应的平均token对数概率(ave_token_logprob)、序列长度(seq_len)和序列对数概率(seq_logprob),同时还包括真实答案的生成结果(generations_gt)及其相关指标(ave_token_logprob_gt、seq_len_gt、seq_logprob_gt)。数据集共有2000个训练样本,用于评估语言模型生成质量。
This dataset contains fields such as prompt, question, answer, generations, along with average token log probability (ave_token_logprob), sequence length (seq_len), and sequence log probability (seq_logprob) for generated responses. It also includes ground truth generations (generations_gt) with corresponding metrics (ave_token_logprob_gt, seq_len_gt, seq_logprob_gt). The dataset has 2000 training samples and is used for evaluating the quality of language model outputs.
提供机构:
ganglii搜集汇总
数据集介绍
构建方式
该数据集基于数学问题求解场景构建,从大规模数学题库中精选2000个样本,每个样本包含原始问题(prompt)、具体提问(question)及标准答案(answer)。通过语言模型对每个问题生成多条候选回答(generations),并记录每条生成文本的逐词平均对数概率(ave_token_logprob)、序列长度(seq_len)及序列对数概率(seq_logprob),同时保留对应的标准答案生成结果(generations_gt)及其对数概率指标,形成结构化对比数据。
特点
数据集的核心特点在于多维度概率指标的引入,不仅提供了模型生成文本的原始输出,还同步计算了生成序列的逐词概率分布与整体似然值,使研究者能从生成质量与置信度双重视角分析模型行为。此外,标准答案及其概率指标的保留,为评估生成结果与真实解的一致性提供了量化基准,适用于模型校准与不确定性估计研究。
使用方法
该数据集可直接用于数学推理任务的模型评估与调优,通过对比模型生成文本与标准答案的概率指标,分析不同生成策略的置信度差异。研究者可基于prompt、question字段构建输入,利用generations及对应概率字段进行生成质量排序,或通过ave_token_logprob与seq_logprob计算生成序列的似然度量,进而开展模型校准、对比实验或鲁棒性分析。
背景与挑战
背景概述
在数学推理领域,构建高质量数据集以评估和提升大语言模型的数学能力已成为研究热点。math_n10_s2数据集由相关研究团队创建,旨在提供一个包含2000个训练样本的数学问题集合,每个样本涵盖题目、答案及模型生成的多种解答序列,并附带令牌级概率、序列长度与对数概率等细粒度信息。该数据集的问世,为研究者深入剖析模型在数学推理中的置信度、一致性及错误模式提供了标准化测试基准,推动了数学推理评估从简单答案正确性向生成过程可信度分析的范式转变。
当前挑战
该数据集面临的核心挑战在于如何有效利用其丰富的概率与生成信息,以应对大语言模型在数学推理中普遍存在的“虚假自信”问题,即模型虽给出正确答案但推理路径却存在逻辑谬误。此外,构建过程中需确保2000个样本覆盖多样的数学分支与难度层级,并生成准确反映模型不确定性的概率分布,这对数据质量与标注一致性提出了严苛要求,同时需平衡计算开销与样本代表性之间的矛盾。
常用场景
经典使用场景
在数学推理与自然语言处理的交叉领域,math_n10_s2数据集为评估和提升大型语言模型的数学问题求解能力提供了重要基准。该数据集包含2000个训练样本,每个样本由提示词、数学问题、标准答案及模型生成的多个候选回答构成,同时记录了生成序列的对数概率、序列长度等细粒度统计信息。研究者常利用这些丰富的元数据,结合自回归语言模型的概率输出特性,设计监督微调或强化学习策略,以引导模型生成更准确、更符合逻辑链的数学解答。
衍生相关工作
基于math_n10_s2数据集,学术界已衍生出多项重要工作。例如,研究者利用其中的概率信息设计对比学习框架,有效提升了模型在数学应用题上的泛化能力;另有工作通过分析生成序列的日志概率分布,提出了新的置信度校准方法,显著降低了模型对低质量解答的过度自信问题。此外,该数据集还被用作少样本学习场景下的评估基准,促进了数学推理领域提示工程与链式思维引导技术的研究进展。
数据集最近研究
最新研究方向
当前,数学推理能力作为衡量大语言模型高阶智能的关键维度,正成为学界竞相突破的前沿高地。math_n10_s2数据集聚焦于数学问题的生成与评估,通过精心设计的2000条训练样本,每一条都配备了模型生成的多条候选回答及其对数概率、序列长度等细粒度统计信息,为探究数学推理中的概率分布、置信度校准与错误模式开辟了全新航道。结合近期大模型在数学竞赛与科学推理中表现出的惊人潜力,该数据集不仅为验证模型推理一致性与泛化边界提供了标准化测试场,更可能催化链式思维增强、自我纠错机制等热点方法的迭代,推动机器数学智能从简单匹配走向真正的逻辑建构。这一数据资产的公开,为构建更鲁棒、更可解释的数学推理系统奠定了基石,其影响将辐射至自动定理证明、智能教育等紧贴国计民生的应用领域。
以上内容由遇见数据集搜集并总结生成


