
AI4Food
收藏数据链接:
官方服务:
资源简介:
社区共建的餐厅数据集合(数据仓库)——一份结构化、可校验、可检索的餐厅/饭店数据集。
Community-curated restaurant dataset (data warehouse) — a structured, verifiable, and retrievable dataset of restaurants and catering establishments.
创建时间:
2026-07-07
原始信息汇总
数据集概述
AI4Food 是一个社区共建的、结构化的全球餐厅数据集合(数据仓库),旨在作为美食推荐网站与 AI 助手的单一数据源。
数据组织与格式
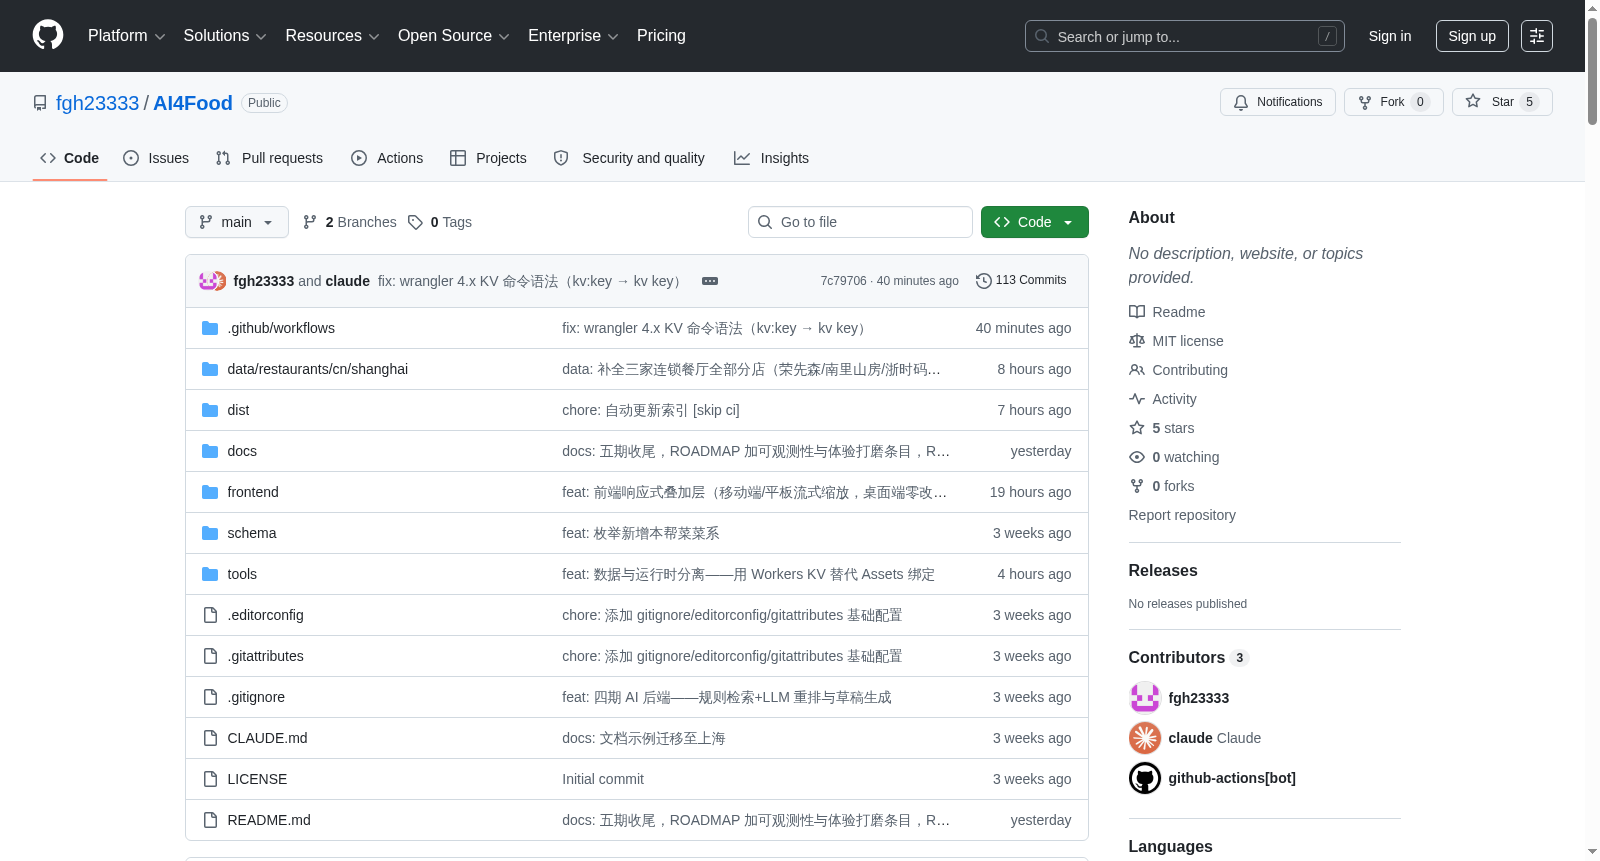
- 存储方式:每家餐厅存储为一个独立的 Markdown 文件,文件头部使用 YAML frontmatter 存储结构化字段,正文部分为自由文本的探店描述。
- 文件路径:
data/restaurants/{country}/{city}/{slug}.md - 文件命名:
<店名拼音>-<分店>.md,例如laoshanghai-nanjingroad.md。
数据字段规范
字段定义在 schema/ 目录下,分为三个等级:
| 分级 | 字段 | 说明 |
|---|---|---|
| 必填 | id, name, city, country, cuisine, price_level, status |
缺失则校验失败 |
| 推荐 | address, latitude+longitude, tags, updated_at |
缺失仅警告 |
| 可选 | rating, recommendations, notes, photos, phone, opening_hours |
自由填写 |
- 数据校验:通过 TypeScript 工具链自动执行,CI 会校验必填字段、枚举值和 id 唯一性。
贡献方式
- 交互式脚手架:提供自动化工具生成新餐厅文件,引导用户填写信息。
- 手动编写:复制模板文件
data/restaurants/cn/shanghai/_template.md并修改 frontmatter。 - 提交:通过 Pull Request (PR) 提交,标题格式为
data: 新增<城市><店名>。
技术架构
- 后端只读 API:基于 Hono 框架,部署于 Cloudflare Workers,提供餐厅列表、详情和元数据的查询接口。
- 线上地址:
https://ai4food.635262140.xyz - 端点包括:
GET /api/restaurants(支持筛选和分页)、GET /api/restaurants/:id、GET /api/meta。
- 线上地址:
- 前端 SPA:基于 Vue 3 构建,部署于 GitHub Pages,提供餐厅列表、搜索和详情展示。
- 线上地址:
https://fgh23333.github.io/AI4Food/
- 线上地址:
- AI 能力:集成 LLM,提供智能问答推荐和 AI 辅助贡献(草稿生成)功能。
数据规模与用途
- 数据以 Markdown + YAML frontmatter 格式存储,未来可驱动美食推荐网站与 AI 助手。
- 该仓库使用 MIT 许可证。
搜集汇总
数据集介绍
构建方式
AI4Food 数据集以社区共建为核心理念,采用 Markdown 与 YAML frontmatter 相结合的文件格式存储餐厅信息。每位贡献者可在 data/restaurants/{country}/{city}/ 目录下创建独立的 Markdown 文件,其中 frontmatter 部分严格遵循 schema/ 目录下统一定义的字段规范,涵盖餐厅名称、城市、菜系、价格等级、状态等必填与推荐字段,正文部分则用于书写自由格式的探店描述。项目通过 TypeScript 工具链提供交互式脚手架(pnpm new)辅助文件生成,并利用 pnpm validate 命令在本地完成数据校验,确保每条记录满足 id 唯一性、枚举值合法性等约束。贡献完成后,用户提交 PR 即可将数据合并至主仓库。
特点
该数据集最突出的特点在于其人机友好的双重表达结构与自动化质量保障体系。每个餐厅文件既便于人类阅读和编辑,又能被机器高效解析与索引。schema 目录作为单一事实来源,统一了字段定义,使校验器、文档乃至前端应用都能从中派生,避免了信息散落与不一致。CI 流水线在合并前自动执行必填字段校验、id 唯一性检查与路径一致性验证,错误会阻塞合并,警告则以温和方式提示,从而守住数据质量门槛。此外,数据集的低门槛参与机制尤为重要,即便只掌握基础的 Markdown 写作技能,也能轻松贡献,TypeScript 工具链在后台透明运行,无需贡献者深入理解。
使用方法
数据集的使用方式灵活多样,覆盖从数据消费到智能应用的多个层次。最直接的方式是通过前端 Vue 3 单页应用(SPA)访问,该应用读取 CI 自动生成的 dist/index.json 索引文件,提供餐厅列表展示、筛选、搜索、连锁品牌合并及详情浏览等功能,并已部署至 GitHub Pages。对于开发者而言,可调用基于 Hono 框架构建的只读 REST API,通过 /api/restaurants 端点按城市、菜系、价格等级等参数筛选查询,或利用 /api/restaurants/:id 获取单条详情,数据源自同一索引文件。更进一步,数据集接入了基于 Cloudflare Workers AI 的智能问答功能,用户可通过 POST /api/ai/recommend 提交自然语言问题,获取推荐结果;亦可使用 POST /api/ai/draft 接口,由 AI 辅助生成符合 schema 的 frontmatter 草稿,经人工核对后贡献入库。
背景与挑战
背景概述
AI4Food数据集由开发者fgh23333于2025年创建,旨在构建一个社区驱动的、结构化、可校验且可检索的全球餐厅信息数据仓库。该项目由单一维护者发起,核心研究问题是如何通过人机友好的Markdown+YAML格式,辅以TypeScript工具链自动校验,实现众包美食数据的标准化与质量控制。数据集涵盖餐厅名称、位置、菜系、价格等级等字段,并通过CI流程确保数据完整性。作为美食领域的结构化数据源,AI4Food不仅支撑了自有Vue前端与Hono API,更为基于LLM的智能推荐与辅助贡献提供了可靠基础,其开源与共建模式在美食数据生态中开创了透明、可复用的新范式。
当前挑战
AI4Food面临的核心挑战包括:1)在领域问题层面,如何从零构建一个覆盖全球、多语种、文化多样的餐厅数据集,解决美食信息孤岛与商业平台数据封闭的困境,同时确保数据贡献的持续性与覆盖面。2)在构建过程中,需设计易于贡献者理解的数据schema与校验规则,降低非技术用户的参与门槛;自动校验需处理枚举值边界、id唯一性及多城市文件路径一致性等细节;此外,AI辅助贡献的引入需解决反幻觉问题,确保LLM输出严格基于已有数据而不编造餐厅,同时兼顾隐私(如电话、坐标)与数据时效性管理。
常用场景
经典使用场景
在美食推荐与数据工程交叉领域,AI4Food 数据集以其结构化的餐厅信息存储范式,成为构建智能美食搜索与推荐系统的理想数据基底。研究者可借助其统一的 YAML frontmatter 字段(如菜系、价位、评分及经纬度坐标),快速搭建基于规则或机器学习的协同过滤推荐模型。该数据集尤为适用于多模态美食应用的开发场景,例如结合 Markdown 正文的语义探索与结构化标签的精确检索,从而在泛餐饮数据科学、个性化美食地图构建及城市饮食文化分析等方向上发挥关键作用。
实际应用
在实际产业应用中,AI4Food 数据集凭借其可校验、易扩展的特性,已直接赋能多个面向大众的美食服务场景。其前端 SPA 已实现餐厅列表渲染、多维度筛选(城市、菜系、价位)与连锁品牌合并,可作为轻量级美食导航网站的即时数据来源。更值得一提的是,依托后端的 Hono API 与 Workers AI 能力,该数据集驱动了智能问答推荐与 AI 辅助贡献草稿两大实用功能,用户可自然语言提问「上海有什么日料推荐」,系统则严格基于数据集内实体返回精准候选,有效减少了传统推荐中的幻觉现象,展现了从数据到最终用户服务的完整链路价值。
衍生相关工作
AI4Food 数据集特有的结构设计催生了一系列具有启发意义的衍生工作。在工具链层面,基于 TypeScript 的校验器与索引生成器被复用于其他城市开源数据项目,形成了「单一事实来源」的数据治理范式。在 AI 能力层面,其「先规则检索再 LLM 重排」的反幻觉推荐架构,为数据集限定下的检索增强生成提供了可落地的参考实现,相关设计文档已被多个社区饮食项目引用。此外,前端 SPA 与 Cloudflare Workers 的集成部署方案,以及全链路 trace 的可观测性体系,共同构成了一个从数据采集、校验、存储到服务化与监控的完整开源技术栈模板。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


