
遇见数据集

stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.1_g6_run2_metrics

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

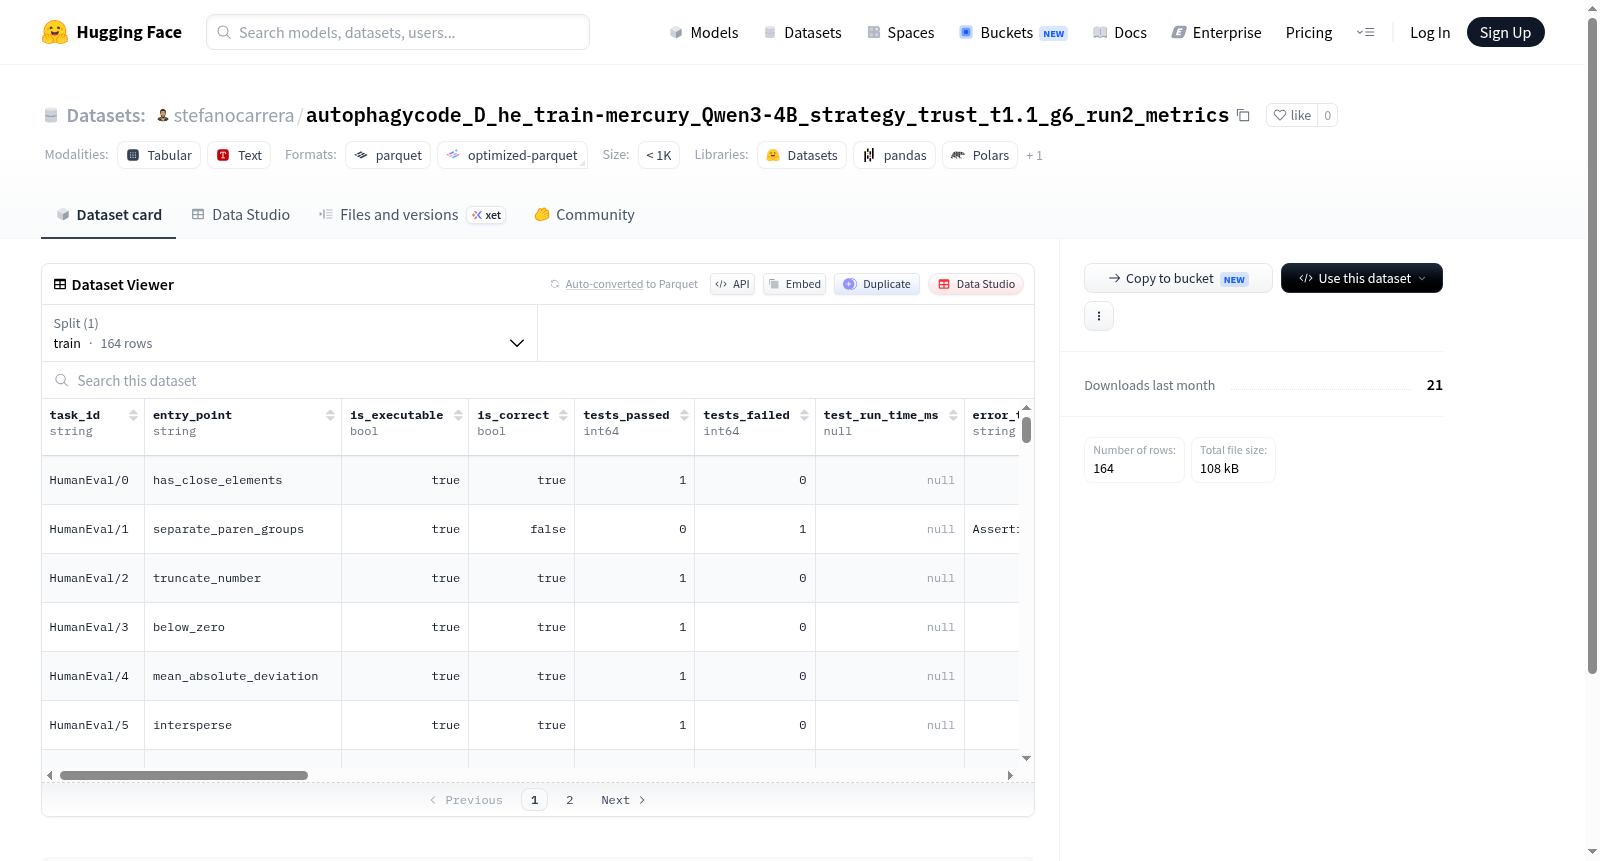
该数据集包含代码质量与复杂度相关的元数据,每条记录包含任务ID、入口点、是否可执行、是否正确、通过的测试数、失败的测试数、测试运行时间、错误类型、哈斯泰德度量(词汇量、长度、体积、难度、努力、时间)、圈复杂度、可维护性指数、代码行数、源代码行数、注释百分比、词类型比例(TTR)、令牌字典、香农熵、预测熵、定义的函数数、入口点是否重复等特征。数据集仅包含一个训练集,共164个样本,可能用于代码质量评估、复杂度分析或代码生成模型性能分析。

This dataset contains metadata related to code quality and complexity. Each record includes task ID, entry point, whether it is executable, whether it is correct, number of tests passed, number of tests failed, test run time, error type, Halstead metrics (vocabulary, length, volume, difficulty, effort, time), cyclomatic complexity, maintainability index, lines of code (loc), source lines of code (sloc), comment percentage, token type ratio (TTR), token dictionary, Shannon entropy, predictive entropy, number of functions defined, and whether the entry point is repeated. The dataset consists of a single training split with 164 samples, likely used for code quality assessment, complexity analysis, or evaluating code generation model performance.
提供机构:
stefanocarrera
搜集汇总
数据集介绍
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.1_g6_run2_metrics 数据集图片
构建方式
该数据集名为autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.1_g6_run2_metrics,基于代码智能领域的自动化评估任务构建。其构建过程以Qwen3-4B模型在特定策略(trust策略,温度参数t1.1,生成轮次g6)下生成的代码输出为核心,聚焦于“汞(mercury)”编程问题集的训练子集。数据集收录了164条样本,每条样本包含任务标识符(task_id)、入口函数名(entry_point)、可执行性标志(is_executable)、正确性判断(is_correct)以及测试通过数与失败数等执行结果指标。此外,通过引入Halstead复杂度系列指标(如词汇量、长度、体积、难度、努力度、时间)、圈复杂度(cyclomatic_complexity)、可维护性指数(maintainability_index)、代码行数(loc与sloc)、注释占比(comment_percentage)、文本重复率(TTR)、词元字典(token_dict)、香农熵(shannon_entropy)以及预测熵系列指标(均值与最大值)等静态度量,对生成的代码进行多维度的语义与结构剖析。数据集还记录了模型预测的入口点重复情况(entry_point_repeated),从而形成一套融合执行反馈与静态分析的综合性评估资源。
使用方法
该数据集的使用方法较为灵活,主要面向代码生成模型的评估与诊断场景。用户可直接通过HuggingFace Datasets库加载数据集,利用其预设的'train'划分进行批量化分析。每个样本的task_id和entry_point字段可用于精准定位特定编程任务与对应函数入口,而is_executable、is_correct以及tests_passed、tests_failed字段则提供了直接的执行结果标签,适用于监督学习中的错误分类或回归预测任务。对于软件质量分析,研究者可基于Halstead复杂度、圈复杂度、可维护性指数等特征构建统计模型,评估生成代码的工程合理性。此外,token_dict、shannon_entropy及mean_predictive_entropy等特征为探索语言模型的生成置信度与代码复杂度之间的关系提供了便利。用户也可自定义分析流程,例如利用comment_percentage和sloc字段研究注释与有效代码的比例,或通过TTR评估代码词汇的多样性。建议在使用时结合具体研究目标进行特征组合与预处理,以充分发挥该数据集的诊断价值。
背景与挑战
背景概述
该数据集由autophagycode团队创建,旨在评估大语言模型在代码生成任务中的表现,特别是针对Qwen3-4B模型在信任策略下的微调效果。数据集创建于2025年,核心研究问题聚焦于如何通过自动化度量指标(如圈复杂度、Halstead复杂度、香农熵等)量化模型生成代码的可靠性与可维护性。该数据集整合了执行测试结果与代码度量特征,为理解模型在编程任务中的行为提供了多维度的评估框架,对代码智能领域的研究具有重要的参考价值。
当前挑战
数据集所解决的领域问题在于代码生成模型的评估往往仅依赖于功能正确性(如通过测试数量),缺乏对代码质量、复杂性及可理解性的综合考量。构建过程中面临的挑战包括:需从164个训练样本中提取19个不同类型的度量特征,涵盖执行结果、静态分析和熵值计算,同时确保特征间的非冗余性。此外,手动标注错误类型(error_type)和识别重复入口点(entry_point_repeated)的高成本,以及跨平台测试运行时间(test_run_time_ms)缺失值的处理,均对数据集构建的完整性和一致性提出了严峻考验。
常用场景
经典使用场景
在程序合成与代码生成领域,该数据集为评估大语言模型在自动编程任务中的表现提供了精细化的度量体系。通过记录任务标识、入口点、执行正确性、测试通过率及运行时长等核心指标,研究者能够系统性地衡量模型生成代码的功能正确性与执行效率。结合Halstead复杂度、圈复杂度、可维护性指数及代码行数等软件工程度量,该数据集支持对生成代码的结构复杂度与可读性展开深入剖析,为优化代码质量提供量化依据。
解决学术问题
该数据集解决了现有代码生成基准中缺乏多维度质量评估的问题。传统评估仅关注功能正确性,而此数据集引入代码复杂度、可维护性及信息熵等指标,使研究者能够探究模型生成代码的可理解性与工程实践价值。通过对错误类型、测试失败模式及令牌分布的统计分析,该数据集助力揭示大语言模型在代码生成中的常见缺陷与偏差,推动了从单一正确性向综合质量评估的研究范式转变。
实际应用
在实际软件开发场景中,该数据集可用于自动代码审查与质量保证系统的构建。基于数据集中的复杂度与可维护性度量,开发团队能够自动化筛选出结构臃肿、难以维护的生成代码,并触发重构建议。该数据集还支持对代码注释率、词汇多样性等信息进行挖掘,辅助评估代码文档的完善程度,从而提升团队协作效率与软件长期可维护性。
数据集最近研究
最新研究方向
该数据集聚焦于代码生成模型的性能评估与鲁棒性分析,结合了代码复杂度指标(如Halstead度量、圈复杂度、维护性指数)与预测熵值,为大型语言模型在自动化编程任务中的可信度与可解释性研究提供了关键支撑。前沿方向包括利用该数据集探索模型在不同代码结构下的生成正确率与失败模式,以及通过香农熵与最大预测熵等指标量化模型不确定性,推动代码智能领域向更可靠、更透明的方向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

