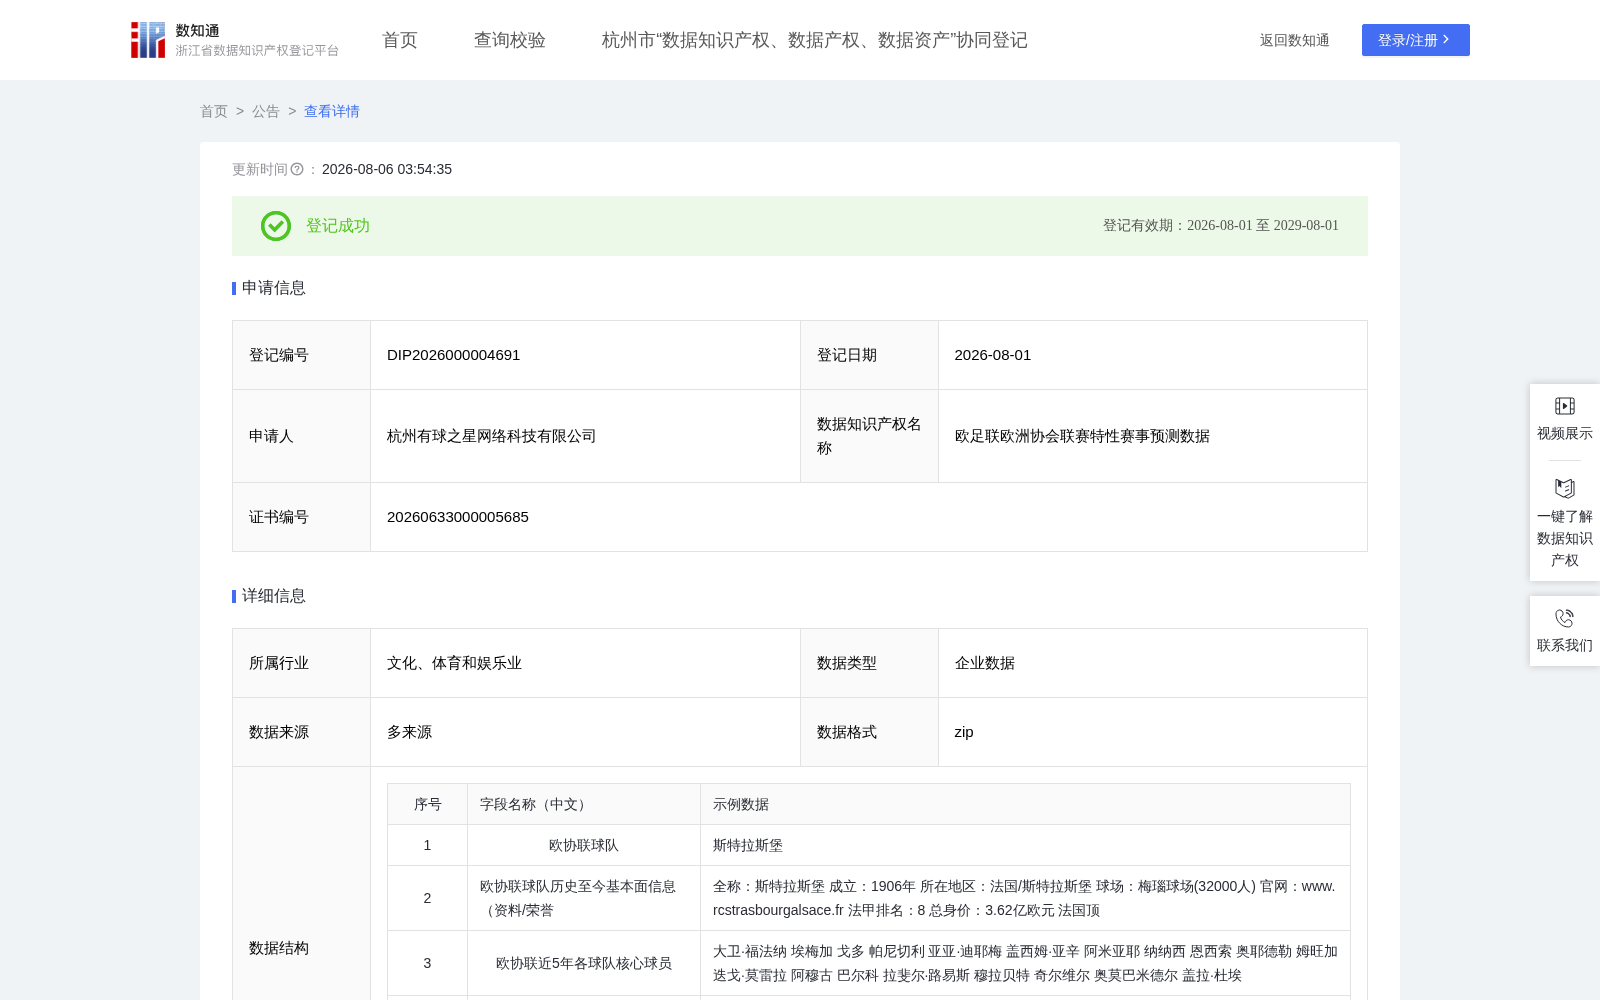
欧足联欧洲协会联赛特性赛事预测数据
收藏资源简介:
本数据知识产权专为欧足联欧洲协会联赛构建,旨在解决该赛事因参赛球队覆盖面广、历史数据稀疏、竞技波动性大所带来的精准分析难题。通过采集纳米科技底层数据(10.76%)、媒体动态数据(28.18%)及官方权威数据(61.06%),对即将进行的欧协联赛事进行走势分析预测。核心应用紧扣三大要素:赛事重视程度(量化中小俱乐部及五大联赛球队对该项锦标的主观战意)、球星个人能力(追踪次级联赛核心球员在高端局中的关键表现)、阵容实力要素(综合评估球队多线作战下的轮换深度与即战力)。分析结果合规复用至体育资讯精准推送、俱乐部球探战术研判及竞猜辅助决策等第三方场景,解决了欧协联数据分散、预测逻辑通用性差的市场痛点,具有显著的实用价值与独创性。本数据产品基于多源异构数据融合与差异化特征工程构建。算法整体逻辑分为四层: 数据清洗与对齐层:对授权的纳米科技数据(底层比赛日志)、媒体采集数据(伤停、赛前发布会信息)及官方数据(球员注册、财务公平数据)进行时空对齐。针对欧协联数据特点,采用KNN算法对缺失的身价与状态值进行最近邻填充,确保数据完整性。 特征工程层:根据占比27.22%的市场洞察数据,重点提取欧协联特有的指数变化特征,并引入“跨联赛实力映射”因子,将不同级别联赛(如荷甲vs希腊超)的球员数据标准化至统一度量空间。核心训练区分(占比44.03%)构建了复合特征: 重视程度指数:基于球队上一轮联赛轮换幅度、本场门票收入预期、俱乐部历史荣誉缺口加权计算; 球星爆发力:利用球员近5场的高阶数据(关键传球、过人成功率、对抗成功率)构建稳定性系数; 阵容虚实:综合多线作战下的预期轮换概率与替补深度值。 模型训练与调优层:基础数据(8.24%)与媒体数据(20.51%)构成基线模型,采用XGBoost作为基学习器。针对欧协联数据量较少、方差大的特点,将max_depth设置为6(相较欧冠模型调低),learning_rate调至0.05,并增加subsample(样本采样率)至0.8,以防止过拟合。将市场洞察与核心训练区分的特征向量与基线模型进行Stacking集成,次级学习器采用逻辑回归。 预测与输出层:模型输出胜平负概率及预期进球数,并同步计算预测置信度(基于模型在各特征空间上的密度分布)。所有预测结果附带数据来源版本号与特征快照,确保分析结果的可复核性与对外合规复用的透明度。