遇见数据集

AnyMatch (Any-syn)

收藏
github2026-07-28 更新2026-07-29 收录
数据链接:
官方服务:

资源简介:

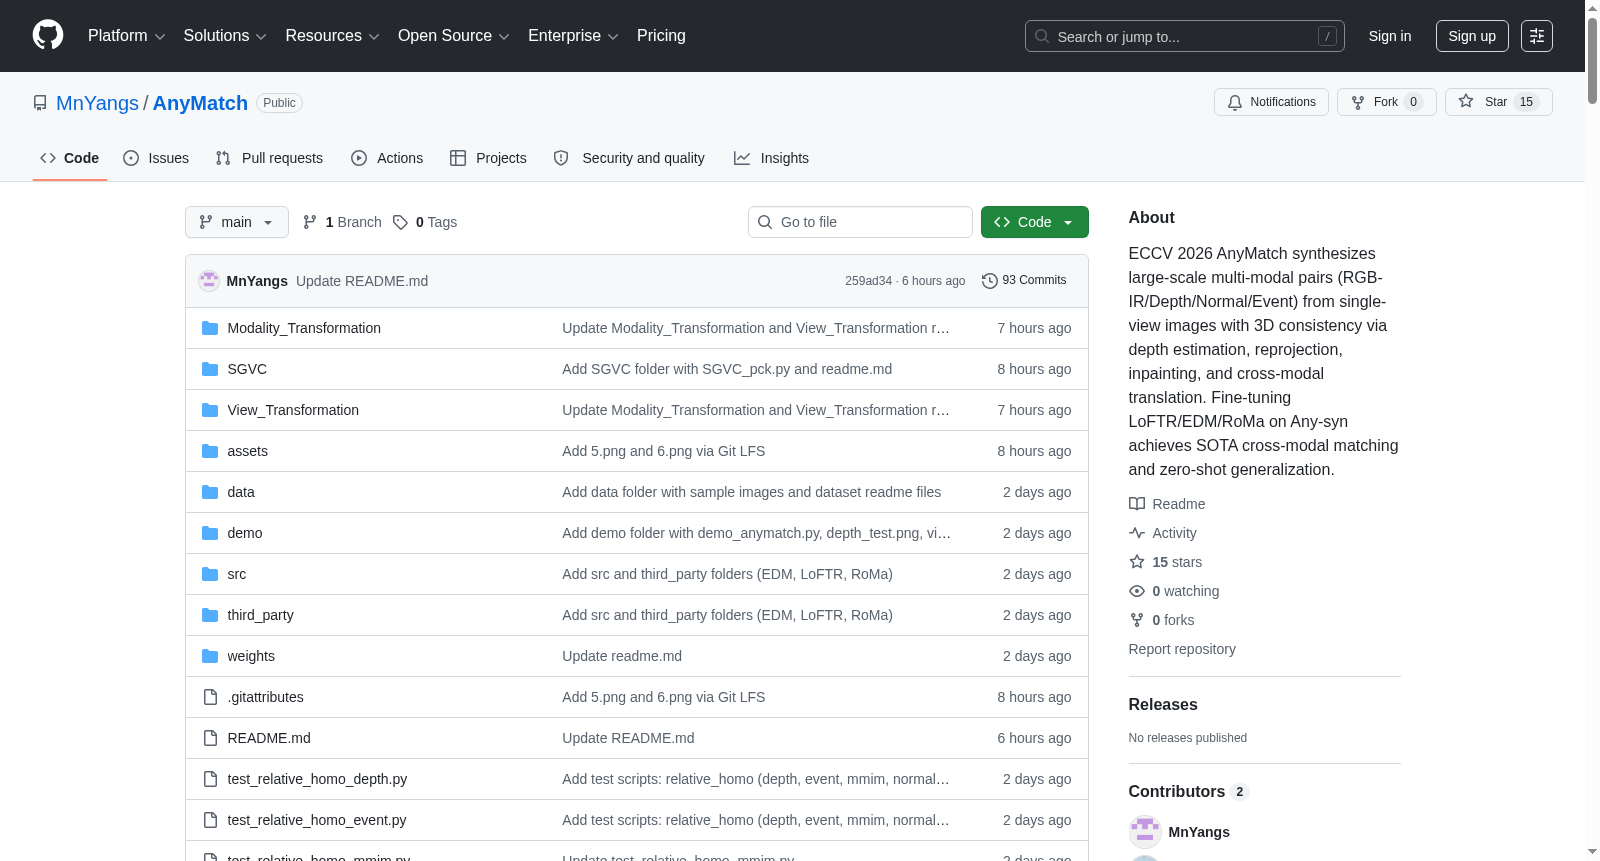
AnyMatch 是一个从单视角图像合成大规模多模态对(RGB-IR/深度/法线/事件)的数据集,通过深度估计、重投影、修复和跨模态转换实现3D一致性。该数据集用于增强通用多模态图像匹配,通过在Any-syn上微调LoFTR/EDM/RoMa等模型,实现了最先进的跨模态匹配和零样本泛化。

AnyMatch is a dataset that synthesizes large-scale multimodal pairs (RGB-IR/Depth/Normal/Event) from single-view images, achieving 3D consistency via depth estimation, reprojection, inpainting and cross-modal translation. This dataset is designed to enhance general-purpose multimodal image matching, and by fine-tuning models such as LoFTR, EDM and RoMa on Any-syn, it achieves state-of-the-art cross-modal matching and zero-shot generalization.

创建时间:
2026-07-02
原始信息汇总

AnyMatch 数据集详情

概述

AnyMatch 是 ECCV 2026 收录的工作,旨在通过大规模单视图图像增强通用多模态图像匹配能力。其核心是通过数据引擎(AnyMatch Data Engine),从单视图图像合成具有3D一致性的多模态图像对(RGB-IR/Depth/Normal/Event),用于训练通用多模态匹配模型。

数据生成流程

AnyMatch 数据引擎包含三大模块:

  • 视图变换模块(View Transformation):通过单目深度估计将单张2D图像提升至3D空间,再重投影至新视角并进行修复,生成几何一致的多视图图像对,无需依赖SfM-MVS。
  • 模态变换模块(Modality Transformation):将原始可见光图像转换为多种目标模态(红外、深度、法线、事件),使用专用跨模态翻译模型(如RGB-to-IR扩散模型、单目深度/法线估计器、基于运动的事件合成),生成模拟真实传感器差异的多模态图像对。
  • SGCV模块:质量控制步骤,利用预训练的密集匹配模型(RoMa)计算渲染对应与真实几何投影之间的关键点正确百分比(PCK),筛选高质量图像对。

单视图数据库(Single-View Database)

  • 来源:来自公开数据集 GLDv2 和 SA-1B 的大规模真实世界RGB图像。
  • 预处理:所有图像统一调整大小并中心裁剪至512×512分辨率。
  • 用途:作为基础输入库,替代昂贵的多视图或多传感器采集,用于后续视图变换和模态变换。
  • 训练子集基于 GLDv2,测试子集基于 SA-1B。

评估数据集(Real Multimodal Scenarios)

AnyMatch 使用多个真实多模态场景数据集进行评估:

  • METU_VisTIR:可见光-红外图像对
  • MMIM:包含遥感、医学、计算机视觉子集的多模态图像匹配数据集
  • RGB-Depth:RGB-深度图像对
  • RGB-EVENT:RGB-事件图像对
  • RGB-Normal:RGB-法线图像对

数据组织结构

推荐的数据目录结构:

data/ ├── test_data_preparation.sh ├── Any-syn-test/ ├── Single-View-Data/ ├── RealDataset/ ├── METU_VisTIR/ │ ├── index/ │ ├── cloudy/ │ └── sunny/ ├── MMIM/ │ ├── RemoteSensing/ │ ├── Medical/ │ └── ComputerVision/ ├── RGB-Depth/ │ └── val/ ├── RGB-EVENT/ │ └── DSEC/ └── RGB-Normal/ └── val/

支持的多模态匹配方法

AnyMatch 支持以下方法在多模态图像匹配基准上进行评估:

  • LoFTR
  • EDM
  • RoMa

相关资源

搜集汇总
数据集介绍
AnyMatch (Any-syn) 数据集图片
构建方式
AnyMatch (Any-syn) 数据集的构建根植于一个创新的数据引擎,旨在解决多模态图像匹配中大规模标注数据匮乏的难题。该引擎以大量单视图RGB图像为起点,这些图像来自公开数据集GLDv2和SA-1B,并统一缩放裁剪至512×512分辨率。首先,通过视角变换模块,利用单目深度估计将单张2D图像提升至3D空间,再通过重投影与修补技术生成具有几何一致性的多视图图像对。随后,模态变换模块采用专用的跨模态翻译模型,如RGB到红外、深度、法线及事件的扩散模型或估计器,将可见光图像转化为多种目标模态,从而构建出涵盖红外-可见光、深度-可见光等类型的多样化多模态图像对。最后,一个名为SGCV的质量控制模块基于预训练的密集匹配模型计算关键点正确率,筛选出高几何一致性的样本,最终形成规模宏大、场景丰富且具有三维一致性的多模态训练数据集。
特点
Any-syn数据集的核心特点在于其利用大规模单视图图像合成多模态数据,显著降低了数据采集成本,并实现了卓越的泛化能力。该数据集覆盖了红外、深度、法线和事件等多种模态,模拟了真实世界中不同的传感器差异,为跨模态图像匹配研究提供了丰富的素材。通过精密的几何与模态变换流水线,生成的图像对既保证了像素级的三维几何一致性,又具备逼真的跨模态外观变换。此外,Any-syn的训练子集和测试子集分别源自GLDv2和SA-1B,确保了场景的广泛性与多样性。实验表明,在此数据集上微调后的匹配模型,如LoFTR、EDM和RoMa,不仅在同类模态上取得最先进性能,更在未见过的真实多模态场景中展现出强大的零样本泛化能力,这标志着其在推动通用多模态图像匹配发展上的重要价值。
使用方法
使用AnyMatch数据集进行模型微调或评估时,需首先按照推荐结构组织数据,确保单视图数据库、合成测试集及真实多模态基准数据集存放于正确的路径下。用户可以通过运行View_Transformation和Modality_Transformation模块下的Python脚本,根据自己的领域需求自主生成定制化的多模态匹配数据。对于预训练模型的评估,项目提供了针对不同模态的测试脚本,如用于红外-可见光匹配的test_relative_pose_infrared.py,以及用于Any-syn合成数据集的test_relative_pose_Any_syn.py,用户可通过--modality参数选择特定模态进行测试。此外,还可运行demo_anymatch.py快速体验模型效果。所有测试默认使用预训练权重,并支持通过--ckpt参数加载自定义模型。详细的配置说明和代码示例均已开源在GitHub仓库中,便于研究者复现与拓展。
背景与挑战
背景概述
多模态图像匹配是计算机视觉领域的一项基础性任务,旨在建立来自不同传感器或成像模态(如可见光、红外、深度、法向和事件相机)图像之间的像素级对应关系。然而,现有方法大多依赖SfM-MVS或真实多传感器采集来获取训练数据,成本高昂且难以覆盖多样化的模态组合。为此,武汉大学电子信息和机器人学院的杨萌、李子卓、唐林峰、樊帆、马佳义等研究人员于2026年提出了AnyMatch及其配套数据集Any-syn。该数据集的核心创新在于,利用单视图RGB图像,通过深度估计、重投影、修复和跨模态翻译等模块,以3D一致性的方式大规模合成RGB-IR、RGB-深度、RGB-法向和RGB-事件等多模态图像对,从而突破了传统数据获取的瓶颈。AnyMatch在ECCV 2026发表后,显著推动了通用多模态匹配模型的发展,其在LoFTR、EDM和RoMa等骨干网络上微调后,在跨模态匹配和零样本泛化任务中均达到了最先进的性能,为多模态视觉感知研究提供了高效、可扩展的数据基石。
当前挑战
数据集的挑战主要体现在两大层面。在领域问题层面,多模态图像匹配长期受困于不同模态间巨大的外观差异和几何不一致性,传统方法难以学习到跨模态的鲁棒特征对应关系,且缺乏大规模、多场景、模态组合丰富的训练数据来支撑通用模型的训练。在数据集构建层面,Any-syn面临的核心挑战在于如何从单视图图像出发,保证生成的多视图、多模态数据具有严格的3D几何一致性,这需要深度估计、视角变换和跨模态翻译等模块的精密协同。此外,生成后的数据需要经过有效的质量控制,即SGCV模块通过计算PCK指标筛选高置信度的图像对,避免因深度估计算法误差或修复痕迹导致的伪影影响模型训练。同时,不同模态的翻译模型(如RGB-to-IR扩散模型)本身存在领域偏移,如何确保合成数据与真实多模态场景的分布对齐,以及在训练和测试子集(分别来自GLDv2和SA-1B)中保持场景多样性与平衡性,均是构建过程中必须克服的难题。
常用场景
经典使用场景
AnyMatch数据集(Any-syn)的经典使用场景是作为大规模多模态图像匹配的统一训练与评估基准。通过从单视图RGB图像出发,借助深度估计、重投影、修复与跨模态翻译模块,系统性地合成具备三维几何一致性的多模态图像对(如RGB-深度、RGB-红外、RGB-法向图、RGB-事件流),从而为跨模态特征匹配模型的训练与测试提供海量、多样且标注精确的数据支撑。该数据集在相对位姿估计、单应性矩阵求解等经典几何视觉任务中扮演关键角色,特别适用于验证模型在不同传感器模态间的泛化能力与鲁棒性。
衍生相关工作
基于AnyMatch数据集的衍生工作主要体现在以LoFTR、EDM及RoMa为代表的通用密集匹配网络的跨模态微调与性能提升。其中,AnyMatch数据引擎本身即是一系列技术的集成与创新,其包含的视图变换与模态变换模块为后续研究提供了可复用的数据生产流水线。相关工作进一步探索了利用合成数据预训练模型并在真实多模态基准上实现零样本泛化的范式。此外,该数据集催生了针对不同传感器模态特性(如事件相机的异步特性、红外图像的热纹理特徵)的新型匹配损失函数设计,推动多模态匹配从单一实验室环境走向真实复杂场景的迁移学习研究。
数据集最近研究
最新研究方向
AnyMatch及其配套的Any-syn数据集代表了多模态图像匹配领域的一项前沿突破,其核心创新在于利用大规模单视图图像通过深度估计、重投影与跨模态翻译生成具有3D一致性的多模态配对数据(如RGB-红外/深度/法向/事件),有效克服了传统方法对多视角或多传感器采集数据的依赖。该研究方向与近期计算机视觉领域对通用特征匹配与零样本泛化能力的热切关注紧密相连,通过微调LoFTR、EDM、RoMa等主流模型,Any-syn在跨模态匹配上实现了当前最优性能。此举不仅显著降低了数据获取成本与门槛,更为无人系统、遥感分析及增强现实等依赖多模态传感器融合的应用场景提供了高质量的训练基石,对推动视觉感知系统的普适性与鲁棒性具有里程碑式的影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务