mx-vehicle-catalog
收藏资源简介:
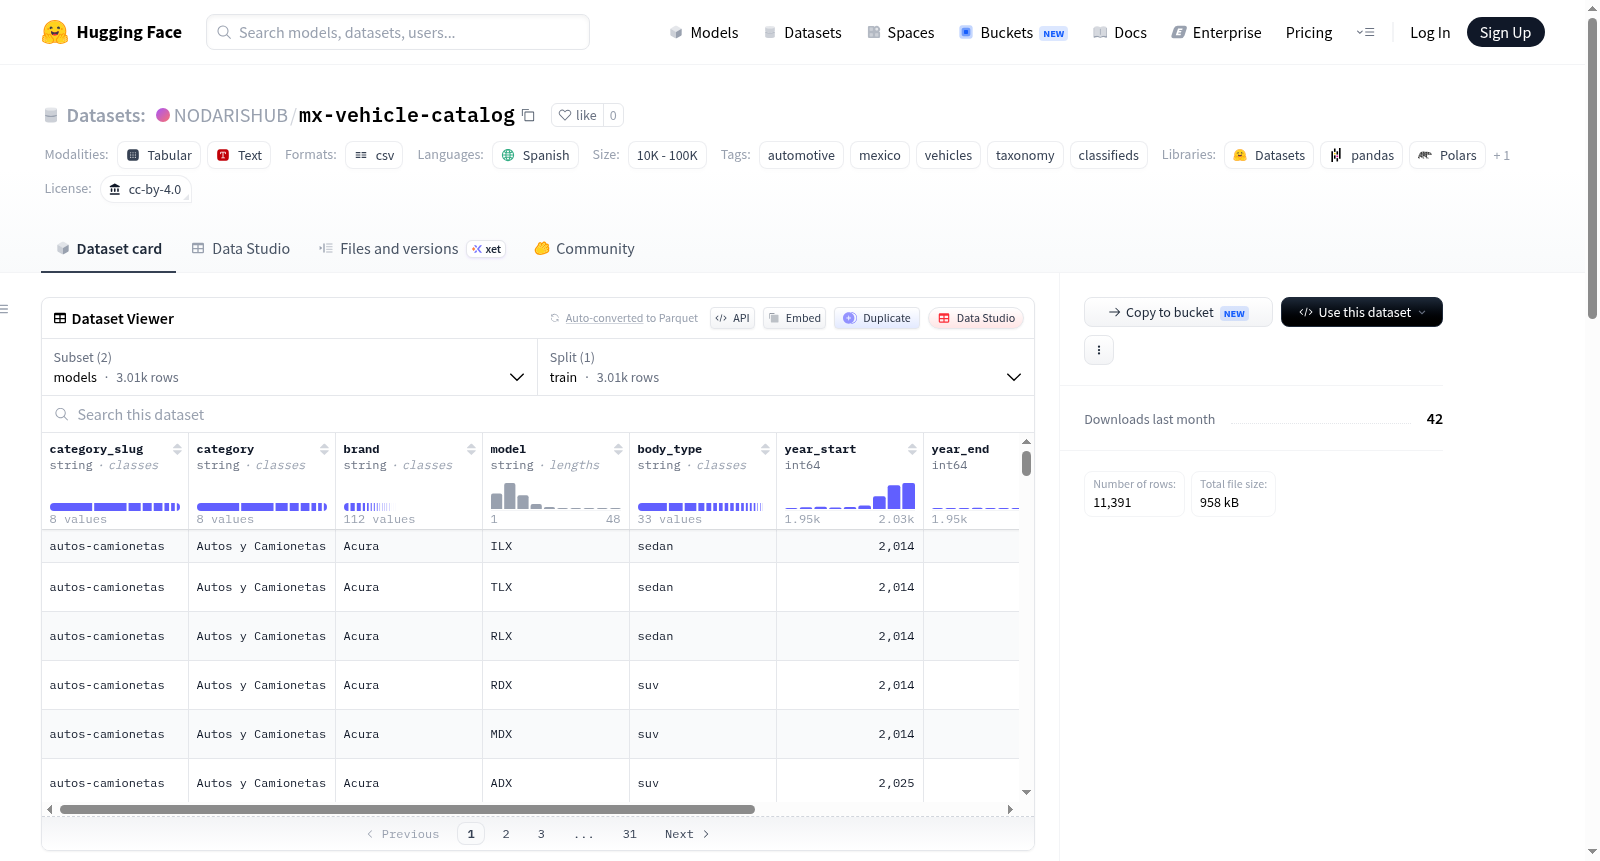
Mexico Vehicle Catalog Reference 数据集是一个结构化参考分类法,涵盖了在墨西哥市场销售或常见的车辆信息。该数据集包含112个品牌、3,011个车型条目和8,380个命名版本/配置,分布在8个顶级车辆类别中:Autos y Camionetas(汽车和皮卡)、Motos(摩托车)、Vehículos Pesados(重型车辆)、Camiones(卡车)、Otros Vehículos(其他车辆)、Autos de Colección(收藏车)、Náutica(船舶)以及Colectivos y Autobuses(巴士和客车)。每个车型条目包括生产年份范围和车身类型;在细粒度文件中,每一行对应一个命名版本/配置。数据集由Arcade Motors MX(一个墨西哥免费车辆买卖分类广告市场)整理和维护,用于支持其网站的分类→品牌→车型→版本级联搜索和列表表单。数据集包含两个CSV文件:mx_vehicle_catalog.csv(每行一个命名版本)和mx_vehicle_models.csv(每行一个车型,版本信息合并在一列中)。字段包括类别标识、类别名称、品牌、车型、车身类型、生产起始年份、生产结束年份、版本/配置(或版本列表)以及版本数量(仅车型文件)。该数据集旨在用于车辆分类、级联表单自动完成、列表归一化以及墨西哥汽车市场的覆盖率分析,但不包含定价、里程或卖家数据。数据是基于公开车辆命名法编译的事实参考结构,而非从市场抓取。数据集采用CC-BY-4.0许可证发布。
Mexico Vehicle Catalog Reference dataset is a structured reference taxonomy covering vehicle information sold or commonly available in the Mexican market. This dataset contains 112 brands, 3,011 model entries, and 8,380 named versions/configurations, distributed across 8 top-level vehicle categories: Autos y Camionetas (Cars and Pickup Trucks), Motos (Motorcycles), Vehículos Pesados (Heavy Vehicles), Camiones (Trucks), Otros Vehículos (Other Vehicles), Autos de Colección (Classic Cars), Náutica (Marine Vessels), and Colectivos y Autobuses (Buses and Coaches). Each model entry includes its production year range and body type; in the fine-grained file, each row corresponds to one named version/configuration. The dataset was compiled and maintained by Arcade Motors MX, a Mexican free vehicle classifieds marketplace, and is used to support its website's category→brand→model→version cascading search and listing forms. The dataset includes two CSV files: mx_vehicle_catalog.csv (one named version per row) and mx_vehicle_models.csv (one model per row, with version information consolidated in one column). Fields include category ID, category name, brand, model, body type, production start year, production end year, version/configuration (or version list), and version count (only present in the model file). This dataset is intended for use cases including vehicle classification, cascading form autocomplete, listing normalization, and coverage analysis of the Mexican automotive market, but does not include pricing, mileage, or seller data. The data is a factual reference structure compiled based on public vehicle nomenclature, rather than scraped from the market. The dataset is released under the CC-BY-4.0 license.
数据集概述
Mexico Vehicle Catalog Reference 是一个面向墨西哥汽车市场的结构化参考分类数据集,涵盖车辆品牌、型号和配置级别(trim/version)的层级关系。
核心统计
- 112 个品牌
- 3,011 个车型条目
- 8,380 个具名配置/版本
- 8 个顶级车辆类别:Autos y Camionetas, Motos, Vehículos Pesados, Camiones, Otros Vehículos, Autos de Colección, Náutica, Colectivos y Autobuses
数据文件
| 文件 | 行数 | 说明 |
|---|---|---|
data/mx_vehicle_catalog.csv |
8,380 | 每行对应一个具名配置/版本 |
data/mx_vehicle_models.csv |
3,011 | 每行对应一个车型,配置以单列合并 |
字段说明
- category_slug / category:8个顶级车辆类别之一
- brand:制造商(例如 "Acura"、"Honda")
- model:车型名称(例如 "TLX")
- body_type:车身类型(例如 "sedan"、"suv"、"pickup")
- year_start / year_end:该车型世代的生产年份范围
- trim(版本文件)/trims(车型文件):具名配置/版本,例如 "TLX 3.5 V6"、"TLX Advance"
- trim_count(仅车型文件):该车型下的配置数量
数据用途
作为车辆分类、级联表单自动补全、列表规范化以及墨西哥汽车市场覆盖分析的参考/查询分类数据。不包含定价、里程或卖家信息,并非价格或销售数据集。
数据来源与许可
数据编译为事实性参考结构(品牌/车型/配置/年份范围/车身类型),非从任何市场抓取;数值反映所标注年份的公开车辆命名惯例。许可协议为 CC-BY-4.0,复用需注明出处。