
hsila/bookcorpus-wikipedia
收藏官方服务:
资源简介:
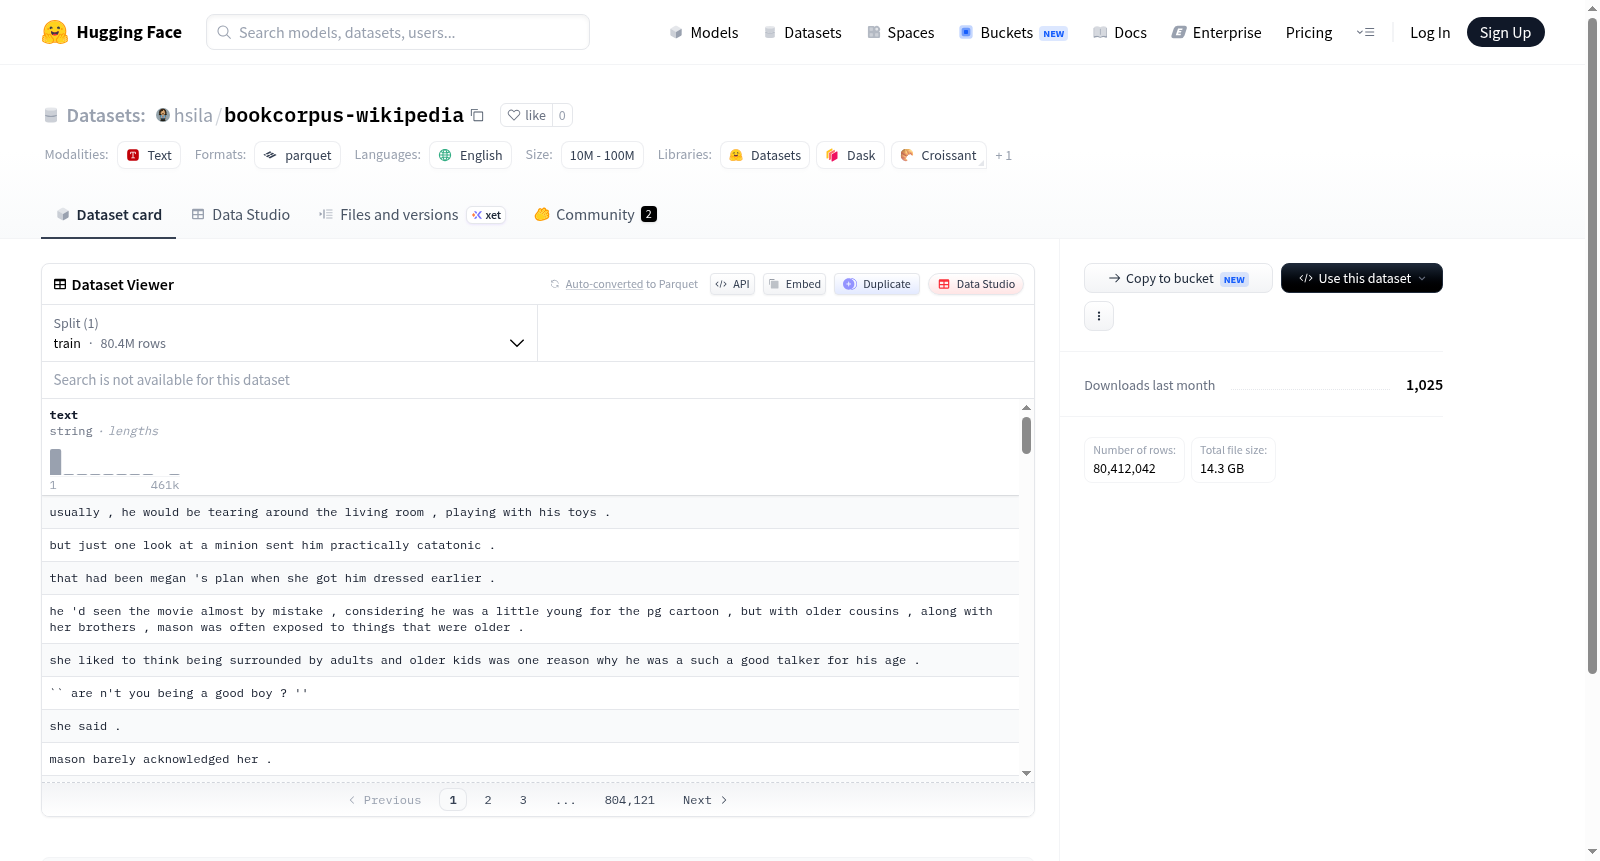
该数据集是一个英语文本数据集,包含一个名为text的字符串类型字段。数据集包含一个训练分割,大小为24428554677字节,包含80412042个示例。数据集的下载大小为14348255275字节,总大小为24428554677字节。
This dataset is an English text dataset containing a string-type field named text. The dataset includes a training split with a size of 24428554677 bytes, containing 80412042 examples. The download size of the dataset is 14348255275 bytes, and the total dataset size is 24428554677 bytes.
提供机构:
hsila搜集汇总
数据集介绍
构建方式
在自然语言处理领域,大规模文本语料库是预训练语言模型的基础。hsila/bookcorpus-wikipedia数据集通过整合两个广受欢迎的英文文本来源——BookCorpus与Wikipedia——构建而成。BookCorpus包含大量未受版权保护的电子书籍,覆盖小说、非虚构等多种体裁;Wikipedia则提供经过社区审核的高质量百科条目。数据集以纯文本格式存储,仅保留'text'字段,去除了元数据与结构标记,从而形成统一、简洁的语料。其训练集包含约8041万条样本,总数据量达24.4 GB,兼顾了文学性与知识性。
特点
该数据集的核心特点在于其规模宏大且内容多元。通过融合书籍的叙事语言与百科的说明性文本,语料在风格上实现了从故事叙述到事实陈述的广泛覆盖。这种多样性有助于语言模型学习更丰富的语义表示与语境适应性。同时,数据集仅保留原始文本,避免了标注偏差与格式干扰,为自监督学习提供了纯净的训练材料。其压缩后的下载大小约为14.3 GB,便于高效传输与存储。
使用方法
该数据集主要用于预训练或微调英文语言模型,如GPT、BERT等架构。用户可直接通过HuggingFace的datasets库加载,指定配置名称'default'与训练集划分'train',并利用通配符路径'data/train-*'读取分片文件。在训练过程中,建议对文本进行分词、截断或填充等预处理,以适应具体模型的要求。此外,由于数据集不包含验证或测试划分,用户需自行划分或与其他数据集组合使用,以完成下游任务的评估。
背景与挑战
背景概述
在大规模语言模型预训练的浪潮中,高质量、多样化的文本语料库成为推动模型性能提升的关键基石。hsila/bookcorpus-wikipedia数据集由研究团队整合BookCorpus与英文维基百科两大经典资源构建而成,其创建时间可追溯至大规模预训练范式兴起的早期阶段。该数据集汇集了约8000万条文本样本,总规模超过24GB,旨在为语言模型提供涵盖小说、百科知识等多领域的长文本训练素材。作为连接叙事性文学与结构化知识的桥梁,它深刻影响了BERT、GPT等里程碑式模型的训练过程,成为自然语言处理领域理解语义连贯性与知识整合能力的重要基准。
当前挑战
该数据集面临的核心挑战首先在于领域偏倚问题——BookCorpus中大量未出版小说与维基百科的正式文体形成鲜明对比,导致模型在特定风格文本上过度拟合,削弱了跨领域泛化能力。其次,构建过程中遭遇数据清洗难题:原始文本包含HTML标签、非标准标点及编码错误,需耗费大量计算资源进行规则过滤与去重。此外,维基百科的实时更新特性使得数据集存在时效性滞后,而BookCorpus的版权争议更引发了对数据合法性的持续质疑。最终,样本不均衡现象显著——小说类长文本与百科短条目在序列长度分布上差异悬殊,为模型训练中的批次处理与注意力机制优化带来额外复杂度。
常用场景
经典使用场景
在自然语言处理领域,大规模无监督预训练语料库是驱动语言模型发展的核心基石。hsila/bookcorpus-wikipedia 数据集融合了BookCorpus的书籍文本与Wikipedia的百科知识,构成了一个涵盖文学叙事与事实性信息的双语域语料。其最经典的使用场景是用于训练自回归语言模型,如GPT系列,通过预测下一个词的任务使模型习得句法结构、语义关联与长距离依赖关系。该数据集凭借其海量且多样化的文本,成为预训练阶段不可或缺的数据来源,为后续微调任务奠定了坚实的知识基础。
解决学术问题
该数据集有效解决了学术研究中通用语言模型预训练数据稀缺且分布单一的问题。此前,研究者常受限于小规模或领域偏窄的语料,导致模型泛化能力不足。hsila/bookcorpus-wikipedia 通过整合书籍的叙事流畅性与百科的严谨逻辑,构建了兼具文学性与事实性的高质量文本集合。它不仅为训练大规模Transformer模型提供了充足的训练样本,还缓解了数据噪声与偏见问题,推动了语言模型在零样本学习、少样本推理及跨任务泛化等方向的研究突破,显著提升了模型在多种自然语言理解基准上的表现。
衍生相关工作
该数据集催生了众多经典研究工作,其中最具代表性的是OpenAI的GPT-2和GPT-3系列模型,它们直接采用BookCorpus与Wikipedia的混合语料进行预训练,证明了大规模数据对语言生成能力的决定性影响。此外,Google的BERT模型虽使用Wikipedia与BooksCorpus,但其掩码语言建模任务设计也受此数据分布启发。后续研究如RoBERTa通过优化训练策略与数据使用量,进一步挖掘了该数据集的潜力;而GPT-Neo和BLOOM等开源项目则借鉴其构建思路,以类似的数据方案推动了大语言模型民主化进程。
以上内容由遇见数据集搜集并总结生成


