FHIBE
收藏资源简介:
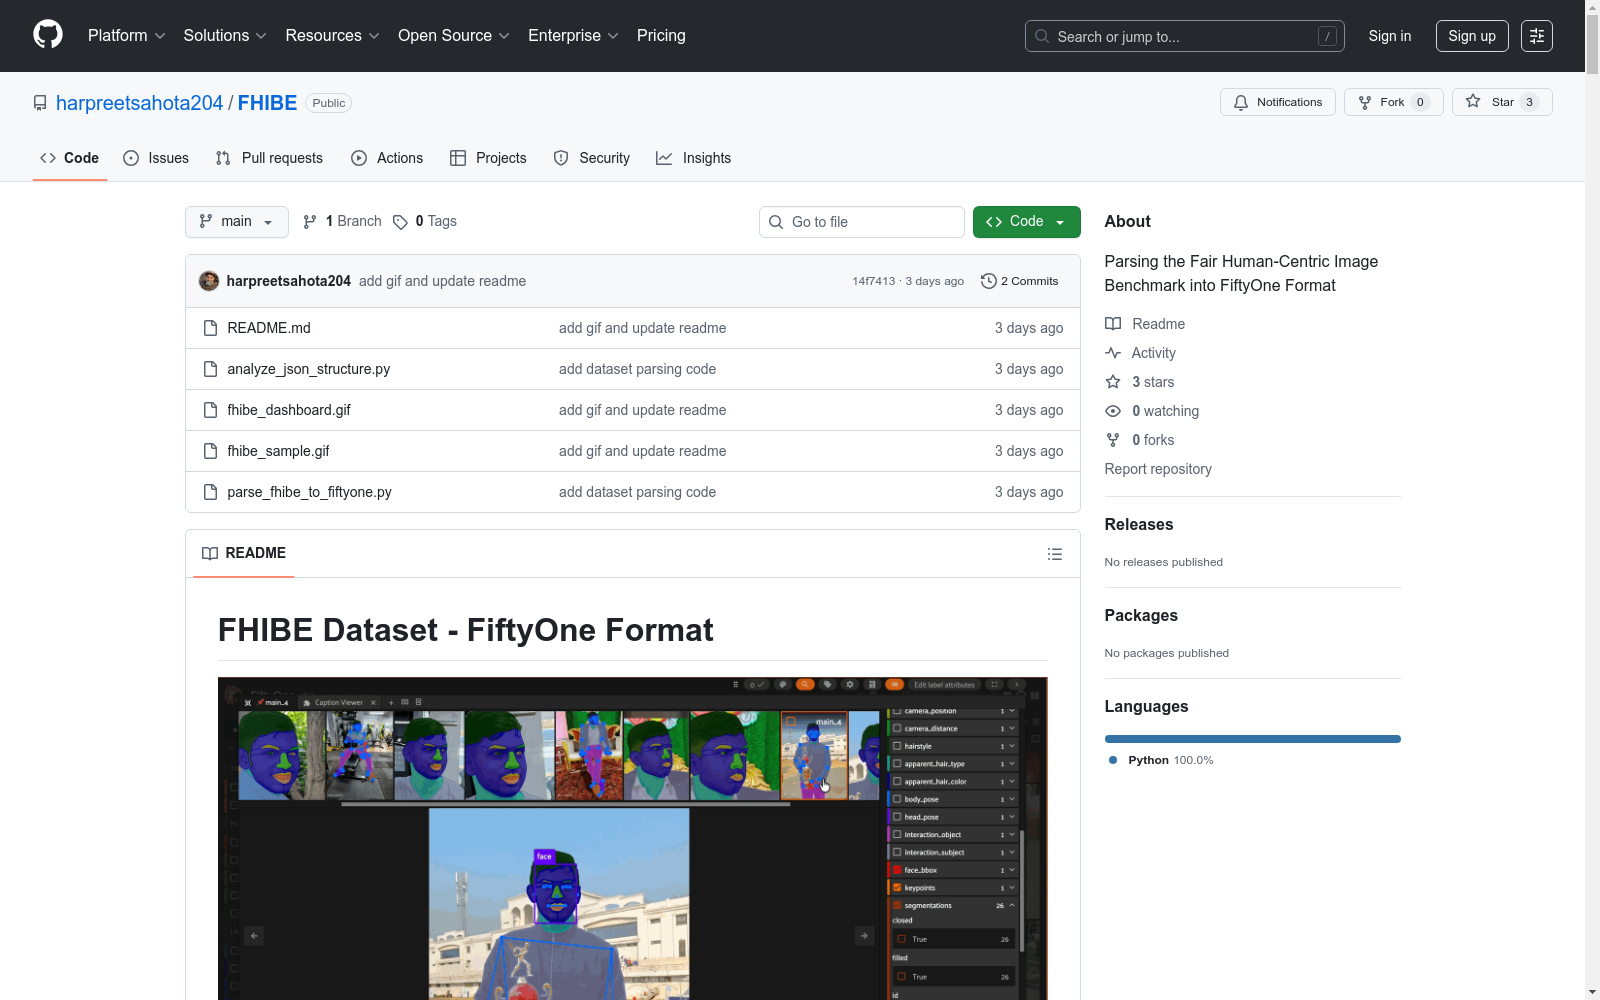
FHIBE(人类身份偏见评估公平性)数据集是一个基于同意的基准数据集,专门用于评估计算机视觉AI系统的公平性。与传统优先考虑规模和性能指标的数据集不同,FHIBE将人类尊严、同意和数据权利置于核心位置。该数据集包含同意参与者的高质量图像,具有全面的注释,包括面部关键点、分割、人口统计信息和上下文元数据。每个参与者都提供了知情同意并保留对其数据的所有权,可以随时撤回。
The FHIBE (Fairness in Human Identity Bias Evaluation) dataset is a consent-based benchmark dataset specifically designed to evaluate the fairness of computer vision AI systems. Unlike traditional datasets that prioritize scale and performance metrics, FHIBE places human dignity, consent, and data rights at its core. This dataset contains high-quality images from consenting participants, with comprehensive annotations including facial landmarks, segmentation masks, demographic information, and contextual metadata. Each participant has provided informed consent and retains full ownership of their data, with the right to withdraw at any time.
FHIBE数据集概述
数据集基本信息
数据集描述
FHIBE(Fairness in Human Identity Bias Evaluation)是一个以同意为驱动的基准数据集,专门用于评估计算机视觉AI系统的公平性。该数据集将人类尊严、同意和数据权利置于核心位置,包含同意参与者的高质量图像,具有全面的注释信息。
核心特征
- 策划方: Sony AI
- 语言: 多语言(注释为英语)
- 许可证: 需要注册并同意使用条款
- 论文: https://ai.sony/blog/Introducing-FHIBE-A-Consent-Driven-Benchmark-for-AI-Fairness-Evaluation/
数据集获取与使用
注册与下载
- 注册下载地址: https://fairnessbenchmark.ai.sony/register
相关资源
- 博客文章:
- https://ai.sony/blog/What-If-Fairness-Started-at-the-Dataset-Level/
- https://ai.sony/blog/The-FHIBE-Team-Data-Dignity-and-the-People-Who-Made-It-Possible/
- https://ai.sony/blog/Introducing-FHIBE-A-Consent-Driven-Benchmark-for-AI-Fairness-Evaluation/
数据集结构
样本组织
数据集采用FiftyOne的分组样本结构,每个受试者具有多种图像类型:
图像类型
main_*: 全身或上半身图像,包含完整注释face_crop_*: 裁剪的面部区域face_aligned_*: 对齐和裁剪的面部图像
字段结构
身份与组织
subject_id:每个参与者的唯一标识符image_id:每个捕获会话的唯一标识符slice_name:图像类型subject_group:链接相关图像的FiftyOne组
人口统计信息
age:参与者年龄pronouns:自我认同的代词ancestry:地理血统nationality:国籍skin_color:自然肤色(RGB值)hair_type:自然发型分类hair_color:自然发色分类eye_color_left:左眼色分类eye_color_right:右眼色分类facial_hairstyle:面部胡须样式分类facial_hair_color:面部胡须颜色分类facial_marks:面部标记或特征分类
外观特征
hairstyle:当前发型apparent_hair_type:图像中表现的发型apparent_hair_color:图像中表现的发色
姿态与动作
body_pose:身体位置分类head_pose:头部方向分类interaction_object:对象交互分类interaction_subject:主体间交互分类
捕获上下文
capture_date:捕获日期capture_time:一天中的时间location_country:捕获国家location_region:捕获地区/州scene:场景类型分类lighting:光照条件分类weather:天气条件分类camera_position:相机相对于受试者的位置camera_distance:距离类别manufacturer:相机制造商camera_model:相机型号
注释信息
face_bbox:面部边界框(检测)keypoints:33点身体关键点(关键点)与骨架segmentations:面部和身体部位分割(多边形)
关键点模式
数据集包含33个关键点,遵循标准顺序,不可见或被遮挡的关键点使用NaN坐标标记。
数据集创建
策划理念
FHIBE旨在解决AI公平性评估中的基本问题:
- 以同意为先的方法
- 公平性评估重点
- 数据尊严
- 全面代表性
数据来源
- 知情同意: 所有参与者提供明确的知情同意
- 数据所有权: 参与者保留数据所有权,可随时撤回
- 专业收集: 由专业摄影师在不同地点拍摄
- 质量控制: 多轮注释质量保证
- 隐私保护: 严格遵循隐私协议
注释过程
- 关键点: 33点身体姿态注释,含可见性标志
- 分割: 面部和身体部位分割多边形
- 边界框: 面部检测框
- 人口统计: 自我报告的人口统计信息
- 上下文: 图像捕获元数据
使用范围
直接用途
- 计算机视觉模型的公平性评估
- 面部识别、关键点检测和分割系统中的偏差检测
- 跨不同人口统计组的模型性能基准测试
- 道德AI开发和基于同意的数据收集方法研究
超出范围用途
- 监视或跟踪
- 商业面部识别
- 未经授权的用途
- 重新识别
局限性
- 范围: 无法全面代表所有人群
- 上下文: 受控条件下捕获的图像可能无法反映所有真实场景
- 注释主观性: 某些注释涉及主观判断
- 时间性: 数据集代表时间快照
- 同意-规模权衡: 优先考虑同意和数据尊严可能限制数据集规模