epadb
收藏资源简介:
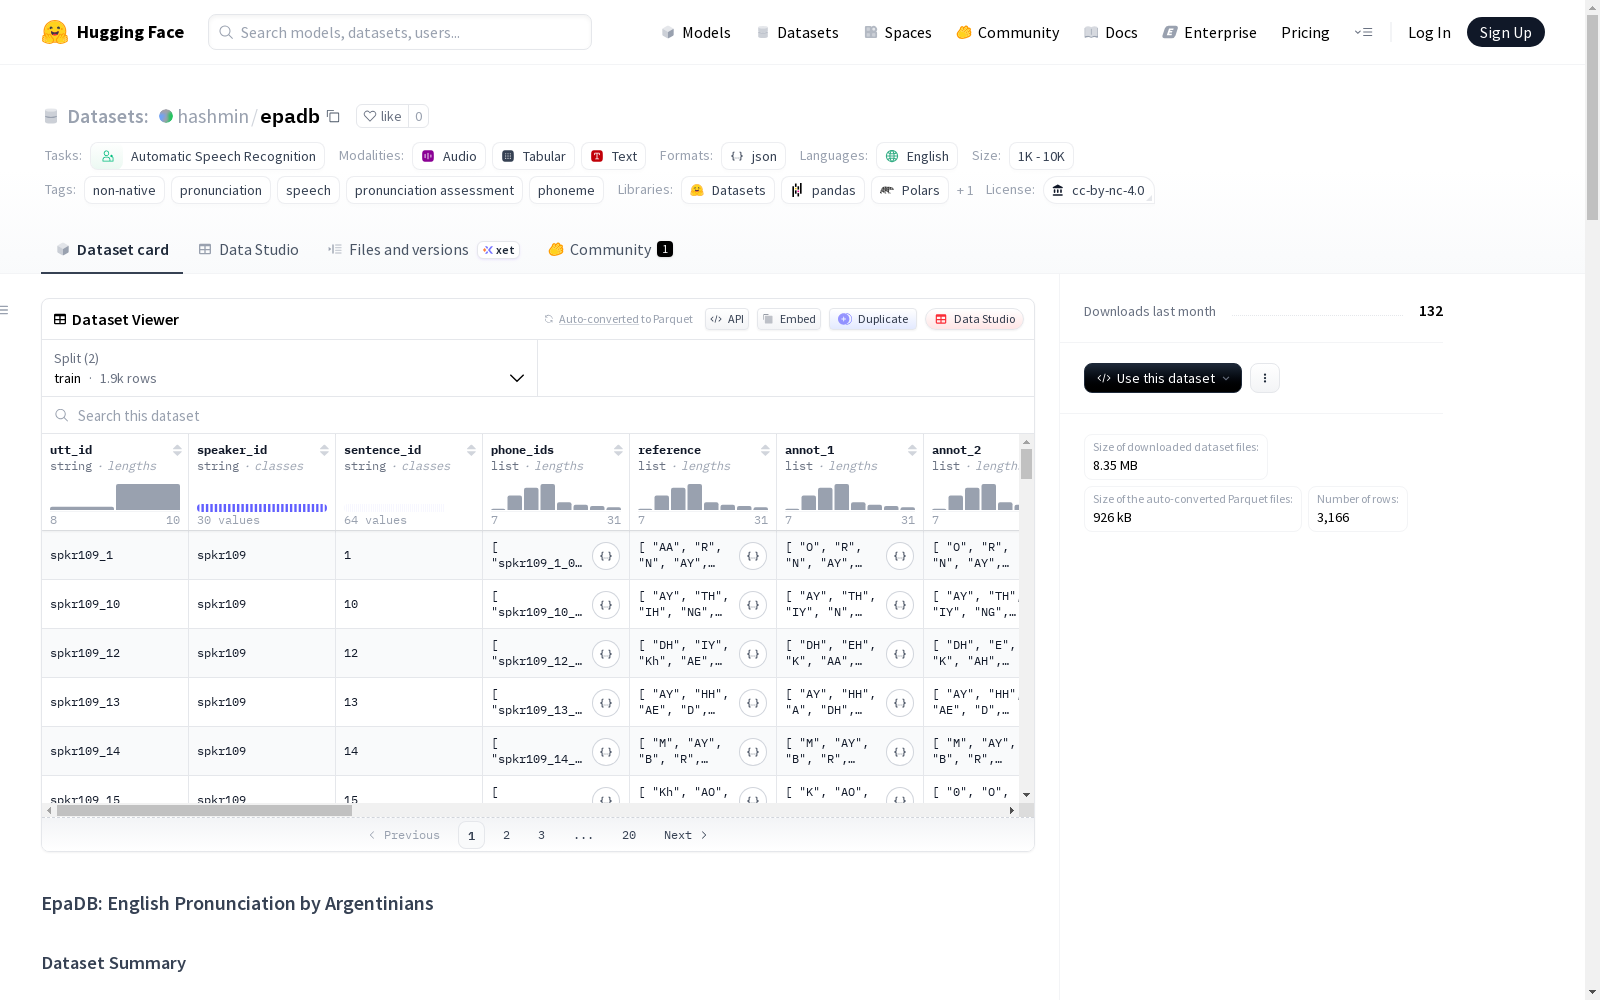
EpaDB是一个用于发音评分研究的语音数据库,包含50名阿根廷西班牙语使用者(25名男性和25名女性)朗读英语短语的录音,总计约3.5小时的语音数据。每个说话者录制了64个短句,这些短句包含对该人群来说难以发音的音素。数据集支持发音评估、音素识别、音素级错误检测和对齐分析等任务。数据集的每个条目都是一个JSON格式的语音片段描述,包含音素序列、音素级标签、时间戳、全局评分、说话者元数据、音频元数据和参考文本转录等信息。数据集分为训练集和测试集,分别包含1,903和1,263个例子。数据集的许可为CC BY-NC 4.0,允许非商业用途并需署名。
EpaDB is a speech database designed for pronunciation scoring research. It contains recordings of English phrases read by 50 Argentine Spanish speakers (25 males and 25 females), with a total of approximately 3.5 hours of speech data. Each speaker recorded 64 short sentences that include phonemes which are challenging for this population to pronounce. This dataset supports tasks including pronunciation assessment, phoneme recognition, phoneme-level error detection, and alignment analysis. Each entry in the dataset is a JSON-formatted speech segment description, containing information such as phoneme sequences, phoneme-level labels, timestamps, global scores, speaker metadata, audio metadata, and reference text transcriptions. The dataset is split into training and test sets, with 1,903 and 1,263 examples respectively. The dataset is licensed under CC BY-NC 4.0, allowing non-commercial use with proper attribution.
EpaDB 数据集概述
数据集简介
EpaDB 是一个用于发音评分研究的语音数据库。该语料库包含 50 名阿根廷西班牙语使用者(25 名男性和 25 名女性)朗读英语短语的录音。每位说话者录制了 64 个包含该人群难以发音的语音的短句,总计约 3.5 小时的语音。
支持任务
- 发音评估 – 预测话语级别的全局分数或音素级别的正确/错误。
- 音素识别 – 预测音素序列。
- 音素级错误检测 – 将每个音素分类为插入、删除、扭曲、替换或正确。
- 对齐分析 – 利用 MFA 时间戳研究强制对齐质量或优化发音模型。
语言
- L2 话语:英语
- 说话者 L1:西班牙语
数据集结构
数据实例
每个 JSON 条目描述一个话语:
- 参考转录 (
reference) 和标注者 (annot_1, 可选的annot_2) 的音素序列。 - 音素级标签 (
label_1,label_2) 和派生的error_type类别。 - 每个音素的 MFA 开始/结束时间戳 (
start_mfa,end_mfa)。 - 每个话语的全局分数 (
global_1,global_2) 和派生的说话者水平 (level_1,level_2)。 - 说话者元数据 (
speaker_id,gender)。 - 音频元数据 (
duration,sample_rate,wav_path) 以及波形本身。 - 参考句子的正字法转录 (
transcription)。
数据字段
| 字段 | 类型 | 描述 |
|---|---|---|
utt_id |
string | 唯一话语标识符(例如 spkr28_1)。 |
speaker_id |
string | 说话者标识符。 |
sentence_id |
string | 参考句子 ID(匹配 reference_transcriptions.txt)。 |
phone_ids |
sequence[string] | 每个话语的唯一音素标识符。 |
reference |
sequence[string] | 参考音素,旨在匹配说话者最接近的目标发音。 |
annot_1 |
sequence[string] | 标注者 1 的音素(- 标记删除)。 |
annot_2 |
sequence[string] | 标注者 3 的音素(如果可用),否则为空。 |
label_1 |
sequence[string] | 标注者 1 的音素标签("1" 正确,"0" 错误)。 |
label_2 |
sequence[string] | 标注者 3 的音素标签(如果存在)。 |
error_type |
sequence[string] | 派生类别:correct, insertion, deletion, distortion, substitution。 |
start_mfa |
sequence[float] | 音素开始时间(秒)。 |
end_mfa |
sequence[float] | 音素结束时间(秒)。 |
global_1 |
float or null | 标注者 1 的话语级别分数(1–4)。 |
global_2 |
float or null | 标注者 3 的分数(如果可用)。 |
level_1 |
string or null | 来自标注者 1 的说话者水平熟练度等级("A"/"B")。 |
level_2 |
string or null | 来自标注者 3 的说话者等级。 |
gender |
string or null | 说话者性别("M"/"F")。 |
duration |
float | 话语持续时间(秒)(重采样至 16 kHz 后)。 |
sample_rate |
int | 采样率(Hz)(16,000)。 |
wav_path |
string | 波形文件名(<utt_id>.wav)。 |
audio |
Audio | 自动加载的波形(16 kHz)。 |
transcription |
string or null | 参考句子文本。 |
数据划分
| 划分 | 示例数量 |
|---|---|
| 训练集 | 1,903 |
| 测试集 | 1,263 |
注意事项
- 当标注者 3 未标注某个话语时,相关字段(
annot_2,label_2,global_2,level_2)不存在或设置为 null。 - 错误类型来自对比 MFA 参考音素与标注者 1 标签的简单启发式方法。
- 波形在清单生成期间使用
ffmpeg重采样至 16 kHz。 - 强制对齐和注释被合并以生成每个说话者/分区的丰富 CSV 文件。
- 全局分数按说话者平均以派生
level_*等级(如果平均值 ≥ 3 则为A,否则为B)。
许可信息
- 音频和注释:CC BY-NC 4.0(允许非商业用途,需署名)。
引用格式
@article{vidal2019epadb, title = {EpaDB: a database for development of pronunciation assessment systems}, author = {Vidal, Jazmin and Ferrer, Luciana and Brambilla, Leonardo}, journal = {Proc. Interspeech}, pages = {589--593}, year = {2019} }
使用方式
安装依赖并加载数据集: python from datasets import load_dataset
上传前的本地使用:
ds = load_dataset( "epadb_dataset/epadb.py", data_dir="/path/to/epadb", # 包含 train.json, test.json, WAV/ 的文件夹 split="train", ) print(ds) print(ds[0]["utt_id"], ds[0]["audio"]["sampling_rate"]) # 16000
推送到 Hugging Face Hub 后:
ds = load_dataset("JazminVidal/epadb", split="train")
致谢
该数据库是布宜诺斯艾利斯大学应用人工智能实验室语音实验室的努力成果,并部分由 Google 通过 2018 年 Google 拉丁美洲研究奖资助。