
NbAiLab/nb-asr-numerics-balanced-disfluent2
收藏官方服务:
资源简介:
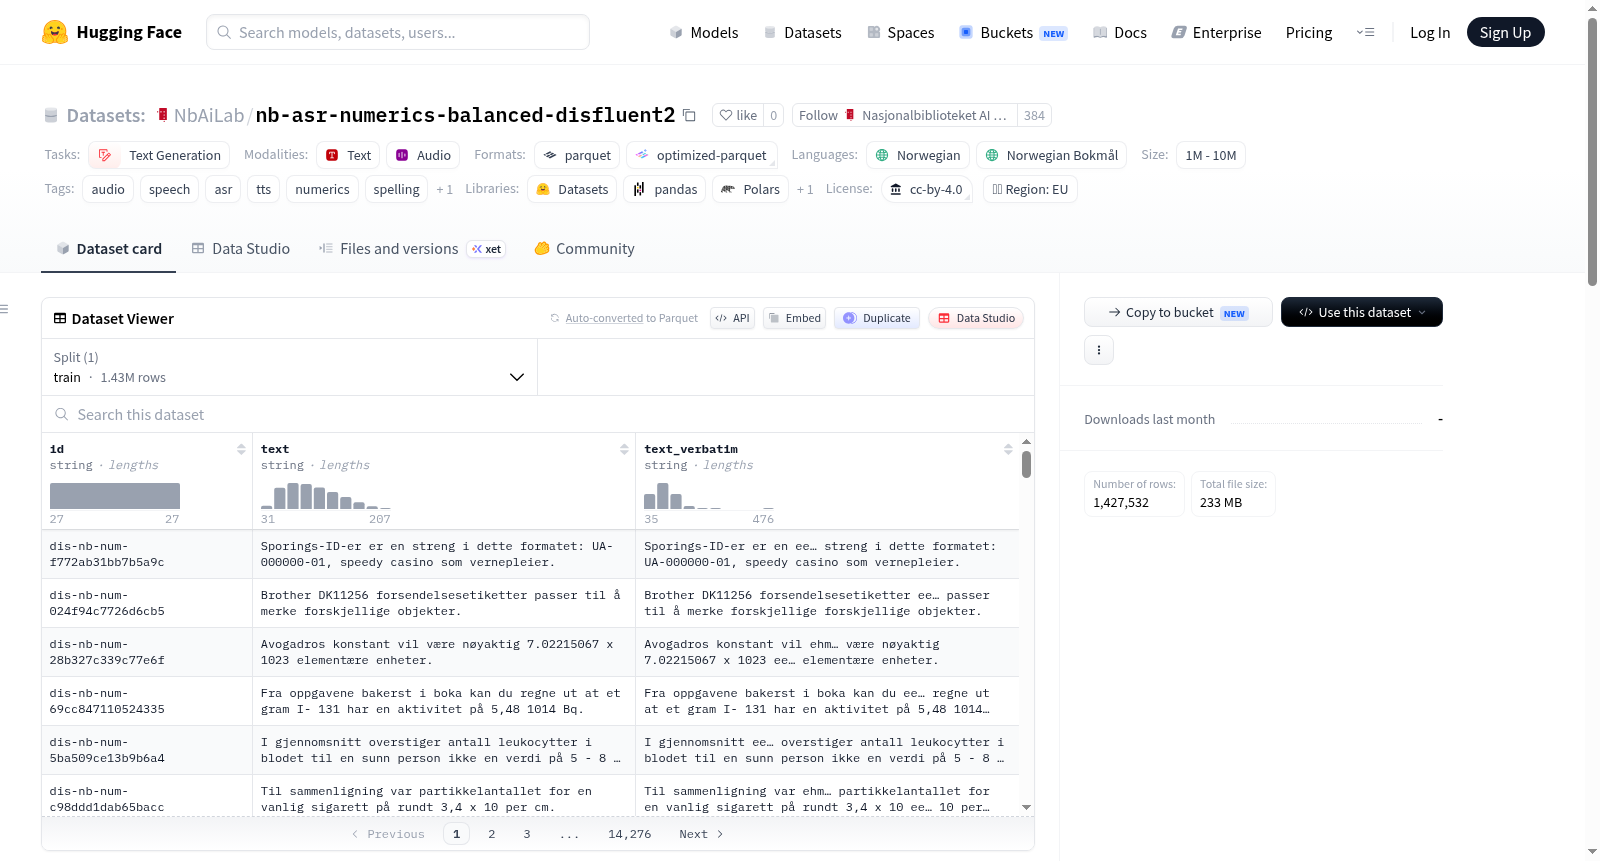
该数据集包含1,500,000个带有数字和自然不流畅元素(如填充词和单词重复)的平衡句子,专为鲁棒的声学和语音模型训练而准备。数据集被简化为仅包含干净的、经过验证的输入和目标逐字不流畅文本。
This dataset consists of 1,500,000 balanced sentences that incorporate numerals and natural disfluencies such as filled pauses and word repetitions, and is specifically designed for training robust acoustic and speech models. The dataset has been simplified to exclusively include clean, validated inputs and verbatim disfluent target texts.
提供机构:
NbAiLab搜集汇总
数据集介绍
构建方式
本数据集基于挪威语数字语音识别领域,旨在提升模型对自然口语中数字表达与不流利现象的鲁棒性。构建过程始于从'pere/nb-asr-numerics-categorized'中筛选并平衡包含稀有类别与高数字密度的句子,形成150万条初始语料。随后,通过成对交换策略对文本列中的数字进行映射(如4与5互换),以阻止模型在联合训练时记忆特定数字与上下文的组合。不流利现象的生成依托于'google/gemma-4-12B-it'模型,在H200集群上通过vLLM框架执行,模型被指令插入自然停顿(如'ee…')及单词或短语的重复。每一条生成文本均经守门验证:去除不流利标记后须与原句的独特词汇及词序完全一致,验证失败则重试最多三次,最终保障了数据的高精度。
使用方法
该数据集适用于训练与评估挪威语自动语音识别(ASR)及文本转语音(TTS)模型。使用时,可直接加载包含'text'(数字交换后的干净句子)与'text_verbatim'(含不流利现象的标准文本)两列的HuggingFace数据集。对于ASR任务,可将语音音频与'text_verbatim'对齐,以训练模型识别包含口语间断的语音;对于TTS任务,则可利用'text'生成流畅语音,或利用'text_verbatim'模拟自然不流畅的发音。通过与此类非不流利数据集联合训练,模型能提升对数字及口语化表达的鲁棒性。数据加载可通过datasets库的load_dataset函数直接进行,数据集规模适中(1M-10M),便于在主流深度学习框架中使用。
背景与挑战
背景概述
在自动语音识别(ASR)与文本转语音(TTS)系统中,数字序列的准确识别与自然口语中非流利现象(如填充词、重复词)的处理是提升模型鲁棒性的关键瓶颈。为此,挪威语ASR数字拼写平衡非流利数据集2(Norwegian ASR Numeric Spelling Balanced Disfluent 2)于近期由相关研究团队构建并发布,该数据集包含150万条经过平衡处理的句子,专注于数字及自然非流利现象的建模。其核心研究问题在于,通过引入受控的非流利表达和数字交换策略,防止模型对特定数字-上下文组合的过度记忆,从而提升声学与语言模型在真实口语场景下的泛化能力。依托H200集群上的大语言模型生成与严格验证流程,该数据集为挪威语ASR领域的鲁棒性训练提供了高质量、高精度的基准资源,对推动低资源语言在数字密集型口语任务中的研究具有显著影响。
当前挑战
当前数据集面临多重挑战。在领域问题层面,真实口语场景中数字序列常伴随填充词(如“ee…”“ehm…”)和词重复等非流利现象,传统ASR模型对此类变体极为敏感,导致识别准确率大幅下降,而现有数据集往往缺乏对数字与非流利现象耦合建模的覆盖。在构建过程中,挑战尤为突出:首先,需从大规模分类数据集中筛选并平衡包含稀有类别和高数字密度的句子,确保统计代表性;其次,采用配对交换策略(如4↔5、6↔7)改变数字分布以防范模型记忆,但需同时保持时间、日期等结构合理性,设计复杂;最后,利用大语言模型生成自然非流利表达后,必须通过精确的验证门控确保生成文本的语义与原句完全对齐,且对失败样本进行最多3次重试,否则予以丢弃,最终成功率为95.17%,这一过程对计算资源与算法精度提出了极高要求。
常用场景
经典使用场景
在语音识别与自然语言处理交叉领域中,针对含数字拼写和自然口误(如填充词与词汇重复)的挪威语博克马尔文语料匮乏的困境,该数据集作为精准模拟真实口语中数字表达与不流畅现象的标杆资源应运而生。其最经典的使用场景聚焦于鲁棒性声学模型与语言模型的联合训练,具体而言,研究者可利用其高密度数字分布与人工验证的忠实口误标注,训练模型在嘈杂或非正式口语环境下准确识别含数字的复杂语句。通过数字对调策略与口误生成管线的精巧设计,该数据集为评估模型对格式转换与自然语音变体(如犹豫声“ee…”、“ehm…”及短词重复)的泛化能力提供了标准化测试平台,有力推动了挪威语语音助手、听写系统及教育工具在真实场景下的性能跃升。
解决学术问题
该数据集从根源上解决了低资源语种中数字密集口语语料的系统性缺失问题,尤其填补了挪威语博克马尔文在含填充词与重复结构时数字识别鲁棒性研究的空白。学术层面,它通过对1.5百万条平衡语句实施创新的数字对调映射(如4与5、6与7等成对互换)——既保留时钟、日期等语义合理性,又强行切断模型对特定数字与上下文组合的死记硬背——迫使模型学习真正语义关联而非统计捷径。同时,其基于大语言模型(Gemma-4-12B-it)生成并辅以三重重试验证的口误引入流程,保障了每条样本均能通过唯一词序列重构性检验,为探究口误与数字共现时的声学-语言特征交互机制提供了无干扰的理想实验材料。这对揭示人类语音不流畅现象的本质规律、提升口语理解系统的语用鲁棒性具有奠基性意义。
实际应用
在实际场景中,该数据集直接赋能构建面向挪威语用户的智能语音接口,例如在车载导航系统中精准解析包含门牌号、限速值等数字的口语指令,或帮助医疗转录系统处理医生对话中频繁出现的剂量与时间数字及犹豫重复。其精心设计的数字对调机制使得基于该数据训练的模型天然拒绝对静态组合的迷信,因而在高变异性的电话客服、同声传译与多方言语音搜索等应用中展现出卓越的泛化能力。对于教育技术领域,该数据还可用于开发针对语言学习者的口语流畅度评估工具,通过自动检测填充词和数字重复模式,提供个性化纠正反馈。此外,因保持分钟数字≤59、日期数字1–31的结构限制,该语料可直接用于校准智能家居设备的时钟播报与日历理解模块,显著降低口误引发的误操作风险。
数据集最近研究
最新研究方向
该数据集聚焦于挪威语自动语音识别(ASR)与文本生成任务中的数字表征与口吃不流利现象建模,通过构建包含150万条平衡句子的语料库,创新性地采用数字配对交换策略(如4↔5)防止模型记忆特定数字-上下文组合,并利用大语言模型(Gemma-4)生成带有自然填充词(如ee…、ehm…)和单词重复的流畅性破坏文本,经严格逆向验证确保语义完整性。这一方向与当前语音界面中处理真实口语缺陷的热点需求紧密相关,尤其在鲁棒性声学模型训练中,其平衡的数字分类分布与高密度数字语义设计,为提升ASR系统在数字密集型场景(如电话号码、时间读数)下的抗干扰能力提供了关键数据支撑,对北欧多语言语音交互技术的落地具有重要推动作用。
以上内容由遇见数据集搜集并总结生成


