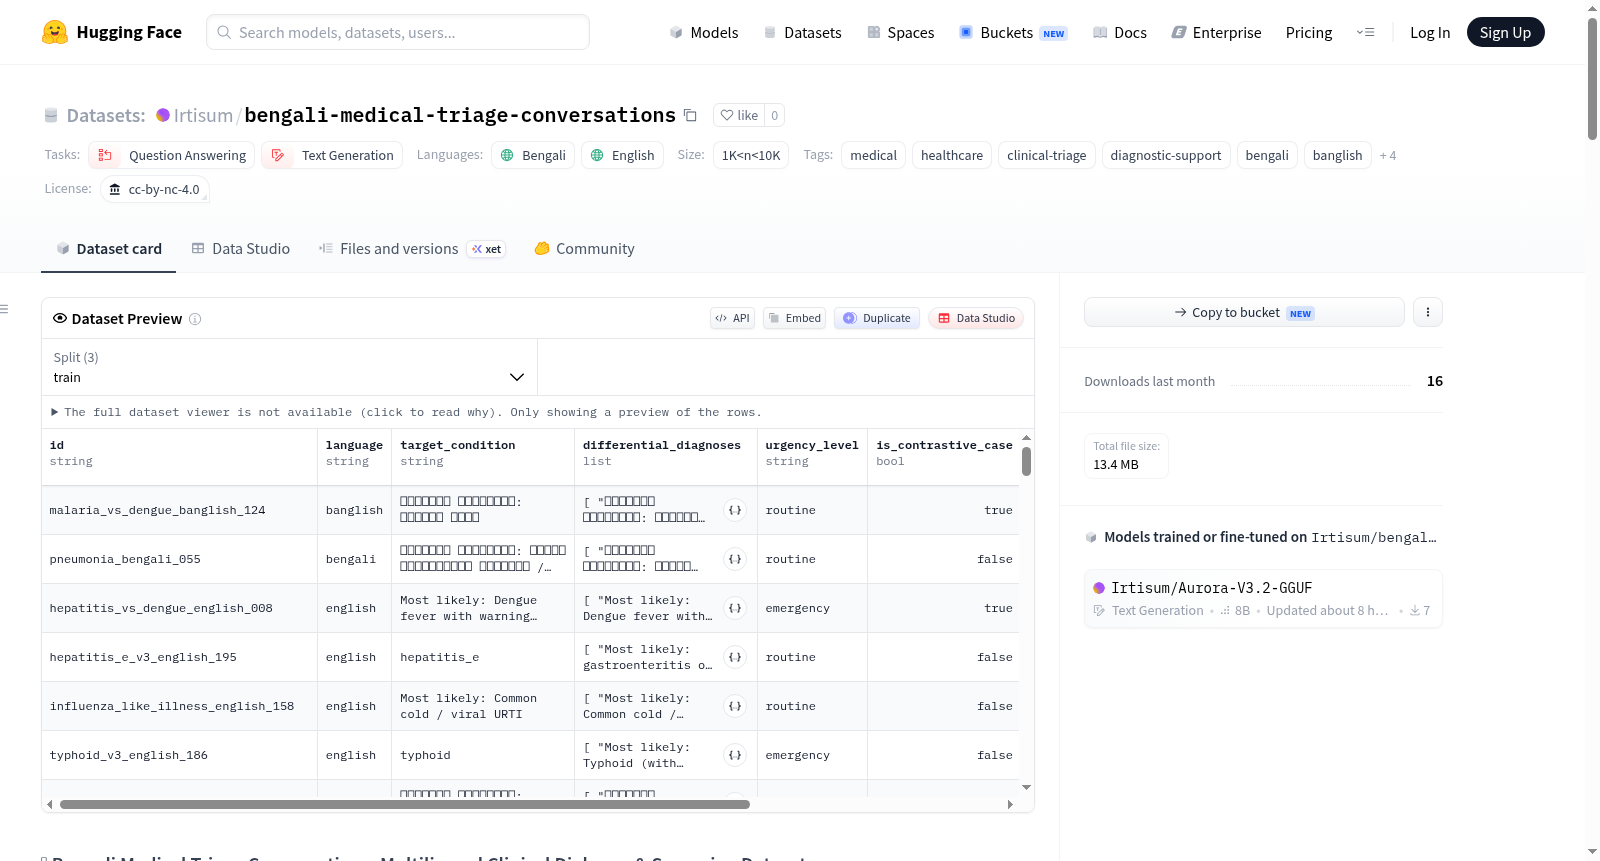
bengali-medical-triage-conversations
收藏资源简介:
孟加拉语医疗分诊对话数据集(Bengali Medical Triage Conversations)是一个经过医学审核的多轮临床对话数据集,专为在孟加拉语(বাংলা)、Banglish(孟加拉语罗马化拼音)和英语中微调和评估医疗保健AI助手及诊断分诊代理而设计。该数据集主要针对孟加拉国和南亚地区常见的急性热带、感染性和初级保健表现。数据集包含2774个对话,分为训练集(2452个)、验证集(272个)和测试集(50个)。每个对话包含多轮医患交互,助手每轮提出一个相关的鉴别性问题,最终给出三个鉴别诊断的排名评估。数据涵盖10种疾病:疟疾、登革热、基孔肯雅病、伤寒、戊型肝炎、普通感冒/病毒性上呼吸道感染、流感样疾病、尿路感染、社区获得性肺炎、急性腹泻和胃肠炎。数据集包含750多个硬负对比对(如登革热 vs 病毒性发热),以防止诊断过度。字段包括id、language、target_condition、differential_diagnoses、urgency_level、is_contrastive_case、contrast_pair、turns和messages。数据集通过多模型前沿集成合成、过滤和交叉验证,并经过基于规则的自动过滤和临床文献(WHO、CDC、Harrisons Principles of Internal Medicine)的交叉验证。数据集仅供学术研究使用,严禁用于直接临床管理。
Bengali Medical Triage Conversations is a medically reviewed multi-turn clinical dialogue dataset designed for fine-tuning and evaluating healthcare AI assistants and diagnostic triage agents in Bengali (বাংলা), Banglish (Romanized Bengali), and English. The dataset primarily targets acute tropical, infectious, and primary care presentations common in Bangladesh and South Asia. It contains 2774 dialogues, split into training (2452), validation (272), and test (50) sets. Each dialogue includes multiple rounds of doctor-patient interaction, where the assistant asks relevant differential questions and finally provides a ranked assessment of three differential diagnoses. The data covers 10 diseases: malaria, dengue, chikungunya, typhoid, hepatitis E, common cold/viral upper respiratory tract infection, influenza-like illness, urinary tract infection, community-acquired pneumonia, acute diarrhea and gastroenteritis. The dataset includes over 750 hard negative contrast pairs (e.g., dengue vs viral fever) to prevent over-diagnosis. Fields include id, language, target_condition, differential_diagnoses, urgency_level, is_contrastive_case, contrast_pair, turns, and messages. The dataset was synthesized, filtered, and cross-validated through multi-model frontier ensemble methods, and underwent rule-based automated filtering and cross-validation with clinical literature (WHO, CDC, Harrisons Principles of Internal Medicine). The dataset is for academic research only and strictly prohibited for direct clinical management.
孟加拉语医疗分诊对话数据集(Bengali Medical Triage Conversations)
数据集概述
- 名称:Bengali-Medical-Triage-Conversations
- 用途:面向医疗保健AI助手与诊断分诊智能体的多轮临床对话数据集,支持模型微调与评估
- 覆盖语言:孟加拉语(বাংলা)、孟加拉语音译罗马字(Banglish)、英语
- 地域针对性:孟加拉国及南亚地区常见的急性热带病、传染病及初级医疗场景
- 许可证:Creative Commons Attribution-NonCommercial 4.0 International (CC BY-NC 4.0)
数据集规模与划分
| 划分 | 对话数量 | 说明 |
|---|---|---|
| train | 2,452 | 多轮训练对话(10种核心疾病+5组对比对照包) |
| validation | 272 | 分层验证集 |
| test(基准) | 50 | 经临床整理的评估案例,含金标准目标与危险信号评分标准 |
| 总计 | 2,774 | 全部经审核、零缺陷对话 |
数据集特性
- 多语言脚本路由:根据用户输入语言(孟加拉语、Banglish、英语)自动匹配相应语言的助手回复
- 临床结构化病史采集:每轮提出1个相关鉴别性问题(共2–4轮),最后输出排名前三的鉴别诊断
- 硬负样本对比对:包含750余例对比集合(如登革热vs病毒性发热、疟疾vs登革热等),防止过度诊断
- 零处方安全协议:严格禁止药物处方、任意剂量或未经验证的家庭疗法;自动升级处理急诊危险体征(休克、严重出血、脱水、呼吸窘迫)
覆盖疾病(10种急性热带与感染性疾病)
- 疟疾(恶性疟原虫/间日疟原虫)
- 登革热(含警示征象/DHF筛查)
- 基孔肯雅热
- 伤寒(肠沙门菌Typhi血清型)
- 戊型肝炎(肠道急性病毒性肝炎)
- 普通感冒/病毒性上呼吸道感染
- 流感样疾病(ILI)
- 尿路感染(急性膀胱炎与肾盂肾炎)
- 社区获得性肺炎(CAP)
- 急性腹泻与胃肠炎
数据字段(Schema)
- id(字符串)
- language(字符串)
- target_condition(字符串)
- differential_diagnoses(字符串序列)
- urgency_level(字符串)
- is_contrastive_case(布尔值)
- contrast_pair(字符串)
- turns(整数)
- messages(列表:role + content)
数据合成与质控流程
- 多模型集成生成:GPT 5.6 Sol(临床轨迹生成)、Claude 4.8 Opus(多轮临床推理与脚本路由验证)、Kimi k3(对比边缘案例合成与事实一致性审计)
- 质量控制:
- 基于规则的自动过滤(强制轮次数量、脚本路由约束、处方药物和任意百分比分数的正则化剔除)
- 临床文献交叉对照:症状、潜伏期、危险信号和鉴别诊断均依据WHO、CDC及《哈里森内科学原理》标准审核
临床验证依据
- WHO:疟疾指南(2023)、登革热综合指南(SEARO)、基孔肯雅热临床管理、急性腹泻管理、IMCI肺炎指南
- CDC:Yellow Book及传染病临床指南
- 标准医学文献:《哈里森内科学原理》(第21版)、《牛津临床医学手册》(第10版)、NICE临床知识摘要
使用与加载
python from datasets import load_dataset
dataset = load_dataset("Irtisum/bengali-medical-triage-conversations")
伦理与安全声明
该数据集仅供学术研究、医学NLP基准测试及临床对话AI微调使用。并非医疗设备,不提供确定性医学诊断,未经合格医疗人员监督不得用于直接临床管理。